
本文通过对于常见面试题的整理归纳,回顾Web开发中的各种方面知识点。
Java基础篇
Java基础
JVM、JDK 和 JRE 联系与区别?
JVM(Java虚拟机)是运行Java字节码的虚拟机,JVM针对于不同的操作系统有不同的实现(Windows,Linux,Mac os),在不同的操作系统上使用相同的字节码文件可以得到相同的结果。
Java程序从源代码到运行一般经历下面3个步骤:
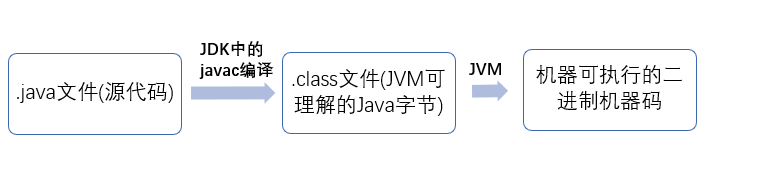
JDK(Java Development Kit)是功能齐全的Java SDK,它不止有JRE,还有编译器(Javac)和工具(例如Java doc 和Jdb),它可以创建和编译程序。
JRE是Java运行时环境,它是运行已经编译的Java程序所需的内容的集合,包括Java虚拟机、Java类库、Java命令和其他的一些基础构件,但是,它不能用来创建新的程序。
构造器 Constructor 是否可被 override?
构造器无法被重写,但可以重载。
重载和重写的区别?
重载发生在同一个类中,方法名必须相同,参数类型、个数、顺序不同,方法返回值和修饰值可以不同。
面向对象编程三⼤特性: 封装 继承 多态
封装
封装是把一个对象的属性私有化,根据需要提供一些可以被外界访问属性的方法
继承
继承是使用已经存在的类的定义作为基础建立新的类,新类的定义可以增加新的数据或功能,也可以使用父类的功能,子类拥有父类所有的属性和方法(包括私有属性和私有方法),但是父类中的私有属性和方法子类是无法访问的,子类可以拥有自己的属性和方法,即子类可以对父类进行扩展,子类也可以重写父类的方法。
多态
多态是值程序中定义的引用变量所指向的具体类型和通过该引用变量发出的方法调用在编程时并不确定,而是在程序运行期间才确定,即一个引用变量到底会指向哪个类的实例对象,该引用变量发出的方法调用到底是哪个类中实现的方法,必须是在程序运行期间才能决定。
String StringBuffer 和 StringBuilder 的区别是什么?
- String:不可变字符序列
- StringBuffer:可变字符序列,效率低,线程安全
- StringBuilder:可变字符序列,效率高,线程不安全
String类为什么是不可变的?
在Java中,String被设计成一个不可变的类,也就是常量对象,理由如下:
String常量池需要
JVM为了提升性能和减少内存开销,设计了字符串常量池,字符串不可变的特性就是其设计基础。
缓存Hashcode
可以将Hash值存储起来,不用每次都计算,会给String作为key的数据结构,例如HashMap、HashTable等带来性能提升。
安全
可以防止通过反射机制等有意或者恶意修改,从而预防安全问题。
线程安全
不可变的对象意味着天生就是线程安全的,可以被多个线程共享。
缺点:对于字符串拼接操作会带来极大的性能消耗,这种情况可以使用StringBuffer、StringBuilder来替代String。
Integer的缓存机制?
Integer 是对小数据(-128到127)是有缓存的,在JVM初始化的时候,数据-128到127之间的数字便被缓存到了本地内存中,如果初始化-128到127之间的数字,会直接从内存中取出,不需要新建一个对象。
深拷贝和浅拷贝的区别?
浅拷贝:对于基本数据类型进行值传递,对引用数据类型进行引用传递般的拷贝;
深拷贝:对基本数据类型进行值传递,对引用数据类型,创建一个新的对象,并复制其内容,此为深拷贝。
接口和抽象类的区别
- 接口的方法默认都是public,所有的方法在接口中不能有实现;
- 接口中除了static、final变量,不能有其他变量,而抽象类中则不一定;
- 一个类可以实现多个接口,但只能实现一个抽象类。但接口本身可以多继承。
- 接口方法的默认修饰符是public,抽象类的方法的修复可以是public、protected和default这些修饰符(不能是private);
- 从设计的层面来说,抽象是对类的抽象,是一种模板设计,而接口是对行为的抽象,是一种行为的规范。
以上对JDK8之前的定义和规范,从JDK8开始接口的概念有了一些变化,在JDK7或更早的版本中,接口里面只能由常量、变量和抽象方法,实现接口类必须重写接口中的抽象方法,JDK8接口中增加了默认方法和静态方法,JDK9接口中增加了私有方法和私有静态方法。
构造方法有哪些特性?
- 名称与类名相同
- 没有返回值,但不能用void声明构造方法
- 生成类的对象时自动执行,无需调用
- 默认有一个不带参数的构造方法
- 如果显式的指定了带参的构造方法,默认不再提供无参的构造方法
总的来说构造方法与普通方法的区别如下:
| Java构造函数 | Java方法 |
|---|---|
| 构造器用于初始化对象的状态(状态) | 方法用于暴露对象的行为 |
| 构造函数不能有返回类型 | 方法一般都有返回类型 |
| 构造函数隐式调用 | 方法要显式的调用 |
| 如果没有指定任何构造函数,java编译器提供一个默认的构造函数 | 在任何情况下编译器都不会提供默认的方法调用 |
| 构造函数名称必须与类名称相同 | 方法名称可以或可以不与类名称相同 |
String中hashCode的实现?
    public int hashCode() {
        int h = hash;
        if (h == 0 && value.length > 0) {
            char val[] = value;

            for (int i = 0; i < value.length; i++) {
                h = 31 * h + val[i];
            }
            hash = h;
        }
        return h;
    }
hashCode和equals的作用?
两个相同对象
JDK8有哪些新特性?
- Lambda表达式
- 函数式接口
- 方法引用
- Stream API
- 接口中的默认方法和静态
- 新的时间和日期API
- Optional
Java反射有哪些作用?
Java的反射机制主要用于实现以下功能:
- 在运行时判断任意一个对象所属的类型
- 在运行时构造任意一个类的对象
- 在运行判断任意一个类所具有的成员变量和方法
- 在运行时调用任意一个对象的方法,包括private方法
如何使用反射获取私有属性?
// 1.获取私有属性
Field[] fields = clz.getDeclaredFields();
// 2.获取私有构造方法
Constructor cons = clazz.getDeclaredConstructor(null);
// 必须要设置之后才可以访问
cons.setAccessible(true);
cons.newInstance(null);
创建对象有哪些方式?
共有五种方式:
- new关键字
- 反射API
- Constructor.newInstance
- Clone()方法
- 反序列化
迭代器和for循环遍历的区别?
迭代器是一种设计模式,可以使得序列类型的数据结构的遍历行为与被遍历的对象分离,即我们无需关心该序列的底层结构是什么样子的。只要拿到这个对象,使用迭代器可以遍历这个对象的内部。
迭代器实现了Iterabale接口的集合都可以使用迭代器来遍历。使用迭代器遍历元素时,除了查看之外,只能做remove操作。
增强for循环,内部使用的是迭代器,所以它的操作对象是数组和可以迭代器的结合。遍历时只能查看,无法修改、删除、增加。
迭代出来的元素都是原来集合元素的拷贝,Java集合元素实质是对象的引用,而非对象本身,迭代出的对象也是引用的拷贝,结果还是引用。那么如果集合中保存的元素是可变类型的,那么可以通过迭代出的元素修改原集合中的对象
总的来说,两者的区别主要在于遍历和集合本身是否分离,从数据结构的角度分析,如果使用Iterator来遍历集合的元素,并不需要考虑集合类的内部实现(只要),而如果使用for循环进行遍历,那么遍历此集合的算法都得做相应的调整。
过滤器和拦截器的区别?
- 过滤器指的是,在java web中,传入的request、response提前过滤一些信息,或者提前设置一些参数,然后传入servlet或者struts的action进行业务逻辑,比如过滤掉非法url。
- 拦截器指的是,是在面向切面编程的时候,使用动态代理拦截方法等。
Java集合
List、Set、Map三者的区别?
List用来存储一组不唯一(可以重复),有序的对象;
Set用来存储不允许重复的集合,不会有多个元素引用相同集合的对象;
Map是用来存储键值对的,Map会维护与Key有关联的值,两个不同的Key可以引用相同的对象,Key不能重复。
HashMap实现原理?
Java 8系列之重新认识HashMap - 美团技术团队 (meituan.com)
HashMap为什么扩容为2倍?
HashMap为了存取高效,要尽量较少碰撞,就是要尽量把数据分配均匀,每个链表长度大致相同,使用的算法是:hash & (length - 1),实际上hash & (length - 1) = hash % length,主要考虑到模运算的速度比位运算的的快。
为什么HashMap不用LinkedList,而是选用数组?
在HashMap中,定位桶的位置是利用元素的key的哈希值对数组长度取模得到,此时已知桶的位置,使用数组查询的效率会LinkedList大;不使用ArrayList的原因是,ArrayList的扩容机制是1.5倍扩容,无法自定义扩容机制。
JDK1.8对HashMap有哪些优化?
- 由数组 + 链表的结构改为了数组 + 链表 + 红黑树
- 优化了高位运算的hash算法:
h^(h >>> 16) - 扩容后,元素要么是在原来的位置,要么是在原位置再移动2次幂的位置,且链表顺序不变
为什么不直接使用红黑树,而是选择先用链表,再转红黑树?
因为红黑树需要进行左旋、右旋、变色这些操作来保持平衡,而单链表不需要,当元素小于8个的时候,此时做查询操作,链表结构已经能保证查询性能,当元素大于8个的时候,此时需要红黑树来加速查询速度,但是新增节点的效率变慢了,因此,如果一开始就用红黑树结构,元素太少,新增效率又比较慢,无疑这是浪费性能的。
HashMap不使用红黑树,而是使用二叉查找树可以吗?
可以,但是二叉查找树在特殊情况下会变成一条线性结构,此时遍历查找会非常慢。
为什么阈值是8?
hashcode碰撞次数与泊松分布有关,选择8是根据概率统计而选择的。泊松分布的示意图:
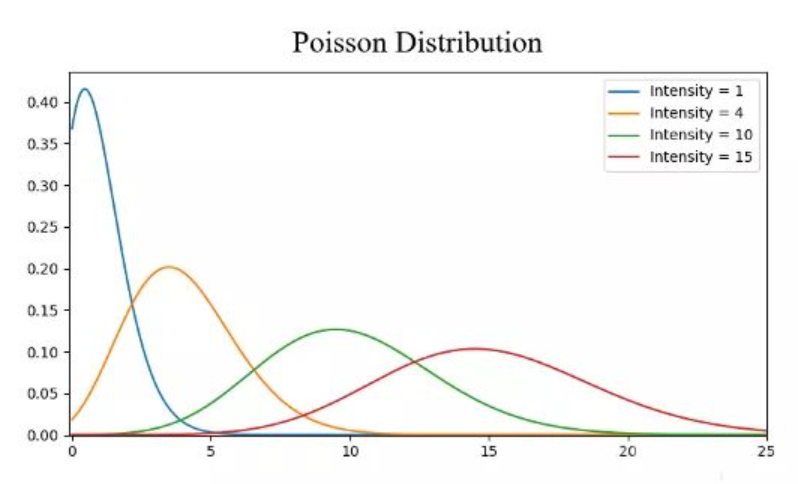
当链表转为红黑树,什么时候退化为链表?
等于6的时候退转为链表。中间有差值7可以防止链表和树之间频繁的转换。假设这个互相转换的界限都是8,那么如果一个HashMap不停的插入、删除元素,链表个数会在8左右徘徊,就会频繁的发生树转链表、链表转树,效率会很低。
HashMap在并发编程环境下有什么问题?
- 多线程扩容,引起的死循环问题
- 多线程put的时候可能导致元素丢失
- put非null元素后get出来的却是null
使用可变类当HashMap的key有什么问题?
hashCode可能发生改变,导致put进去的值,无法get出,如下所示:
public class HashMapDemo {
    public static void main(String[] args) {
        HashMap<List<String>, Object> changeMap = new HashMap<>();
        List<String> list = new ArrayList<>();
        list.add("hello");
        Object objectValue = new Object();
        changeMap.put(list, objectValue);
        System.out.println(changeMap.get(list));
        //hashcode发生了改变
        list.add("hello world");
        System.out.println(changeMap.get(list));
    }
}
如何实现一个自定义的Class作为HashMap的key?
- 重写hashcode和equals
- 如何设计一个不可变类
两个相同对象没有重写equals方法放到HashMap覆盖吗?
不会覆盖,HashMap使用对象的hashCode方法确定对象在哈希表中的存储位置,并使用equals方法来比较key是否相等,如果对象不重写equals方法,将对象放到HashMap的时候就会调用Object的equals方法,比较地址,这时候就会认为是两个不同的对象,所以不会覆盖。
HashSet实现原理?
底层使用HashMap实现:
// hashMap的value是Object类型
private transient HashMap<E,Object> map;
private static final Object PRESENT = new Object();

// HashSet添加元素的方法
public boolean add(E e) {
    return map.put(e, PRESENT)==null;
}
// HashSet删除元素的方法
public boolean remove(Object o) {
    return map.remove(o)==PRESENT;
}
CurrentHashMap的实现原理?
JDK1.7分段锁的设计,JDK1.8:Node + CAS + Synchronized
ArrayList的实现原理?
ArrayList底层使用一个支持自动扩容的数组来保存所有元素。ArrayList并不是线程安全的,只能在单线程环境下使用,多线程环境下可以使用java.util.Collections.SynchronizedList或java.util.concurrent.CopyOnWriteArrayList来代替。
Java并发
并发编程的三要素?
线程安全性的问题主要体现在:
- 原子性
- 有序性
- 可见性
出现线程安全问题的原因:
- 线程切换带来的原子性问题
- 缓存导致的可见性问题
- 编译优化带来的有序性问题
解决办法:
- JDK Atomic开头的原子类、synchronized、Lock可以解决原子性的问题
- synchronized、volatile、Lock可以解决可见性的问题
- Happers-before规则可以解决有序性的问题
线程和进程的区别?
进程是程序运行时的状态,是操作系统分配资源的最小单元,进程的主要作用是管理资源。线程是操作系统调度的最小的单元,一个程序至少有一个进程,一个进程至少有一个线程,线程是进程当中的一条执行流程。
守护线程和用户线程的区别?
Java中的线程分为两种:守护线程(Daemon)和用户线程(User),其中用户线程又称本地线程。守护线程可以理解为JVM自动创建的线程(通常),用户线程是程序创建的线程。一般情况下,两者的区别在于,当JVM中所有的线程都是守护线程的时候,JVM就可以退出,如果还有一个或以上的非守护线程则不会退出。
可以通过 java.lang.Thread#setDaemon 方法设置线程为守护线程或者用户线程。
什么是线程安全?
指某个函数、函数库在多线程的环境中被调用时,能够正确地处理多个线程之间的共享变量,使程序功能正确完成。
Java如何开启线程?怎么保证线程安全?
这里首先得明确一下线程和进程的区别,进程是操作系统进行资源分配的最小单位,线程是操作系统任务分配的最小单位,线程隶属于进程。
开启线程的具体方式:
- 继承Thread类,重写run方法
- 实现Runnable接口,实现run方法
- 实现Callable接口,实现call方法,通过FutureTask创建一个线程,获取到线程执行的返回值
- 通过线程池来开启线程
那么如何保证线程安全呢?
采用加锁的方式:使用JVM提供的Synchronized关键字或者JDK提供的各种锁Lock。
线程有哪些状态?
如图:

如何停止一个正在运行的线程?
在java中有以下3种方法可以终止正在运行的线程:
- 使用退出标志,使线程正常退出,也就是当run方法完成后线程终止
- 使用stop方法强行终止,但是这个方法并不安全
- 使用interrupt方法中断线程
notify和notifyAll有什么区别?
notify会随机唤醒一个阻塞的线程,而notifyAll会唤醒所有线程。
wait和sleep方法有什么区别?
调用wait方法之前,线程必须持有对象的锁,在调用wait方法之后,线程就会释放锁,而sleep方法则不会释放掉锁。
为什么wait和notify方法要在同步块中调用?
使用wait和notify方法首先要必须要获取到当前对象的锁,如果没有获取到锁会抛出异常,因此需要在同步块中调用。
Thread类中的yield方法有什么作用?
当一个线程调用yield方法时,当前线程会让出CPU使用权,然后处于就绪状态,线程调度器会从线程就绪队列里面获取一个线程优先级最高的线程,当然也有可能会调度到刚刚让出CPU的那个线程来获取CPU执行权。
volatile和synchronized有什么区别?
synchronized关键是用来加锁,volatile只是保持变量的线程可见性,通常适用于一个线程写,多个线程读的场景。
volatile变量和atomic变量什么不同?
volatile变量可以确保写操作发生在后续的读操作之前,但它并不能保证原子性,例如,即便是使用volatile修饰,count++的操作也不是原子性的,而atomic变量可以让这种操作具有原子性。
interrupted和isInterrupted方法的区别?
interrupted与isInterrupted方法不同是,interrupted方法会清除中断标志,而isInterrupted方法则不会,并且interrupted方法是static方法,可以通过Thread类直接调用。
volatile能不能保证线程安全?
不能。volatile关键字只能保证线程可见性,不能保证原子性,相关的示例:
public class VolatileDemo {
    private static volatile boolean flag = true;

//    private static boolean flag = true;

    public static void main(String[] args) {
        new Thread(() -> {
            while (flag) {
                // ..
            }
            System.out.println("=============");
        }).start();
        try {
            Thread.sleep(100);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
        flag = false;
    }
}
DCL单例为什么加volatile?
volatile防止指令重排,在DCL中,防止高并发情况,指令重排造成的线程安全问题,相关示例代码:
public class SingleDemo {

    private volatile SingleDemo singleDemo;

    private SingleDemo() {}

    public SingleDemo getInstance() {
        if (null == this.singleDemo) {
           synchronized (SingleDemo.class) {
              if (null == this.singleDemo) {
                    singleDemo = new SingleDemo();
                }
            }
        singleDemo = new SingleDemo();
        return singleDemo;
    }
}
死锁与活锁的区别?
死锁:线程1等待线程2互斥持有的资源,而线程2也在等待线程1互斥持有的资源,两个线程都无法继续执行。
活锁:线程持续重试一个总是失败的操作,导致无法继续执行;
死锁与饥饿的区别?
饥饿:线程一直被调度器延迟访问其赖以执行的资源,也许是调度器先于低优先级的线程而执行高优先级的线程,同时总是会有一个高优先级的线程可以执行,饿死也叫做无限延迟。
按照线程安全的强度来区分,分为哪几类?
| 分类 | 特点 |
|---|---|
| 不可变 | 不可变的对象一定是线程安全的,并且永远也不需要额外的同步。Java类库中大多数基本数值类如Integer、String、BigInteger都是不可变的。 |
| 绝对线程安全 | 由类的规格说明所规定的约束在对象被多个线程访问时仍然有效,不管运行时环境如何排列,线程都不需要任何额外的同步。 |
| 相对线程安全 | 相对线程安全类对于单独的操作可以是线程安全的,但是某些操作序列可能需要外部同步。 |
| 线程兼容 | 线程兼容类不是线程安全的,但是可以通过正确使用同步而在并发环境中安全地使用,例如使用sychronized代码块。 |
| 线程对立 | 线程对立是那些不管是否采用了同步措施,都不能在多线程环境中并发使用的代码,这通常是有害的,应当尽量避免。 |
线程安全的实现方法有哪些?
- 互斥同步
- 非阻塞同步
- 无同步方案
- 可重入代码
- 线程本地存储
锁优化技术你了解什么?
锁优化技术主要有锁消除与锁粗化两种。
- 通过逃逸分析技术判别程序中所使用的锁对象是否只被一个线程所使用,而没有散布到其他线程当中,如果情况就是这样的话,那么JIT编译器在编译这个同步代码时就不会生成synchronized关键字所标识的锁的申请与释放机器码,从而消除了锁的使用流程,这就是锁的消除。
- JIT编译器在执行动态编译时,若发现前后相邻的synchronized块使用的是同一个锁对象,那么它就会把这几个synchronized块合并为一个较大的同步块,这就是锁的粗化。
Lock与synchronized有什么区别?
- 锁的获取方式:Lock是通过程序代码的方式由开发者手工获取,而synchronized是通过JVM来获取的(无需开发者干预)。
- 具体的实现方式:Lock是通过Java代码的方式来实现,synchronized是通过JVM底层来实现(无需开发者关注)。
- 锁的释放方式:Lock务必通过unlock()方法在finally块中手工释放,synchronized是通过JVM来释放(无需开发者关注)。
- 锁的具体类型:Lock提供了多种,如公平锁、非公平锁,synchronized与Lock都提供了可重入锁。
什么是阻塞队列?阻塞队列的实现原理是什么?
阻塞队列是一个支持两个附加操作的队列。这两个附加的操作是:
- 当队列为空时,获取元素的线程会等待队列变为非空
- 当队列满时,存储的线程会等待队列可用
阻塞队列一览:
| 类型 | 特点 |
|---|---|
| ArrayBlockingQueue | 一个由数组结构组成的有界阻塞队列 |
| LinkedBlockingQueue | 一个由链表结构组成的有界阻塞队列 |
| PriorityBlockingQueue | 一个支持优先级排序的无界阻塞队列 |
| DelayQueue | 一个使用优先级队列实现的无界阻塞队列 |
| SynchronousQueue | 一个不存储元素的阻塞队列 |
| LinkedTransferQueue | 一个由链表结构组成的无界阻塞队列 |
| LinkedBlockingDeque | 一个由链表结构组成的双向阻塞队列 |
什么是Callable和Future?
Future接口标识异步任务,是还没有完成的任务给出的未来结果,Callable用于产生结果,Future用来获取结果。
Java线程锁机制是怎样的?偏向锁、轻量级锁、重量级锁有什么区别?锁机制是如何升级的?
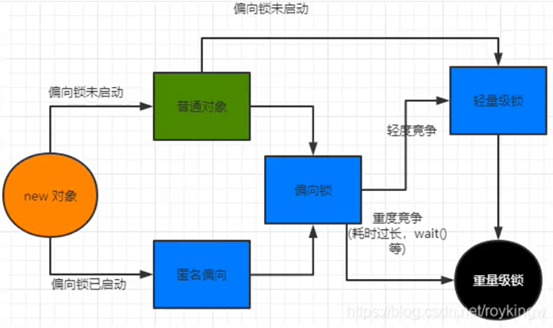
Java的锁就是在对象的MarkWord中记录一个锁状态、无锁、偏向锁、轻量级锁、重量级锁对应不同锁状态,Java的锁机制就是根据资源竞争的激烈程度不断进行锁升级的过程。
偏向锁、轻量级锁、重量级锁及锁机制具体如下图:
什么是可重入锁?有哪些实现?
相同的线程可以直接进入已经获取锁的同步代码块,而无需重复获取锁。代表实现:synchronized、ReentrantLock。
什么是悲观锁?什么是乐观锁?
悲观锁:总是假设最坏的情况,每次获取数据都认为其它线程会修改,所以都会加锁(读锁、写锁、行锁等),当其它线程想要访问数据时,都需要阻塞挂起,例如synchronized。
乐观锁:总是认为不会产生并发问题,每次获取数据的时候总认为不会有其它线程对数据进行修改,因此不会上锁,但是在更新是会判断其它线程在这之前有没有对数据进行修改,一般使用版本号机制或CAS操作实现。
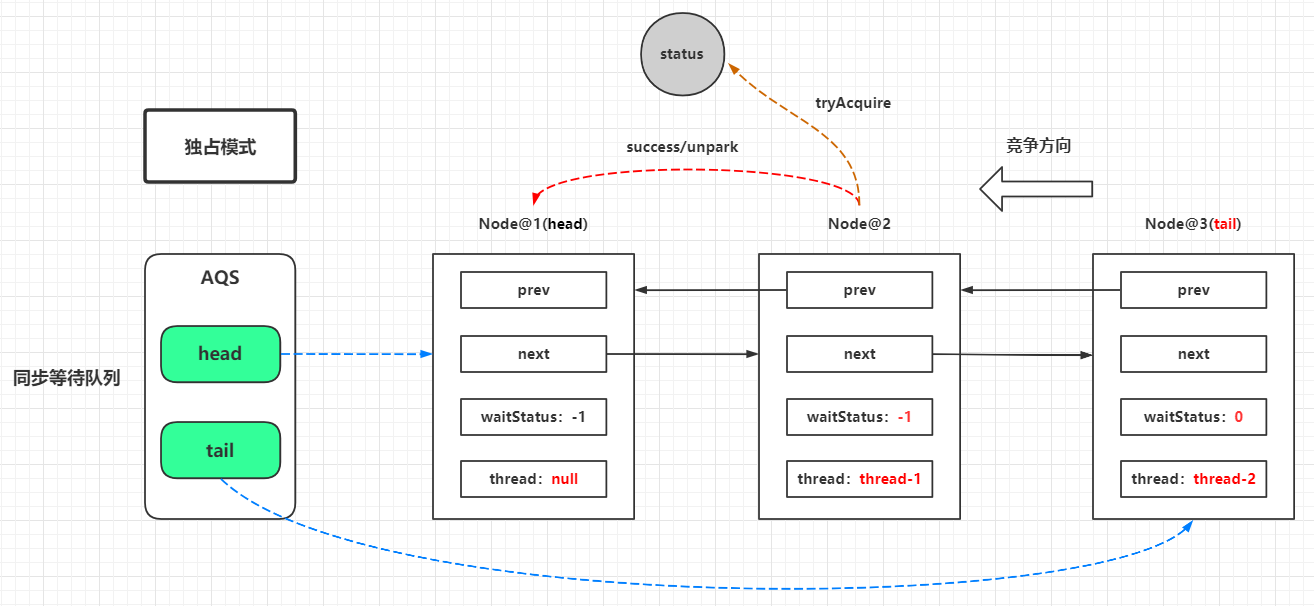
谈谈你对AQS的理解,AQS如何实现可重入锁?
队列同步器AQS,是Lock实现的模板类。它使用一个int类型的成员变量表示同步状态,通过内置的双向链表来完成资源获取的线程的排队工作。AQS使用模板方法的设计模式,使用者需要继承AQS并重写指定的方法(通常是获取锁和释放锁的方法)。随后AQS会调用重写的模板方法,完成对数据的加锁/解锁操作。
SynchronizedMap和ConcurrentHashMap有什么区别?
SynchronizedMap依次锁住整张表来保证线程安全,所以每次只能有一个线程来访问map,而ConcurrentHashMap使用分段锁来保证在多线程下的性能(JDK1.7)。
ConcurrentHashMap的并发度是什么?
默认值是16,这样能在多线程情况下避免争用。
CopyOnWriteArrayList可以用于什么应用场景?
读多写少,并且写入慢也没有关系的场景。本质上是使用ReentrantLock完成并发操作。
有A、B、C三个线程,如何保证三个线程同时执行?如何在并发情况下保证三个线程依次执行?如何保证三个线程有序交错进行?
可以使用三大工具:CountDownLatch,CylicBarrier,Semaphore
- 保证三个线程同时执行的示例:
public class ThreadSafeDemo {

    private int count = 0;

    private void add() {
        count ++;
    }

    public static void main(String[] args) throws InterruptedException {
        int size = 3;
        ThreadSafeDemo threadSafeDemo = new ThreadSafeDemo();

        CountDownLatch countDownLatch = new CountDownLatch(1);

        for (int i = 0; i < size; i++) {
            new Thread(() -> {
                try {
                    countDownLatch.await();
                    System.out.println(System.currentTimeMillis());
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }).start();
        }
        System.out.println("wait");
        Thread.sleep(5000);
        countDownLatch.countDown();
}- 保证三个线程依次执行的示例
public class OrderThread2 {
    static volatile int ticket = 1;

    public static void main(String[] args) {
        Thread t1 = new Thread(() -> {
            while (true) {
                if (ticket == 1) {
                    try {
                        Thread.sleep(100);
                        for (int i = 0; i < 10; i++) {
                            System.out.println("a" + i);
                        }
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }
                    ticket = 2;
                    return;
                }
            }
        });

        Thread t2 = new Thread(() -> {
            while (true) {
                if (ticket == 2) {
                    try {
                        Thread.sleep(100);
                        for (int i = 0; i < 10; i++) {
                            System.out.println("b" + i);
                        }
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }
                    ticket = 3;
                    return;
                }
            }
        });

        Thread t3 = new Thread(() -> {
            while (true) {
                if (ticket == 3) {
                    try {
                        Thread.sleep(100);
                        for (int i = 0; i < 10; i++) {
                            System.out.println("c" + i);
                        }
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }
                    return;
                }
            }
        });

        t1.start();
        t2.start();
        t3.start();
    }
}- 保证三个线程有序交错进行的示例:
public class OrderThread {
    // 利用信号量来限制
    private static Semaphore s1 = new Semaphore(1);
    private static Semaphore s2 = new Semaphore(1);
    private static Semaphore s3 = new Semaphore(1);

    public static void main(String[] args) {
        try {
            s1.acquire();
            s2.acquire();
        } catch (InterruptedException e) {
            e.printStackTrace();
        }

        new Thread(() -> {
            while (true) {
                try {
                    s1.acquire();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                try {
                    Thread.sleep(500);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println("A");
                s2.release();
            }
        }).start();

        new Thread(() -> {
            while (true) {
                try {
                    s2.acquire();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                try {
                    Thread.sleep(500);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println("B");
                s3.release();
            }
        }).start();

        new Thread(() -> {
            while (true) {
                try {
                    s3.acquire();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                try {
                    Thread.sleep(500);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
                System.out.println("C");
                s1.release();
            }
        }).start();
    }
}
什么是指令重排序?
为了使处理器内部的运算单元能尽量被充分利用,处理器可能会对输入的代码进行乱序执行优化,处理器会在计算之后将乱序执行的结果重组,并确保这一结果和顺序执行的结果是一直的,但是这个过程并不保证各个语句计算的先后顺序和输入代码中的顺序一致,简单来说,就是指程序中写的代码,在执行时并不一定按照写的顺序就叫做指令重排序。
Java中的指令重排序有两次,第一次发生在将字节码编译成机器码的阶段,第二次发生在CPU执行的时候,也会适当对指令进行重排。
ThreadLocal的作用?导致内存泄漏的原因是什么?
ThreadLocal可以为每一个线程拷贝变量的副本,让变量“私有化”,导致内存泄漏的主要原因是在内部维护的Map结构,当key被GC之后,value还存在,无法自动进行GC,就会导致内存泄漏。
使用线程池有什么好处?
- 降低资源消耗:通过重复利用已创建的线程降低线程创建和销毁造成的消耗
- 提高响应速度:当任务到达时,可以不需要等待线程创建就能立即执行
- 提高线程的可管理性:线程是稀缺资源,如果无限制的创建,不仅会消耗系统资源,还会降低系统的稳定性,使用线程池可以进行同一的分配,监控和调优
线程池中submit()和execute()方法有什么区别?
execute和submit都属于线程池的方法,两者的区别在于:
- execute只能提交Runnable类型的任务,而submit既能提交Runnable类型的任务也能提交Callable类型任务
- execute会直接抛出任务运行时的异常,submit会吃掉异常,可通过Future的get方法将任务执行时的异常重新抛出
- execute所属顶层接口时Executor,submit所属顶层接口是ExecutorService,实现类ThreadPoolExecutor重写了execute方法,抽象类AbstractExecutorService重写了submit方法
什么是Executors框架?
Executor工具类的不同方法按照我们的需求创建了不同的线程池,来满足业务的需求。
线程池的拒绝策略?
当提交的线程填满核心线程数,并且塞满了队列缓冲区,并且超过了最大线程数时,就会触发拒绝策略,具体有以下几种:
| 拒绝策略 | 含义 |
|---|---|
| AbortPolicy | 当任务添加到线程池中被拒绝时,它将抛出RejectedExecutionException异常 |
| CallerRunsPolicy | 当任务添加到线程池中被拒绝时,会在线程池当前正在运行的Thread线程池中处理被拒绝的任务 |
| DiscardOldestPolicy | 当任务添加到线程池中被拒绝时,线程池会放弃等待队列中最旧的未处理任务,然后将被拒绝的任务添加到等待队列中 |
| DiscardPolicy | 当任务添加到线程池中被拒绝时,线程池将丢弃被拒绝的任务 |
什么时候触发拒绝策略,是三个参数总体协调的结果,当提交的任务大于corePoolSize时,会优化放到队列缓冲区,值由填满了缓冲区之后,才会判断当前任务是否大于maxPoolSize,小于的时候会创建新的线程进行处理,大于时就触发了拒绝策略。简单来说,当前提交任务数大于(maxPoolSize + queueCapacity)时就会触发线程的拒绝策略。
如何获取子线程的执行结果?
- 使用join方法变量传递
- FutureTask
如何对一个字符串快速进行排序?
可以使用Fork/Join框架来完成,相关代码示例:
class Fibonacci extends RecursiveTask<Integer> {
   final int n;
   Fibonacci(int n) { this.n = n; }
   Integer compute() {
     if (n <= 1)
       return n;
     Fibonacci f1 = new Fibonacci(n - 1);
     f1.fork();
     Fibonacci f2 = new Fibonacci(n - 2);
     return f2.compute() + f1.join();
   }
 }
线程池的参数如何设置?
详细参见:Java线程池实现原理及其在美团业务中的实践。
子线程中如何获取父线程的 ThreadLocal 中的值、ThreadLocal 的数据结构?
高并发下,如何保证接口的幂等性?
除了Lock和synchronized,还有什么方式可以保障线程安全?
- 使用Atomic原子类,它通过CAS操作,保障线程安全
- 使用线程安全的集合类,例如ConcurrentHashMap、CopyOnWriteArrayList
- 使用volatile,如果是共享变量引起的线程安全问题,volatile可以共享保障变量的可见性
- 使用ThreadLocal,使得每个线程都可以独立地访问和修改自己的变量副本
- 使用不可变的变量,例如String,使用final关键字修饰的变量等
Java网络通信
TCP和UDP有什么区别?
TCP(Transfer Control Protocol)是一种面向连接的、可靠的、传输层通讯协议。
TCP的特点:类似打电话,面向连接的、点对点的通信、高可靠的,效率比较低,占用的系统资源比较多。
UDP(User Datagram Protocol)是一种无连接的、不可靠的、传输层的通讯协议。
UDP的特点:类似广播,不需要连接,发送方不管接受方有没有准备好,直接发消息,可以进行广播发送的,传输不可靠,有可能丢失消息,效率比较高,协议比较简单,占用的系统资源比较少。
TCP为什么是三次握手,而不是两次?
TCP建立连接三次握手,断开连接四次挥手。 如果是两次握手,可能会造成连接资源浪费的情况,server端会建立通道一直等待连接,但是client端会认为连接失败,放弃本次通信。
Java有哪几种IO模型?有什么区别?
有BIO 同步阻塞IO、NIO 同步非阻塞IO、AIO异步非阻塞IO模型。
这里的同步、异步针对请求,阻塞和非阻塞针对客户端。
在一个网络请求中,客户端会发一个请求到服务端:
客户端发了请求后,就一直等着服务端响应,客户端:阻塞。请求:同步
客户端发了请求后,就去干别的事情了,是不是的过来检查服务端是否给出了响应,客户端:非阻塞,请求:同步
换成异步请求,客户端发了请求后,就坐在椅子上,等着服务端返回响应。客户端:阻塞,请求:异步。
客户端发了请求后,就去干别的事情了,等到服务端给出响应后,再来处理业务逻辑。客户端:非阻塞。请求:异步
具体区别如下:
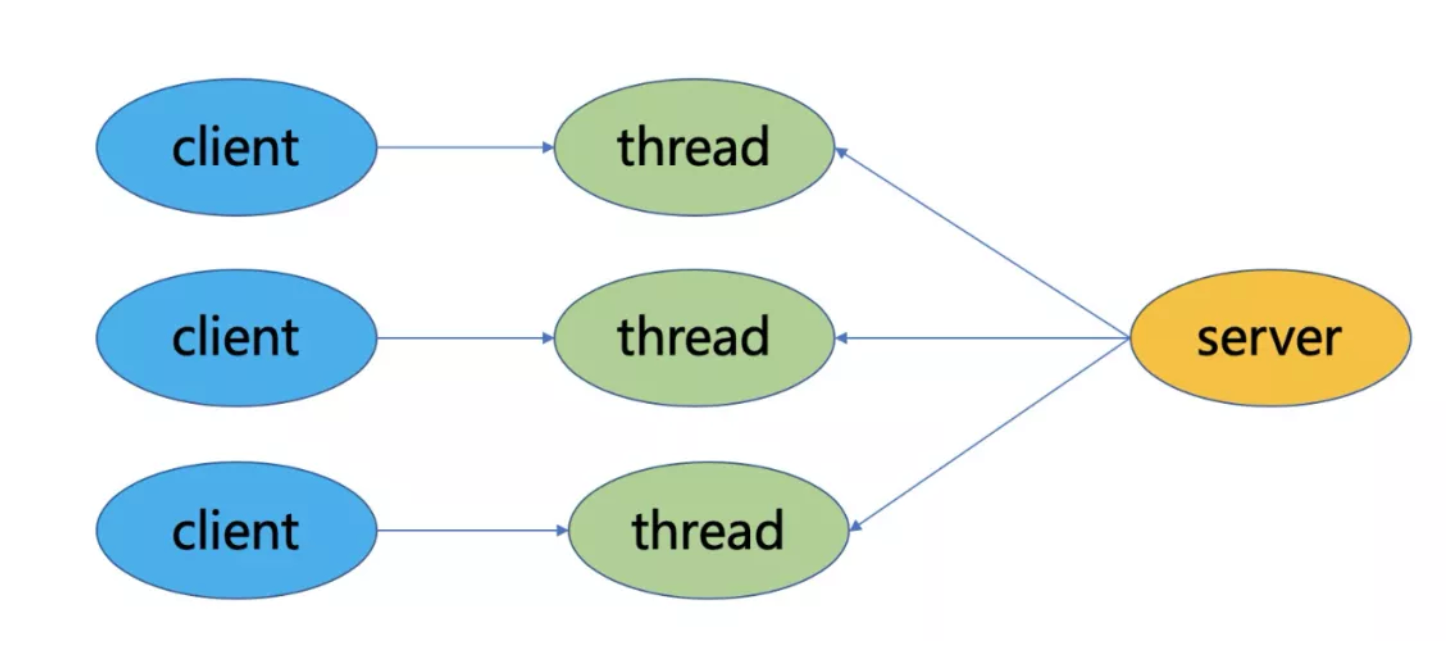
BIO模式:可靠性差,吞吐量低,适用于连接比较少且比较固定的场景,JDK1.4之前唯一的选择。编程模型最简单。
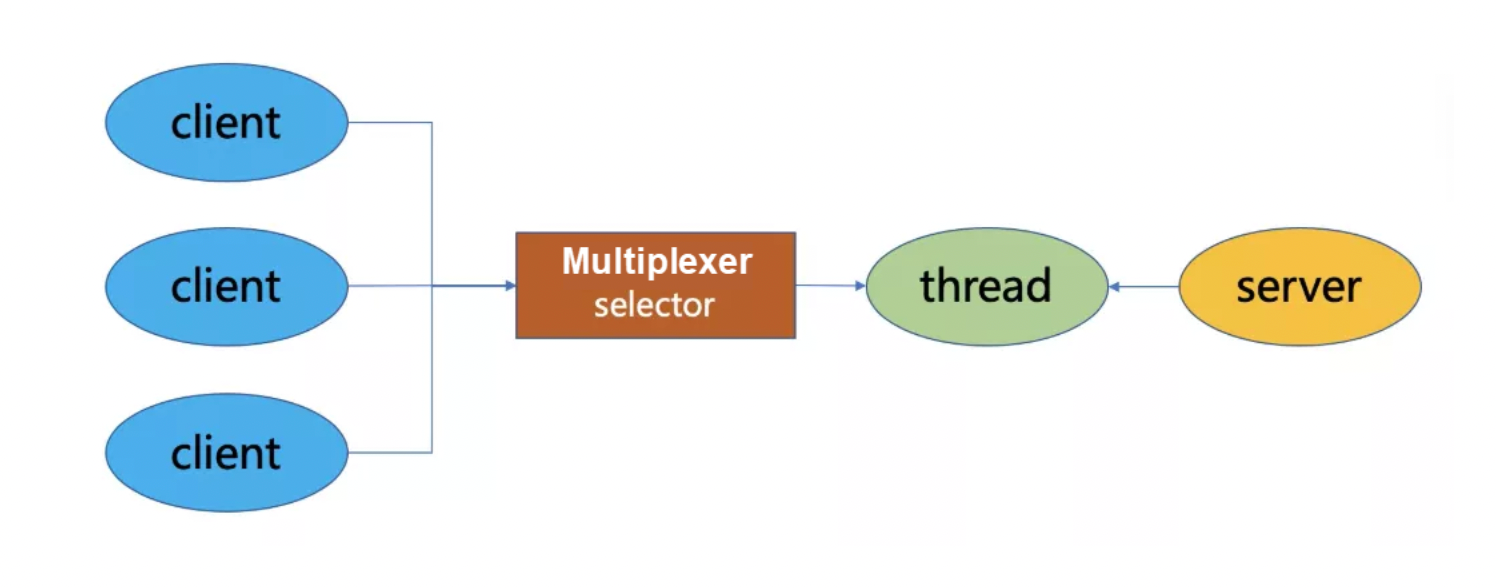
NIO模型:可靠性比较好,吞吐量比较高,适用于连接多,并且连接比较短(轻操作),例如聊天室,JDK1.4开始支持,编程模型最复杂。
AIO模型:可靠性是最好的,吞吐量也是最高的,适用于连接比较多,并且连接比较长(重操作),例如相册服务器,JDK7开始支持的,编程模型相对简单,但是需要操作系统支持。
Java NIO的几个核心组件是什么?分别有什么作用?
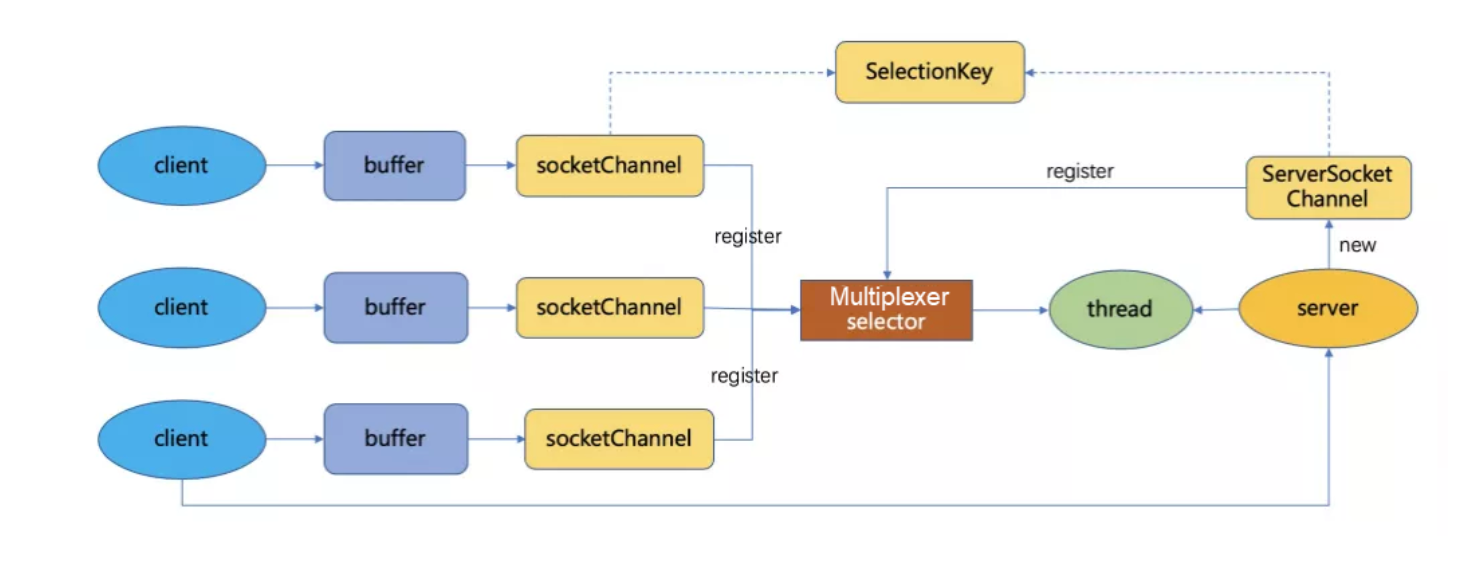
Java NIO的几个核心组件有:Channel、Buffer、Selector,它们之间的关系如下:

Channel类似于流,每个Channel对应一个Buffer缓冲区,Channel会注册到Selector,Selector会根据Channel上发生的读写时间,将请求交由某个空闲的线程处理,Selector对应一个或者多个线程。Buffer和Channel都是可读可写的。
select、poll、epoll有什么区别?
他们是NIO中多路复用的三种实现机制,是由linux操作系统提供的。
用户空间和内核空间:操作系统为了保护系统安全,将内核划分为两个部分,一个是用户空间,一个是内核空间。用户空间不能直接访问底层的硬件设备,必须通过内核空间。
文件描述符 File Descriptor(FD):是一个抽象的概念,形式上是一个整数,实际上是一个索引值。指向内核中为每个进程维护进程所打开的文件的记录表。当程序打开一个文件或者创建一个文件时,内核就会向进程返回一个FD,Unix、Linux。
select机制:会维护一个FD的结合fd_set。将fd_set从用户空间复制到内核空间,激活socket。
poll机制:和select机制差不多的。把fd_set结构进行了优化,FD集合的大小就突破了操作系统的限制,poll fd结构来代替fd_set,通过链表实现
epoll(Event poll):epoll中不再扫描所有的FD,而是只将用户关心的FD的事件存放到内核的一个事件表当中。这样就可以减少用户空间与内核空间之前需要拷贝的数据。
总结如下表:
| 操作方式 | 底层实现 | 最大连接数 | IO效率 | |
|---|---|---|---|---|
| select | 遍历 | 数组 | 受限于内核 | 一般 |
| poll | 遍历 | 链表 | 无上限 | 一般 |
| epoll | 事件回调 | 红黑树 | 无上限 | 高 |
那Java的NIO当中时使用的哪种机制呢?
这与操作系统有关,在windows下,WindowsSelectorProvider。而linux下,根据linux的内核版本,2.6内核版本以上,就是EpollSelectorProvider,默认使用的是PollSelectorProvider
HTTP和HTTPS的区别?
HTTP:是互联网上应用最为广泛的一种网络通信协议,基于TCP协议,可以使用浏览器工作更为高效,减少网络传输。
HTTPS:是HTTP的加强版,可以认为是HTTP + SSL(Secure Socket Layer)。在HTTP的基础上增加了一系列的安全机制,一方面保证数据传输安全,另一方面对访问者增加了验证机制。是目前现行架构下,最为安全的解决方案。
主要区别:
- HTTP的连接时简单无状态的,HTTPS的数据传输时经过证书加密的,安全性更高。
- HTTP是免费的,而HTTPS需要申请证书,而证书通常是收费的,并且费用一般不低。
- 他们的传输协议不同,所以他们使用的端口也是不一样的,HTTP默认端口是80,而HTTPS默认是443端口
HTTPS的缺点:
- HTTPS的握手协议比较费时,所以会影响服务的响应速度以及吞吐量。
- HTTPS也并不是完全安全的,他的证书体系并不是完全安全的。 并且HTTPS在面对DDOS这样的攻击时,几乎起不到任何作用。
- 证书不免费,并且功能越强大的证书费用越高。
三次握手和四次挥手?
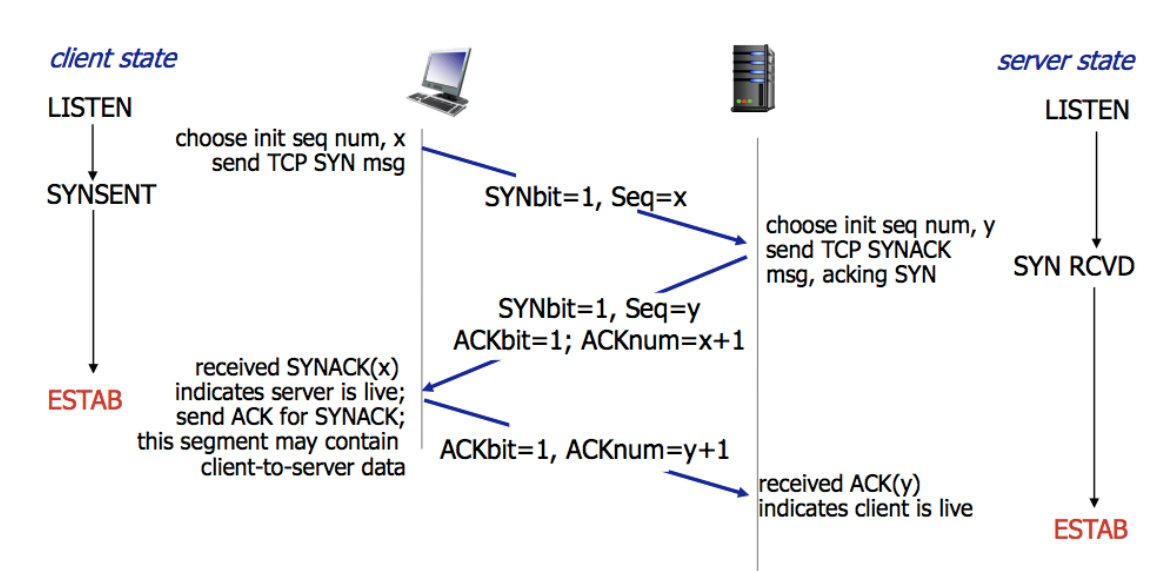
所谓三次握手,是指建立一个TCP连接时,需要客户端和服务器总共发送3个包,三次握手的目的是连接服务器指定端口,建立TCP连接,并同步连接双方的序列号和确认号,交换TCP窗口大小信息。
在socket编程中,客户端执行connect时,将触发三次握手:
TCP的连接的拆除需要发送四个包,因此称为四次握手,也叫做改进的三次握手。客户端或服务器均可主动发起挥手动作,在socket编程中,任何一方执行close()操作即可产生挥手操作:
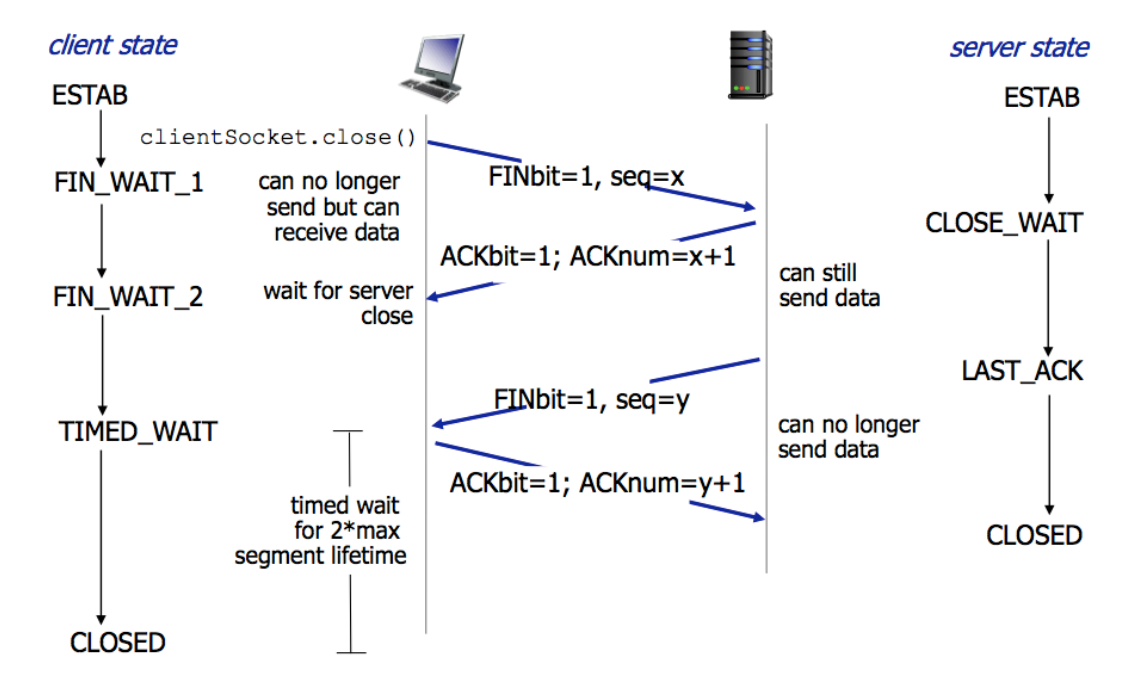
Java虚拟机
运行时数据区中包含哪些区域?哪些线程共享?哪些线程独享?
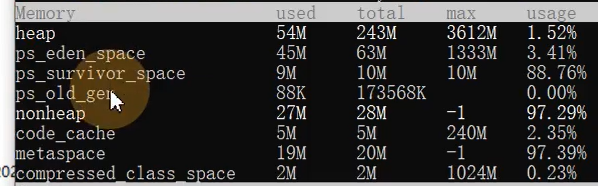
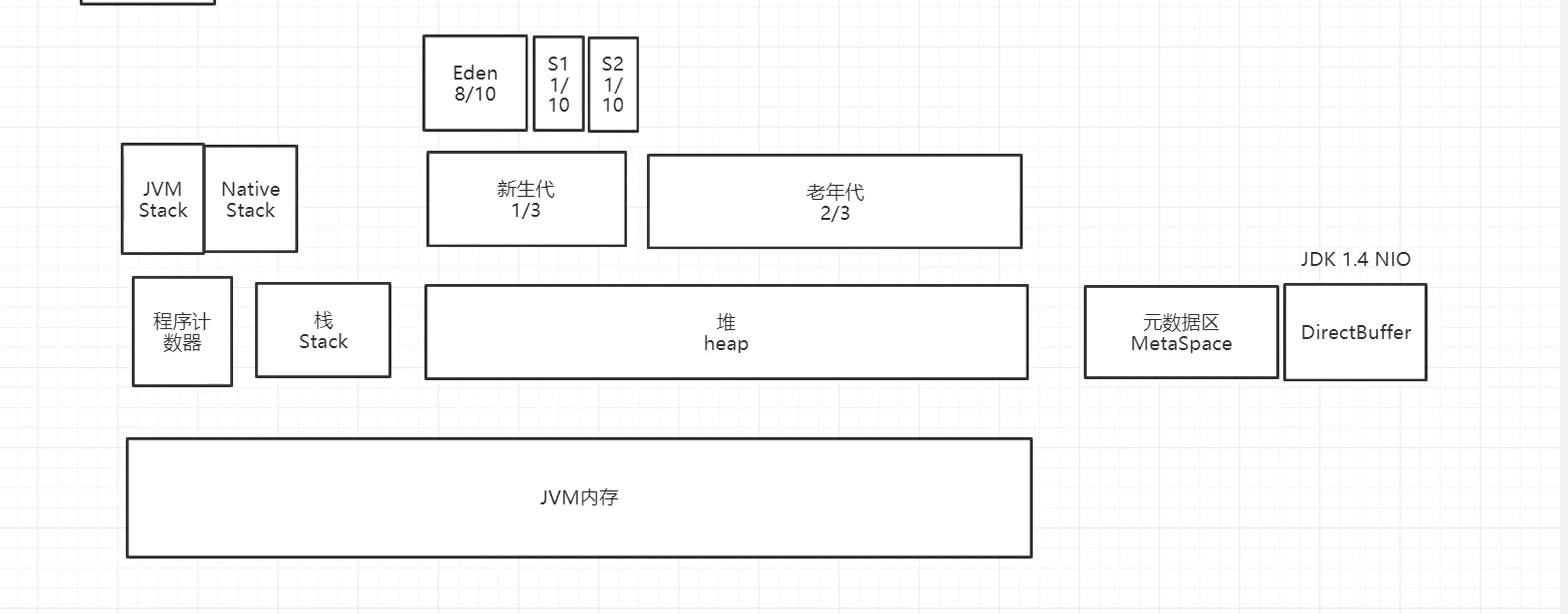
Java 创建一个对象的过程?
- 检查类是否已经被加载
- 为对象分配内存空间
- 为分配的内存空间初始化零值(为对象字段设置零值)
- 对对象进行其它设置(设置对象头)
- 执行构造方法
如何访问对象?
- 使用句柄的方式
- 使用直接指针的方式
Java 内存模型的原子性、可见性和有序性是通过哪些操作实现的?
- 原子性:synchronized
- 可见性:volatile
- 有序性:volatile和synchronized
什么是双亲委派机制?有什么作用?
Java的类加载器:AppClassLoader -> ExtClassLoader -> BootStrapClassLoader
每一种类加载器都有自己的加载目录,Java中的AppClassLoader、ExtClassLoader 都继承了URLClassLoader,URLClassLoader继承了SecureClassLoader,SecureClassLoader又继承了ClassLoader,每个类加载器对他加载过的类,都是有一个缓存的:
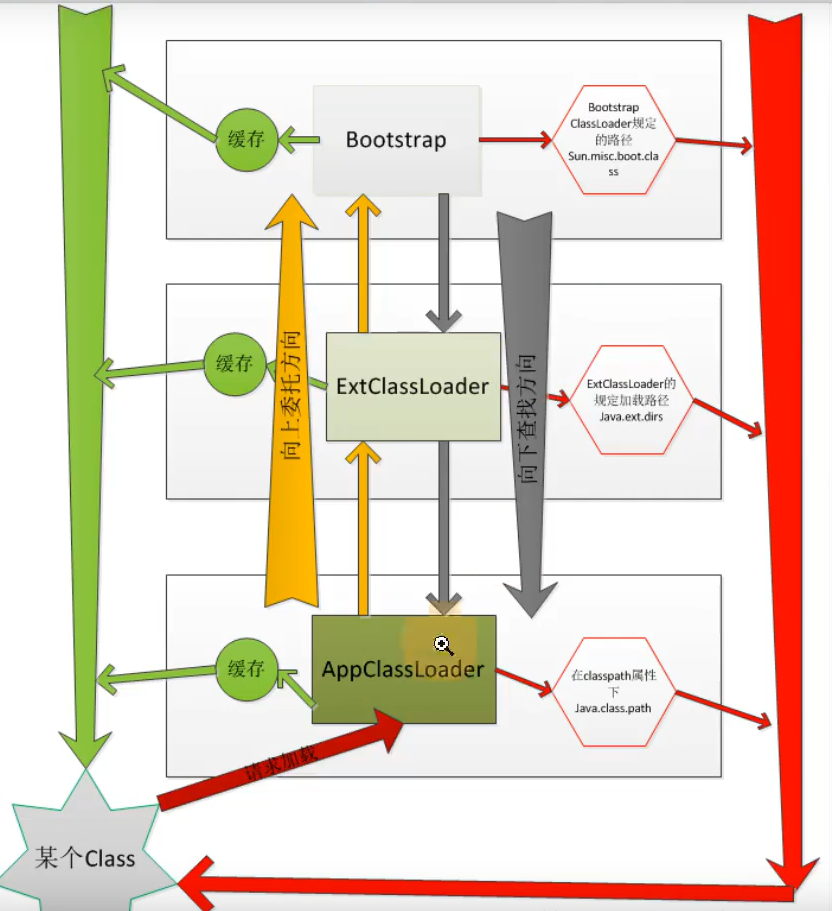
双亲委派:向上委托查找,向下委托,作用:保护Java的层的类不会被应用程序覆盖
核心代码:
protected Class<?> loadClass(String name, boolean resolve)
    throws ClassNotFoundException
{
    synchronized (getClassLoadingLock(name)) {
        // First, check if the class has already been loaded
        Class<?> c = findLoadedClass(name);
        if (c == null) {
            long t0 = System.nanoTime();
            try {
                if (parent != null) {
                    c = parent.loadClass(name, false);
                } else {
                    c = findBootstrapClassOrNull(name);
                }
            } catch (ClassNotFoundException e) {
                // ClassNotFoundException thrown if class not found
                // from the non-null parent class loader
            }

            if (c == null) {
                // If still not found, then invoke findClass in order
                // to find the class.
                long t1 = System.nanoTime();
                c = findClass(name);

                // this is the defining class loader; record the stats
                sun.misc.PerfCounter.getParentDelegationTime().addTime(t1 - t0);
                sun.misc.PerfCounter.getFindClassTime().addElapsedTimeFrom(t1);
                sun.misc.PerfCounter.getFindClasses().increment();
            }
        }
        if (resolve) {
            resolveClass(c);
        }
        return c;
    }
}
Java类加载的全过程是怎么样的?
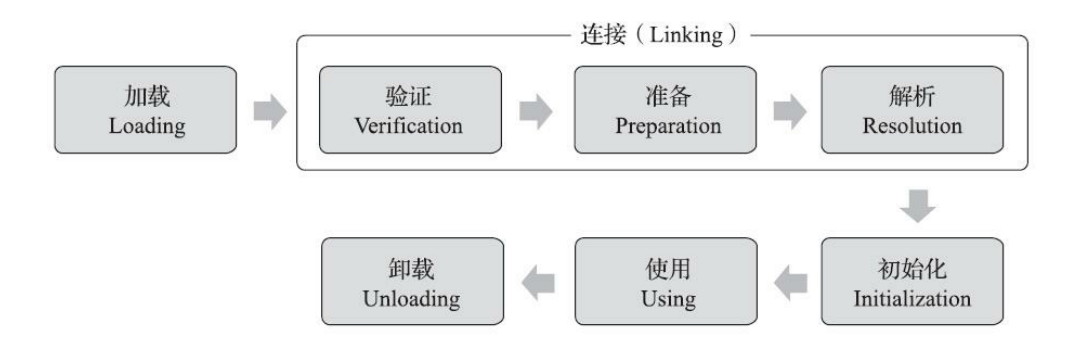
类加载过程:加载 -> 连接 -> 初始化 -> 使用 -> 卸载
- 加载:把Java的字节码数据加载到JVM内存当中,并映射成JVM认可的数据结构
- 连接:可以分为三个小的阶段:
- 验证:检查加载到的字节码信息是否符合JVM规范
- 准备:创建类或接口的静态变量,并赋初始值,半初始化状态
- 解析:将符号引用转为直接引用
- 初始化:创建对象
你了解分代理论吗?
目前绝大部分的JJVM,在针对对象进行垃圾收集的时候,会将对象熬过垃圾收集的次数,视为对象的年龄,依次将对象至少划分为新生代和老年代。分代收集理论基于以下三种假说和经验法则:
弱分代假说
绝大数对象,在第一次垃圾收集时就会被回收,按照经验法则,这个值高达百分之九十八
强分代假说
熬过越多次收集过程的对象就越难以消亡
跨代引用假说
该假说认为只会存在很少的跨代引用。因为只要经过一些次数的垃圾收集,即使还存在跨代引用,新生代会变成老年代,跨代引用也就自然小时了,所以跨代引用的数量不会多
Java堆分为新生代和老年代,针对收集对象处于哪一代,一共有以下四种收集方式:
- 部分收集
- 新生代收集(Minor GC/Young GC),只收集新生代垃圾对象
- 老年代收集(Major GC/Old GC),只收集老年代垃圾对象,目前只有CMS收集器会单独收集老年代对象
- 混合收集(Mixed GC),收集来自整个新生代以及部分老年代中的垃圾对象,目前只有G1会有这种行为
- 整堆收集(Full GC):收集整个Java堆和方法区的垃圾收集
JDK 中有几种引用类型?分别的特点是什么?
在JDK1.2之前,一个对象只有“被引用”或者“未被引用”两种状态,但这种描述方式不能满足所有的场景,譬如我们希望描述一类对象:当内存空间还足够时,能保留在内存之中,如果内存空间在垃圾收集器后仍然非常警长,那就可以抛弃这些对象,这个时候就需要对引用的概念进行扩充。
| 引用类型 | 定义 | 特点 |
|---|---|---|
| 强引用(Strong Reference) | 通过new关键赋值的引用 | 只要强引用关系还存在,垃圾收集器永远不会回收掉引用的对象 |
| 软引用(Soft Reference) | 还有用,但非必须的对象 | 内存不够时一定会被GC,长期不用也会被GC |
| 弱引用(Weak Reference) | 非必须对象 | 被弱引用关联的对象只能生存到下一次垃圾收集发生为止。无论当前内存是否足够,都会回收 |
| 虚引用(Phantom Reference) | “幽灵引用”或者“幻影引用” | 对象被垃圾收集器回收时收到一个系统通知 |
一个对象从加载到JVM,再到GC清除,都经历了什么过程?
详细步骤说明:
用户创建一个对象,JVM首先需要到方法区去找对象的类型信息,然后再创建对象。
JVM要实例化一个对象,首先要在堆中先创建一个对象 -> 半初始化状态
对象首先会分配在堆内存中新生代的Eden区,然后经过一次Minor GC,对象如果存活,就会进入S区,在后续的每次GC中,如果对象一直存活,就会在S区来回拷贝,每移动一次,年龄加1,年龄最大值是15,默认就是最大年龄是15。超过年龄先之后,对象转入老年代。
当方法执行结束后,栈中的指针会先移除掉。
堆中的对象,经过Full GC就会被标记为垃圾,然后被GC线程清理掉。
怎么样确定一个对象不是垃圾?
有两种定位垃圾的方式:
- 引用计数法:这种方式是给堆内存当中的每个对象记录一个引用个数,引用个数为0的就认为是垃圾。这是早期JDK采用的方式,引用计数无法解决循环引用的问题
- 根可达算法:这种方式是在内存中,从引用根对象向下一直找引用,找不到的对象就是垃圾
什么是GC Root?
- 在虚拟机栈(栈帧中的本地变量表)中引用的对象,譬如各个线程被调用的方法堆栈中使用到的参数、局部变量、临时变量等。
- 在方法区中类静态属性引用的对象,譬如Java类的引用类型静态变量
- 在方法区中常量引用的对象,譬如字符串常量池里的引用。
- 在本地方法栈中JNI(即通常所说的Native方法)引用的对象
- Java虚拟机内部的引用,如基本数据类型对应的Class对象,一些常驻的异常对象(比如NullPointException),还有系统类加载器。
- 所有被同步锁(synchronized关键字)持有的对象
- 反映Java虚拟机内部情况的JMXBean、JVMTI中注册的回调、本地代码缓存等
JVM有哪些垃圾回收算法?
| 算法 | 速度 | 空间开销 | 移动对象 |
|---|---|---|---|
| Mark-Sweep | 中等 | 少(但会堆积碎片) | 否 |
| Mark-Compact | 最慢 | 少(不堆积碎片) | 是 |
| Copying | 最快 | 通常需要活对象的2倍大小(不堆积碎片) | 是 |
什么是STW?
STW:stop the world,是在垃圾回收算法执行过程当中,需要将JVM内存冻结的一种状态,在STW状态下,Java所有的线程都是停止执行的,GC线程除外,只有native方法可以执行,但是,不能与JVM交互,GC各种算法优化的重点,就是减少STW,同时这也是JVM调优的重点。
JVM有哪些垃圾回收器?
| 收集器 | 串行、并行或并发 | 新生代、老年代 | 算法 |
|---|---|---|---|
| Serial | 串行 | 新生代 | 复制算法 |
| Serial Old | 串行 | 老年代 | 标记-整理 |
| ParNew | 并行 | 新生代 | 复制算法 |
| Parallel Scavenge | 并行 | 新生代 | 复制算法 |
| Parallel Old | 并行 | 老年代 | 标记-整理 |
| CMS | 并发 | 老年代 | 标记-清除 |
| G1 | 并发 | 不区分 | 标记-整理+复制算法 |
什么是三色标记算法?
CMS的核心算法就是三色标记。
三色标记:是一种逻辑上的抽象,将每个内存对象分成三种颜色:黑色:表示自己和成员变量都已经标记完毕。灰色:自己标记完了,但是成员变量还没有完全标记完。白色:自己未标记完。
CMS通过增量标记increment update的方式来解决漏标的问题。
在G1当中采用SATB的方式来避免错标和漏标的情况。
如何回收方法区?
方法区的垃圾回收主要有两种,废弃的常量和无用的类,其中要称为无用的类,要同时满足下面三个条件:
- Java堆中不存在该类的任何实例对象
- 加载该类的类加载器已经被回收
- 该类对应的java.lang.Class对象不在任何地方被引用,且无法在任何地方通过反射访问该类的方法
JVM 中的安全点和安全区各代表什么?
写屏障你了解吗?
解决并发扫描时对象消失问题的两种方案?
CMS 垃圾收集器的步骤?
1、初始标记阶段:STW 只标记出根对象直接引用的对象
2、并发标记:继续标记其他对象,与应用程序时并发执行
3、重新标记:STW对并发执行阶段的对象进行重新标记
4、并发清除:并行。将产生的垃圾清除。清除过程中,应用程序又会不断的产生新的垃圾,叫做浮动垃圾。这些垃圾就要留到下一次GC过程中清除。
CMS 有什么缺点?
- CMS收集器对CPU资源非常敏感
- CMS处理器无法处理浮动垃圾
- 在收集结束的时候,会产生大量的空间碎片
G1垃圾收集器的步骤,G1有什么优缺点?
G1的优点:
- 停顿时间短
- 用户可以指定最大的停顿时间
- 不会产生内存碎片:G1的内存布局并不是固定大小以及固定数量的分代区域划分
缺点:
G1需要记忆集(卡表)来记录新生代和老年代之间的引用关系,这种数据结构在G1中需要占用大量的内存,可能达到整个堆内存容量的20%甚至更多。而且G1中维护记忆集的成本较高,带来了更高的执行负载,影响效率。
CMS在小内存应用上的表现要优于G1,而大内存应用上G1更有优化,大小内存的界限是6GB到8GB。
讲一下内存分配策略?
内存溢出和内存泄漏的区别?
内存溢出(Out of Memory)是指程序在申请内存时,没有足够的空间供其使用
内存泄漏(Memory Leak)是指程序在申请内存后,无法释放已申请的内存空间
如何进行JVM调优?
JVM调优主要是通过定制JVM运行参数来提高Java应用程序的运行速度。
JVM参数有哪些?
JVM参数大致可以分为三类:
1、标准指令:-开头,这些是所有的HotSpot都支持的参数。可以用Java -help打印出来。
2、非标准指令:-开头,这些指令通常是跟特定的HotSpot版本对应的,可以用Java -X打印出来
3、不稳定参数:-XX开头,这一类参数是跟特定HotSpot版本对应的,并且变化非常大,详细的文档资料非常少,在JDK1.8版本下,有几个常用的不稳定指令:Java -XX:+PrintCommandLineFlags:查看当前命令的不稳定指令。
虚拟机基础故障处理工具有哪些?
| 工具 | 作用 |
|---|---|
| jps | 虚拟机进程状况工具 |
| jstat | 虚拟机统计信息监视工具 |
| jinfo | Java配置信息工具 |
| jmap | Java内存映射工具 |
| jstack | Java堆栈跟踪工具 |
| JVisualVM | 图形化展示 |
| JConsole | 远程控制 |
怎么查看一个Java进程的JVM参数,谈谈你了解的JVM参数
打印出所有不稳定参数所有默认值:java -XX:+PrintFlagsInitial
打印出所有最终生效的不稳定指令:java -XX:+PrintFlagsFinal
什么情况下堆内存会溢出,什么情况方法区会内存溢出?
栈溢出的典型例子:
 private static void fun() {
        //递归,调用自己
        fun();
    }
方法区内存溢出的例子:
 private static void fun() {
        //递归,调用自己
        fun();
    }
JDK8 为什么要将永久代改为元空间?
在JDK8之前,Java虚拟机中的永久代(Permanent Generation)用于存储类的元数据信息、静态变量、常量等。然而,永久代存在一些问题,例如固定大小、难以调优、容易导致内存溢出等。
为了解决这些问题,并引入更灵活和可调整大小的内存区域,JDK8将永久代(Permanent Generation)替换为元空间(Metaspace),并将其定义为方法区(Method Area)的一部分。
以下是一些原因解释为什么JDK8将永久代改为元空间,并将其归类为方法区:
内存动态分配:永久代的大小是固定的,无法动态调整,这在一些场景下可能会导致内存溢出。元空间通过使用本地内存(Native Memory)来存储元数据,可以根据应用程序的需要进行动态分配和释放,更加灵活。
类元数据卸载:永久代存储的类元数据在应用程序运行期间是不可卸载的,即使类已经不再使用。而元空间中的类元数据可以进行卸载,当类不再被引用时,虚拟机可以回收其占用的内存,避免了永久代中的内存泄漏问题。
自动调整空间大小:元空间可以根据应用程序的需要自动调整大小,避免了调整永久代大小的繁琐工作。在元空间中,可以通过设置参数来控制元数据的大小和增长策略,以满足应用程序的需求。
元数据分配效率:元空间使用本地内存存储元数据,相较于永久代,元空间的元数据分配效率更高。在永久代中,由于采用传统的JVM对象分配方式,需要进行内存分配和垃圾回收等操作,而元空间中的元数据分配是基于本地内存的,更加高效。
数据库面试题
Redis
Redis支持哪些数据类型?
Redis支持以下几种数据类型:
- String(字符串):最基本的数据类型,可以存储字符串、整数或浮点数。
- Hash(哈希):存储键值对的无序散列表,适合存储对象。
- List(列表):有序的字符串列表,可以在列表的两端进行插入和删除操作,支持对列表进行修剪和范围查询。
- Set(集合):无序且唯一的字符串集合,支持对集合进行添加、删除和成员判断等操作。
- Sorted Set(有序集合):与集合类似,每个成员关联一个分数,根据分数进行排序。支持添加、删除、按分数范围获取成员等操作。
- Bitmap(位图):可以对位进行设置或获取,常用于记录用户行为、统计等场景。
- HyperLogLog:使用极小的内存空间对大量的唯一元素进行基数估算,用于统计独立用户数量等。
- Geospatial(地理位置):存储地理位置信息(经度和纬度),支持查询附近位置、计算距离等操作。
什么是缓存穿透?缓存击穿?缓存雪崩?怎么解决?
缓存穿透
缓存穿透:缓存中查不到,数据库中也查询不到。
解决方案:
- 对参数进行合法性校验
- 将数据库中没有查到的结果的数据也写入到缓存,这时要注意为了防止Redis被无用的key占满,这一类缓存的有效期要设置得短一点
- 引入布隆过滤器,在访问Redis之前判断数据是否存在。要注意布隆过滤器存在一定的误判率,并且,不空过滤器只能加数据不能删数据。
缓存击穿
缓存击穿:缓存中没有,数据库中有,一般是出现在数据初始化以及key过期了的情况,他的问题在于,重新写入缓存需要一定的时间,如果是在高并发场景下,过多的请求就会瞬间写到DB上,给DB造成了很大的压力。
解决方案:
- 使用二级缓存:在系统架构中引入二级缓存,将热点数据缓存在内存中的一级缓存中,同时使用持久化存储作为二级缓存,当一级缓存失效时,可以从二级缓存中获取数据,避免直接访问后端服务
- 使用热点数据预加载(Cache Pre-warm):在系统启动或热点数据即将过期之前,提前主动加载热点数据到缓存中,避免在热点数据失效时出现大量请求。通过定时任务或异步线程更新缓存,确保热点数据的实时性
- 设置热点数据永不过期:对于一些热点数据,可以设置其过期时间为永不过期,或者设置一个相对较长的过期时间,以确保热点数据不会过期失效。但是需要注意,这种方式可能会导致缓存数据与数据库的数据不一致,需要在后端服务更新数据时同时更新缓存
- 添加互斥锁(Mutex Lock):在缓存失效的情况下,只允许一个请求访问后端服务或数据库,并将结果缓存起来。其他请求在等待该请求的执行结果时,直接从缓存中获取数据,避免对后端服务的重复访问。这种方式可以防止大量请求同时访问后端服务,减轻服务压力
- 使用布隆过滤器(Bloom Filter):布隆过滤器是一种高效的数据结构,用于判断某个元素是否存在于集合中。可以将热点数据的键存储在布隆过滤器中,当请求到来时,先通过布隆过滤器判断该键是否存在于缓存中,如果不存在,就不再访问后端服务,避免缓存穿透和击穿。
缓存雪崩
缓存雪崩:缓存大面积过期,导致请求都被转发DB。
解决方案:
- 把缓存的失效时间分散开,例如,在原有的统一失效时间基础上,增加一个随机值。
如何保证Redis与数据库的数据一致?
当我们对数据进行修改的时候,到底是先删缓存,还是先写数据库?
先删缓存,再写数据库
在高并发场景下,当第一个线程删除了缓存,还没有来得及的写数据库,第二个线程来独去数据,会发现缓存中的数据为空,那就会去读数据库中的数据(旧值、脏数据)读完之后,把读到的结果写入缓存(此时,第一个线程已经将新的值写到缓存里面了),这样缓存中的值就会被覆盖为修改前的脏数据。
总结:在这种方式下,通常要求写操作不会太频繁。
解决方案:
- 先操作缓存,但是不删除缓存,将缓存修改为一个特殊值(-999),客户端读缓存时,发现是默认直,就休眠一小会,再去查一次Redis,特殊值对业务有侵入,可能会多次重复
- 延时双删,先删除缓存,再写数据库,休眠一小会,再次删除缓存。如果数据写操作很频繁,同样还是会有脏数据的问题。
先写数据库,再删缓存
先写数据库,再删缓存,如果数据库写完了之后,缓存删除失败,数据就会不一致, 总结:始终只能保证一定时间内的最终一致性。
解决方案:
- 给缓存设置一个过期时间,问题:过期时间内,缓存数据不会更新
- 引入MQ,保证原子操作。将热点数据缓存设置为永不过期,但是在value当中写入一个逻辑上的过期时间,另起一个后台线程,扫描这些key,对于已逻辑上过期的缓存,进行删除
如何设计一个分布式锁?如何对锁性能进行优化?
分布式锁的本质:就是在所有进程都能访问到的一个地方,设置一个锁资源,让这些进程都来竞争锁的资源,数据库、zookeeper、Redis,通常对于分布式锁,会要求响应快、性能高与业务无关。
Redis实现分布式锁:SETNX key value 当key不存在时,就将key设置为value,并返回1,如果key存在就返回0。EXPIRE key locktime 设置key的有效市场,DEL key 删除。 GETSET key value 先GET,再SET,先返回key对应的值,如果没有就返回空,然后再将key设置成value。
- 最简单的分布式锁:SETNX 加锁。DEL解锁。问题:如果获取到锁的进程执行失败,他就永远不会主动解锁,那这个锁就被锁死了。
- 给锁设置过期时长。问题:SETNX和EXPIRE并不是原子性的,所以获取到锁的进程有可能还没有执行EXPIRE指令,就挂了,这时锁还是会被锁死。
- 将锁的内容设置为过期时间(客户端时间+过期时长),SETNX获取锁失败时,拿这个时间跟当前时间比对,如果是过期的锁,就先删除锁,再重新上锁。问题:在高并发场景下,会产生多个进程同时拿到锁的情况
- setNX失败后,获取锁上的时间戳,然后用getset,将自己的过期时间更新上去,并获取旧值,如果这个旧值,跟之前获得的时间戳是不一致的,就表示这个锁已经被其他进程占用了,自己要放弃竞争锁。
public boolean tryLock(RedisConnection conn) {
    long newTime = System.currentTimeMillis();
    long expireTime = nowTime + 100;
    if(conn.SETNX("mykey"),"1") == 1) {
        conn.EXPIRE("mykey",1000)
        return true;
    }else {
        long oldVal = conn.get("mykey")
        if(oldVal == null && oldVal < nowTime) {
            long currentVal = conn.GETSET("mykey",expireTime)
            if(oldVal == currentVal) {
                conn.EXPIRE("mykey",1000);
                return true;
            }
            return false;
        }
        return false;
    }
}
上面就形成了一个比较高效的分布式锁。分析一下,上面优化的各种问题,在于SETNX和EXPIRE两个指令无法保证原子性。Redis2.6提供了直接执行lua脚本的方式,通过lua脚本来保证原子性,redission。
Redis的过期删除策略?
redis设置key的过期时间:
$ EXPIRE | SETEX实现原理:
- 定期删除:每隔一段时间,执行一次删除过期key的操作,平衡执行效率和执行时长。定期删除会遍历每个database(默认16个),检查当前库中指定个数的key(默认是20个),随机抽查这些key,如果有过期的,就删除。程序中有一个全局变量扫描到了哪个数据库。
- 懒汉式删除:当使用get、getset等指令去获取数据时,判断key是否过期,过期后,就先把key删除,再执行后面的操作。
Redis是将两种方式结合来使用的。
RDB操作,子进程会全部复制父进程的数据吗?
RDB快照是一次全量备份,当进行快照持久化的时候会开启一个子进程专门负责快照持久化,子进程会拥有父进程的内存数据,父进程修改内存子进程不会反应出来,所以快照持久化期间修改的数据不会保存,存在丢失数据的可能性。
Redis的哨兵模式?
哨兵模式是Redis一种特殊的模式,Redis提供了哨兵的命令,哨兵是一个独立的进程,作为进程,它会独立运行。其原理是哨兵通过发送命令,等待Redis服务器响应,从而监控运行的多个Redis实例。
Redis使用单线程为什么速度这么快?
严格意义上来说,Redis Server是多线程的,只是它的请求处理整个流程是单线程处理的,我们平常说的Redis单线程快是指它的请求处理非常地块。
Redis每秒可以承受10w+的QPS,它如此优秀的性能主要取决于以下几个方面:
纯内存操作
所有的数据都存储在内存当中,这意味着读写数据都是在内存中完成,并且使用哈希表的数据结构,只需要O(1)的时间复杂度。
使用IO多路复用技术
Redis采用IO多路复用计数和非阻塞IO,Redis可以在单线程中监听多个Socket的请求,在任意一个Socket可读/可写时,Redis去读取客户端请求,在内存中操作对应的数据,然后再写回到Socket中。
非CPU密集型任务
Redis的大部分操作并不是CPU密集型任务,而Redis的瓶颈在于内存和网络带宽,如果单个Redis实例的性能不足以支撑业务,推荐部署多个Redis节点,组成集群的方式来利用多核CPU的能力。
单线程的优势
没有了线程上下文切换的性能耗损,也没有了访问共享资源加锁的性能损耗,开发和调试非常友好,可维护性高。
Redis自增命令使用?
每当有原子性自增的操作就可以使用INCR命令,主要在计数器场景使用,可以INCR和EXPIRE,来达到规定的生存时间内进行计数的目的,客户端也可以通过使用GETSET命令原子性地获取计数器的当前值并将计数器清零。
使用其他自增/自减操作,比如DECR和INCRBY,用户可以通过执行不同的操作增加或者减少计数器的值。
Redis如何实现消息队列?
Redisson实现分布式锁的原理?
Redis为什么能通过Lua脚本保证并发的线程安全?
谈一下Redis事务的了解?
Redis中事务的实现特征:
- 在事务中的所有命令都将会被串行化的顺序执行,事务执行期间,Redis不会再为其它客户端的请求提供任何服务,从而保证了事物中的所有命令被原子的执行
- 和关系型数据库中的事务相比,在Redis事务中如果有某一条命令执行失败,其后的命令仍然会被继续执行
- 我们可以通过MULTI命令开启一个事务,有关系型数据库开发经验的人可以将其理解为"BEGIN TRANSACTION"语句。在该语句之后执行的命令都将被视为事务之内的操作,最后我们可以通过执行EXEC/DISCARD命令来提交/回滚该事务内的所有操作。这两个Redis命令可被视为等同于关系型数据库中的COMMIT/ROLLBACK语句
- 在事务开启之前,如果客户端与服务器之间出现通讯故障并导致网络断开,其后所有待执行的语句都将不会被服务器执行。然而如果网络中断事件是发生在客户端执行EXEC命令之后,那么该事务中的所有命令都会被服务器执行
- 当使用Append-Only模式时,Redis会通过调用系统函数write将该事务内的所有写操作在本次调用中全部写入磁盘。然而如果在写入的过程中出现系统崩溃,如电源故障导致的宕机,那么此时也许只有部分数据被写入到磁盘,而另外一部分数据却已经丢失。Redis服务器会在重新启动时执行一系列必要的一致性检测,一旦发现类似问题,就会立即退出并给出相应的错误提示。此时,我们就要充分利用Redis工具包中提供的redis-check-aof工具,该工具可以帮助我们定位到数据不一致的错误,并将已经写入的部分数据进行回滚。修复之后我们就可以再次重新启动Redis服务器了
Pipeline有什么好处,为什么要用pipeline?
可以将多次IO往返的时间缩减为一次,前提是pipeline执行的指令之间没有因果相关性。使用redis-benchmark进行压测的时候可以发现影响redis的QPS峰值的一个重要因素是pipeline批次指令的数目。
Redis延迟队列怎么实现的?
详细参见:Redis延迟队列。
Redis在内存不足时,内存淘汰策略是怎么样的?
以下是Redis的内存淘汰策略:
- noeviction:默认策略,当内存不足以容纳新写入数据时,新写入操作会报错并返回错误信息
- allkeys-lru:Least Recently Used (LRU) 最近最少使用策略,从所有的键中选择最近最少使用的键进行删除
- volatile-lru:从设置了过期时间的键中选择最近最少使用的键进行删除
- allkeys-random:随机选择要删除的键
- volatile-random:从设置了过期时间的键中随机选择要删除的键
- volatile-ttl:根据键的剩余过期时间来选择删除键,越早过期的键优先删除
- volatile-lfu:Least Frequently Used (LFU) 最不经常使用策略,从设置了过期时间的键中选择使用频率最低的键进行删除
如何保证Redis的高可用?
MySQL
MySQL有哪几种数据存储引擎?
可以使用SQL查看支持的数据存储引擎:
show ENGINES;其中最为常用的是InnoDB和MyISAM两种,
MyISAM和InnoDB的区别:
- 存储文件,MyISAM每个表有两个文件,MYD和MyISAM文件,MYD是数据文件,MYI是索引文件,而InnoDB每个表只有一个文件,idb
- InnoDB支持事务,支持行锁,支持外键。
- InnoDB支持XA事务。
- InnoDB支持事务的savePoints
什么是脏读、不可重复读、幻读?
脏读、不可重复读、幻读的概念:
- 脏读:在事务进行过程中,读到了其他事务未提交的数据。
- 不可重复读:在一个事务过程中,多次查询的结果不一致。(update)
- 幻读:在同一个事务中,用同样的操作查询数据,得到的记录数不相同。(insert)
处理的方式有很多种:加锁、事务隔离、MVCC,这里只介绍使用加锁来解决这些问题:
| 类型 | 处理方式 |
|---|---|
| 脏读 | 在修改时加排他锁,直到事务提交提交才释放,读取时加共享锁,读完释放锁 |
| 不可重复读 | 读数据时加共享锁,写数据时加排他锁 |
| 幻读 | 加范围锁 |
事务的基本特性和隔离级别
事务:表示多个数据操作组成一个完整的事务单元,这个事务内的所有数据操作要么同时成功,要么同时失败。
事务的特性:ACID
- 原子性:事务是不可分割的,要么完全成功,要么完全失败。
- 一致性:事务无论是完成还是失败。都必须保持事务内操作的一致性。当失败是,都要对前面的操作进行会滚,不管中途是否成功。
- 隔离性:当多个事务操作一个数据的时候,为防止数据损坏,需要将每个事务进行隔离,互相不干扰
- 持久性:事务开始就不会终止,他的结果不受其他外在因素的影响
在MySQL中可以设置事务的隔离级别:
| SQL语句 | 含义 |
|---|---|
| SHOW VARIABLES like '%transaction' | 显示事务的隔离级别 |
| set transction level ** | 设置隔离级别 |
| set session transaction level ** | 当前会话的事务隔离级别 |
| set global transaction level ** | 当前全局的事务隔离级别 |
MySQL当中有五种隔离级别:
| 隔离级别 | 具体含义 |
|---|---|
| NONE | 不使用事务 |
| READ UNCOMMITED | 允许脏读 |
| READ COMMITED | 防止脏读,是最常用的隔离级别 |
| REPEATABLE READ | 防止脏读和不可重复读,MySQL默认 |
| SERIALIZABLE | 事务串行,可以防止脏读、幻读、不可重复度 |
五种隔离级别,级别越高,事务的安全性是更高的,但是,事务的并发性能也会越低。
MySQL的锁有哪些?什么是间隙锁?
从锁的粒度来区分:
1)行锁:加锁粒度小,但是加锁的资源开销比较大。InnoDB支持
共享锁:读锁,表示多个事务可以对同一个数据共享同一把锁,持有锁的事务都可以访问数据,但是只读不能修改。 select ** LOCK IN SHARE MODE
排他锁:写锁,只有一个事务能够获得排他锁,其他事务都不能获取该行的锁。InnoDB会对update,delete、insert语句自动添加排他锁。select ** for update。
自增锁:通常是针对MySQL当中的自增字段。如果有事务会滚这种情况,数据会回滚,但是自增序列不会回滚。
2)表锁:加锁粒度大,加锁资源开销比较小,MyIAM和InnoDB都支持。
表共享读锁,表排他写锁
意向锁:是InnoDB自动添加的一种锁,不需要用户干预。
3)全局锁:Flush tables with read lock,加锁之后整个数据库实例都处于只读状态,所有的数据变更操作都会被挂起,一般用于全库备份的时候
常见的锁算法:
1、记录锁:锁一条具体的数据。
2、间隙锁:RR隔离级别下,会加间隙锁。锁一定的范围,而不是锁具体的记录,是为了防止产生幻读。
3、Next-key:间隙锁 + 右记录锁。
MySQL索引结构是什么样的?
MySQL采用B+树作为存储索引的数据结构。
Mysql的索引结构为什么使用B+树?
总体来说有以下好处:
- 可以减少磁盘IO的次数
- 能够很好的同时支持等值查询和范围查询
- 等值查询:哈希表、跳表不适合范围查询
- 范围查询:二叉树/红黑树可以很好的满足范围查询,但当树过高时,会带来磁盘IO过高的问题;B树的范围查询,会一直到根节点再到叶子节点查询,B+树解决了范围查询的带来的问题
- B树的查询效率不稳定,在O(1-logN)之间,而B+树可以稳定在O(logN)
完整链接:MySQL 为什么采用 B+树作为索引。
聚簇索引和非聚簇索引有什么区别?
聚簇索引:数据和索引是在一起。
非聚簇索引:数据和索引不在一起。
MyISAM使用的非聚簇索引,树的子节点上的data不是数据本身,而是数据存放的地址,InnoDB采用的是聚簇索引,树的叶子节点上的data就是数据本身。
聚簇索引的数据是物理存放顺序和索引顺序是一致的,所以一个表中只能有一个聚簇索引,而非聚簇索引可以有多个。
InnoDB中,如果表定义了PK,那PK就是聚簇索引,如果没有PK,就会找一个非空的unique列作为聚簇索引。否则,InnoDB会创建一个隐藏的row-id作为聚簇索引。
MySQL主键索引和普通索引有什么区别?
MySQL的索引覆盖和回表是什么?
如果只需要在一颗索引树上就可以获取SQL所需要的所有列,就不需要再回表查询,这样查询速度就可以更快。
实现索引覆盖最简单的方式就是将要查询的字段,全部建立到联合索引当中。
MySQL集群是如何搭建的?读写分离是怎么做的?
MySQL主从结构原理:
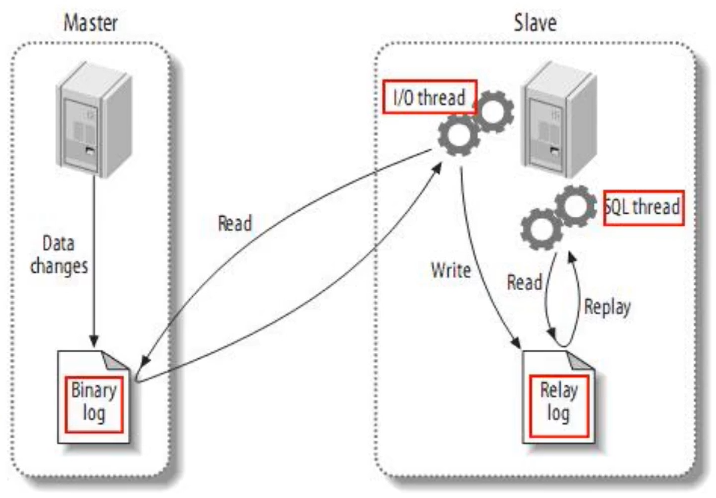
MySQL通过将主节点的Binlog同步给从节点完成主从之间的数据同步。
MySQL的主从集群只会讲Binlog从主节点同步到从节点,而不会反过来同步问题。
因为要保证主从之间的数据一致,写数据的操作只能在主节点完成。而读数据的操作,可以在主节点或者从节点上完成。
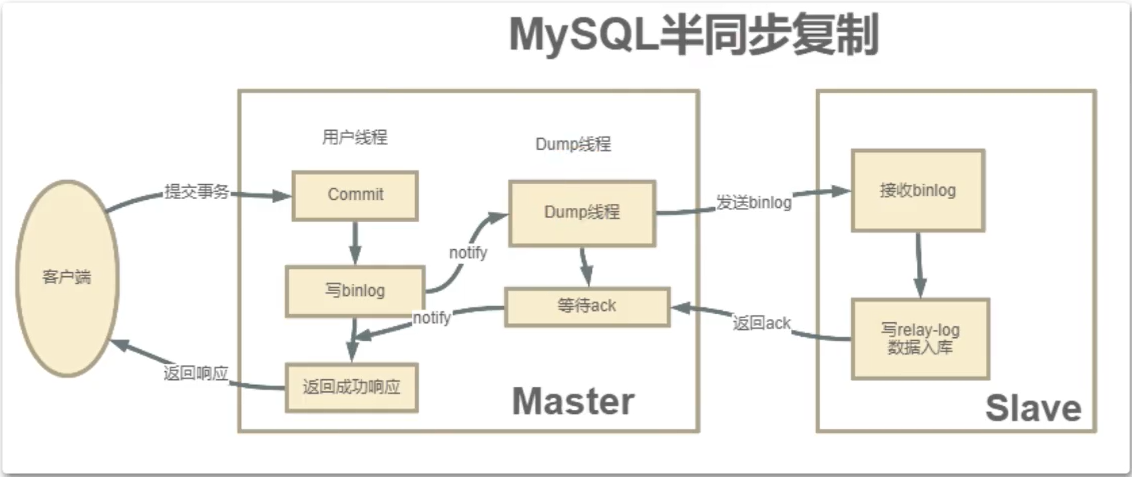
这种方式有丢失数据的风险,可以采用半同步的方式:
MySQL如何进行分库分表?多大数据量需要进行分库分表?分库分表的方式和分片策略由哪些?分库分表后,SQL语句执行流程是怎样的?
什么是分库分表:就是当表中的数据量过大时,整个查询效率就会降低的非常明显,这是为了提升查询效率,就要将一个表中的数据分散到多个数据库的多个表当中。
数据分片的方式有垂直分片和水平分片。垂直分片就是从业务角度将不同的表拆分到不同的表中,能够解决数据库数据文件过大的问题,但是不能从根本上解决查询问题。水平分片就是从数据角度将一个表中的数据拆分到不同的库或者表中,这样可以从根本上解决数据量过大造成的查询效率低的问题。
常见的分片策略有:
- 取余/取模:优点:均匀存放数据,缺点,扩容非常麻烦
- 按照范围分片:比较好扩容,数据分布不够均匀
- 按照时间分片:比较容易将热点数据区分出来
- 按照枚举值分片:例如按地区分片
- 按照目标字段前缀指定进行分区:自定义业务规则分片
建议:一个表的数据量超过500W或者数据文件超过2G,就要考虑分库分表了,分库分表最常用的组件:MyCat、ShardingSphere
ShardingSphere分库分表的执行流程:
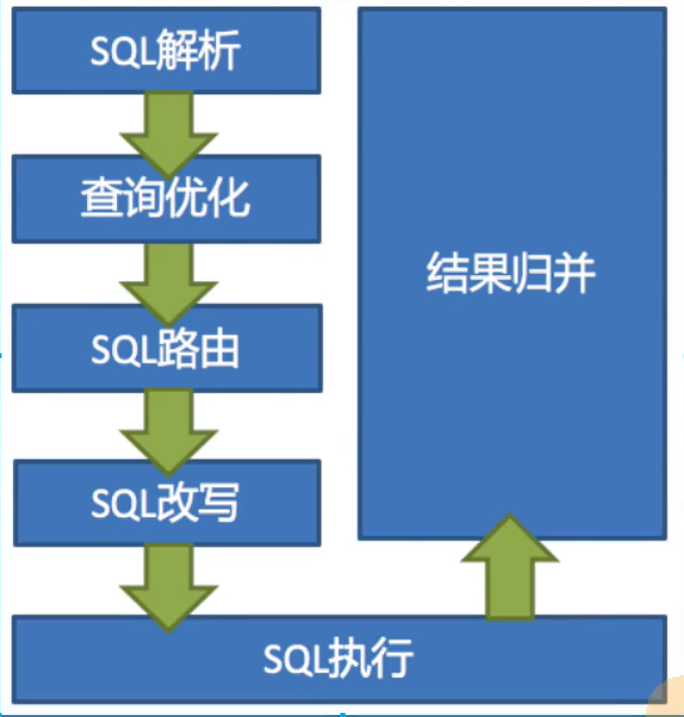
与之相关的会衍生出一系列的问题,例如一个user表,按照userid进行了分片,然后我需要按照sex字段去查,这样怎么查?强制指定只查一个数据库,要怎么做?查询结果按照userid来排序,要怎么排?
分库分表也并不是完美的,在解决了一些问题的同时,也带来了一定的缺点:
- 事务一致性问题
- 跨节点关联查询问题
- 跨节点分页、排序函数
- 主键避重
Mysql的三种删除方式的区别?
| 删除方式 | 区别 |
|---|---|
| delete | 删除数据,保留表结构,可以有条件的删除,也可以回滚数据,删除数据时进行两个动作:删除与备份 |
| truncate | 删除所有数据,无条件选择删除,不可回滚,保留表结构 |
| drop | 删除数据和表结构 删除速度最快 |
慢SQL的优化思路?
SQL优化的思路:
- 定位优化对象的性能瓶颈,确定时IO还是CPU瓶颈
- 从Explain入手,保证索引生效
limit语句会扫描全表吗?
大数量分页查询该怎么优化?
平时项目里面表结构是如何进行设计的?
MySQL的索引类型?
MySQL目前主要有以下几种索引类型:
- 普通索引
- 唯一索引
- 主键索引
- 组合索引
- 全文索引
MySQL如何快速插入千万级数据?
要点总结:
- 使用批处理语句(可能需要修改MySQL的
Max_allowed_packet配置项) - 开启事务,在事务内进行插入操作
- 数据有序插入,避免B+树出现分裂合并
补充:
- 避免使用ORM框架
Elasticsearch
什么是倒排索引?有什么好处?
索引:从id到内容。
倒排索引:从内容到id。好处:比较适合做关键字检索。可以控制数据的总量。提高查询效率。
搜索引擎为什么MySQL查询快?
ES了解多少?说说你们公司的ES集群架构。
是一个基于Lucene框架(是一个非常高效的全文检索引擎框架)的搜索引擎产品,you know for search,提供了restful风格的操作接口。
ES包含了一些核心概念:
索引 index:类似关系型数据库中的table
文档 document:row
- 字段 field text\keyword\byte:列
映射Mapping:Schema
- 查询方式:DSL(ES的新版本也支持SQL)
分片sharding和副本replicas:index都是由sharding组成的。每个sharding都有一个或者多个备份。
另外关于ES的使用场景:ES可以用在大数量的搜索场景下,另外ES也有很强大的计算能力,可以用在用户画像等场景。
如何进行中文分词?
IK分词器。HanLp中文分词器。
ES写入数据与查询数据的原理。
写入数据的原理:
客户端发写数据的请求是,可以发往任意节点,这个节点就会成为coordinating node 协调节点
计算的点文档要写入的分片:计算时就采用hash取模的方式计算
协调节点就会进行路由,将请求转发给对应的primary sharding所在的datanode。
datanode节点上的primary sharding处理请求,写入数据到索引库,并且将数据同步到对应的replica sharding
等promary sharding 和 replica sharding都保存好文档了之后,返回客户端响应
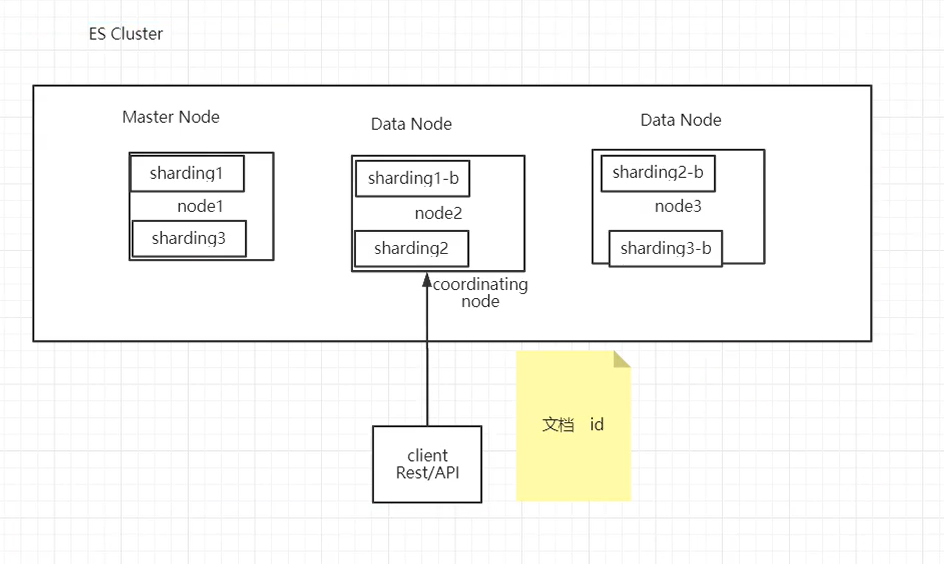
查询数据的原理:
- 客户端发送请求可发给任意节点,这个节点就成为协调节点;
- 协调节点将查询请求广播到每一个数据节点,这些数据节点的分片就会处理该查询请求;
- 每个分片进行数据查询,将符合条件的数据放在一个队列当中,并将这些数据的文档ID、节点信息、分片信息都返回给协调节点;
- 由协调节点将所有的返回结果进行汇总,并排序;
- 协调节点向包含这些文档ID的分片发送get请求,对应的分片将文档数据返回给协调节点,最后协调节点将数据整合返回给客户端。
ES部署时,要如何进行优化?
- 集群部署优化
- 调整ES的一些重要参数。path.data尽量使用固态硬盘,定制JVM堆内存大小,ES的参数,实际上大部分情况下是不需要调优的,如果有性能问题,最好的办法是安排更合里的sharding布局并且增加节点数据。
- 更合理的sharding布局,让sharding对应的replica sharding尽量在同一个机房。
- Linux服务器上一些优化策略,不要用root用户:修改虚拟内存大小,修改普通用户可以创建的最大线程数。
ES生态:ELK日志收集解决方案:filebeat -> logstash -> elaticsearch -> kibana。
常用框架
Spring面试题
Spring框架中Bean的创建过程是怎样的?
首先,简单来说,Spring框架中的Bean经历过四个阶段:实例化 -> 属性赋值 -> 初始化 -> 销毁
然后,具体来说Spring中Bean经过了以下几个步骤:
- 实例化:new **()两个时机,1、当客户端向容器申请一个Bean时,2、当容器在初始化一个Bean时还需要依赖一个Bean,BeanDefinition对象保存。
- 设置对象属性(依赖注入):Spring通过BeanDefinition找到对象依赖的其他对象,并将这些对象赋予当前对象。
- 处理Aware接口,Spring会检测对象是否实现了***Aware接口,如果实现了,就会调用对应的方法。BeanNameAware、BeanClassLoaderAware、BeanFactoryAware、ApplicationContextAware。
- BeanPostProcess,Bean创建的前置处理。调用BeanPostProcess的初始化前的方法。
- InitializingBean:Spring检测对象如果实现了这个接口,就会执行afterPropertiesSet()方法
- init-method:自定义的初始化回调方法
- BeanPorcess的后处理的方法,到这里,这个Bean创建过程就完成了,Bean就可以正常使用了。
- DisposableBean,当Bena实现了这个接口,在对象销毁前就会调用destory()方法。
- destory-method:自定义Bean销毁的回调方法。
Spring中Bean的作用域?
| 来源 | 说明 |
|---|---|
| singleton | 默认Spring Bean作用域,一个BeanFactory有且仅有一个实例 |
| prototype | 原型作用域,每次依赖查找和依赖注入生成新Bean对象 |
| request | 将Spring Bean存储在ServletRequest上下文中 |
| session | 将Spring Bean存储在HttpSession中 |
| application | 将Spring Bean存储在ServletContext中 |
笼统而言,我们只要记住单例和原型两种即可,其余三种主要是为了服务端模板引擎渲染,包括JSP、Velocity、FreeMarker。
Spring框架中的Bean是线程安全的吗?如果线程不安全,如何处理?
Spring容器本身没有提供Bean的线程安全策略,因此,也可以说Spring容器中的Bean不是线程安全的。要如何处理线程安全问题。就要分情况来分析。对于线程安全问题:
- 对于prototype作用域,每次都生成一个新的对象,所以不存在线程安全问题
- 对于sington作用域,默认就是线程不安全的。但是对于开发中大部分的Bean,其实是无状态的,不需要保证线程安全
无状态表示这个实例没有属性对象,不能保存数据,是不变的,比如:controller、service、dao;有状态表示实例有属性对象,可以保存数据,是线程不安全的,比如POJO。
如果要保证线程安全,可以将Bean的作用改为prototype。也可以采用ThreadLocal来解决线程安全的问题,ThreadLocal为每一个线程保存一个副本变量,每个线程只操作自己的副本变量。
Spring是如何处理循环依赖问题的?
一种是使用@Lazy注解,另一种是使用三级缓存。
循环依赖:多个对象之间存在循环的引用关系。在初始化过程中,就会出现”先有蛋还是先有鸡“的问题。
@Lazy注解:解决构造方法造成的循环依赖问题
对于对象之前的普通引用,二级缓存会保存new出来的不完整对象,这样当单例池中找不到依赖的属性时,就可以先从二级缓存中获取到不完整对象,完成对象的创建,在后续的依赖注入过程中,将单例池中对象的引用关系调整完成。
三级缓存:如果引用的对象配置了AOP,那在单例池中最终就会需要注入动态代理对象,而不是原对象,而生成动态代理是要在对象初始化完成之后才开始的。于是Spring增加了三级缓存,保存所有对象的动态代理配置信息,在发现有循环依赖时,将这个对象的动态代理信息获取出来,提前进行AOP,生成动态代理。

Spring如何处理事务?
Spring当中支持编程式事务管理和声明式事务管理两种方式。
1、编程式事务可以用TransactionTemlate
2、声明式事务:是Spring在AOP基础上提供的事务实现机制,他的最大优点是不需要在业务代码中添加事务管理的代码,只需要在配置文件中做相关的事务规则声明就可以了,但是声明式事务只能针对方法级别,无法控制代码块级别的事务管理。Spring中对事务定义了不同的传播级别:
- PROPAGATION_REQUIRED:默认传播行为。如果当前没有事务,就创建一个新事务,如果当前存在事务,就加入到事务中
- PROPAGATION_SUPPORTS:如果当前存在事务,就加入到该事务,如果当前不存在事务,就以非事务方式运行
- PROPAGATION_MANDATORY:如果当前存在事务,就加入到该事务,如果当前不存在事务,就抛出异常
- PROPAGATION_REQUIRES_NEW:无论当前存不存在事务,都创建新事务进行执行
- PROPAGATION_NOT_SUPPORTS:以非事务方式运行,如果当前存在事务,就将当前事务挂起
- PROPAGATION_NEVER:以非事务方式运行,如果当前存在事务,就抛出异常
- PROPAGATION_NESTED:如果当前存在事务,则在嵌套事务内执行;如果当前没有事务,则按REQUIRED属性执行
Spring中事务的隔离级别:
- ISOLATIUON_DEFAULT:使用数据库默认的事务隔离级别。
- ISOLATION_READ_UNCOMMITED:读未提交,允许事务在执行过程中,读取其他事务未提交的数据
- ISOLATION_READ_COMMITED:读已提交,允许事务在执行过程中,独去其他事务已经提交的数据
- ISOLATION_REPEATABLE_UNCOMMITED:可重复度,在同一个事务内,任意时刻的查询结果是一致的
- ISOLATION_READ_SERIALIZABLE:所有事务依次执行
更多内容参考:深入浅出Spring事务的实现原理。
Spring事务失效的场景有哪些?
- 注解@Transactional配置的方法并非public权限修饰
- 注解@Transactional所在类非Spring容器管理的Bean
- 注解@Transactional所在类中,注解修饰的方法被类内部方法调用
- 业务代码抛出异常类型非RuntimeException,事务失效
- 业务代码中存在异常时,使用try...catch...语句块捕获,而catch语句块没有throw new RuntimeException异常
- 注解@Transactional中Propagation属性值设置错误即Propagation.NOT_SUPPORTED
Spring MVC中的控制器是不是单例模式?如果是,如何保证线程安全?
控制器是单例模式,单例模式下就会有线程安全问题。
Spring中保证线程安全的方法
1、将scope设置成singleton,propotype,request。
2、最好的方式是将控制器设计成无状态模式。在控制器中不要携带数据,但是可以引用无状态的service和dao。
Spring MVC原理?
核心原理的示意图:
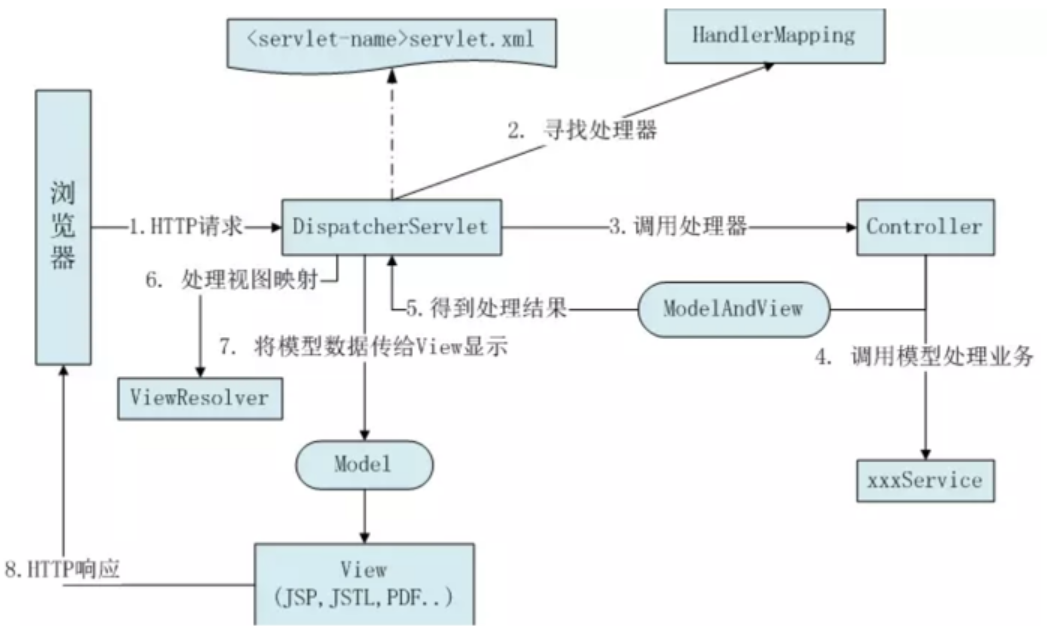
过程描述:
- 将Spring MVC处理的请求映射到DispatcherServlet的servlet上
- DispatcherServlet通过HandlerMapping去查找当前请求URL对应的Handler(通常是Controller中对应的一个方法)
- 执行对应的Handler方法
- 执行的过程中可能会调用若干的Service来完成业务的处理
- DispatcherServlet根据ModelAndView中的ViewResolver(视图解析器)中找到对应的视图
- DispatcherServlet将ModelAndView中的Model交给对应的View进行视图的渲染
- 渲染后,将视图转为HTTP响应流返回给客户端
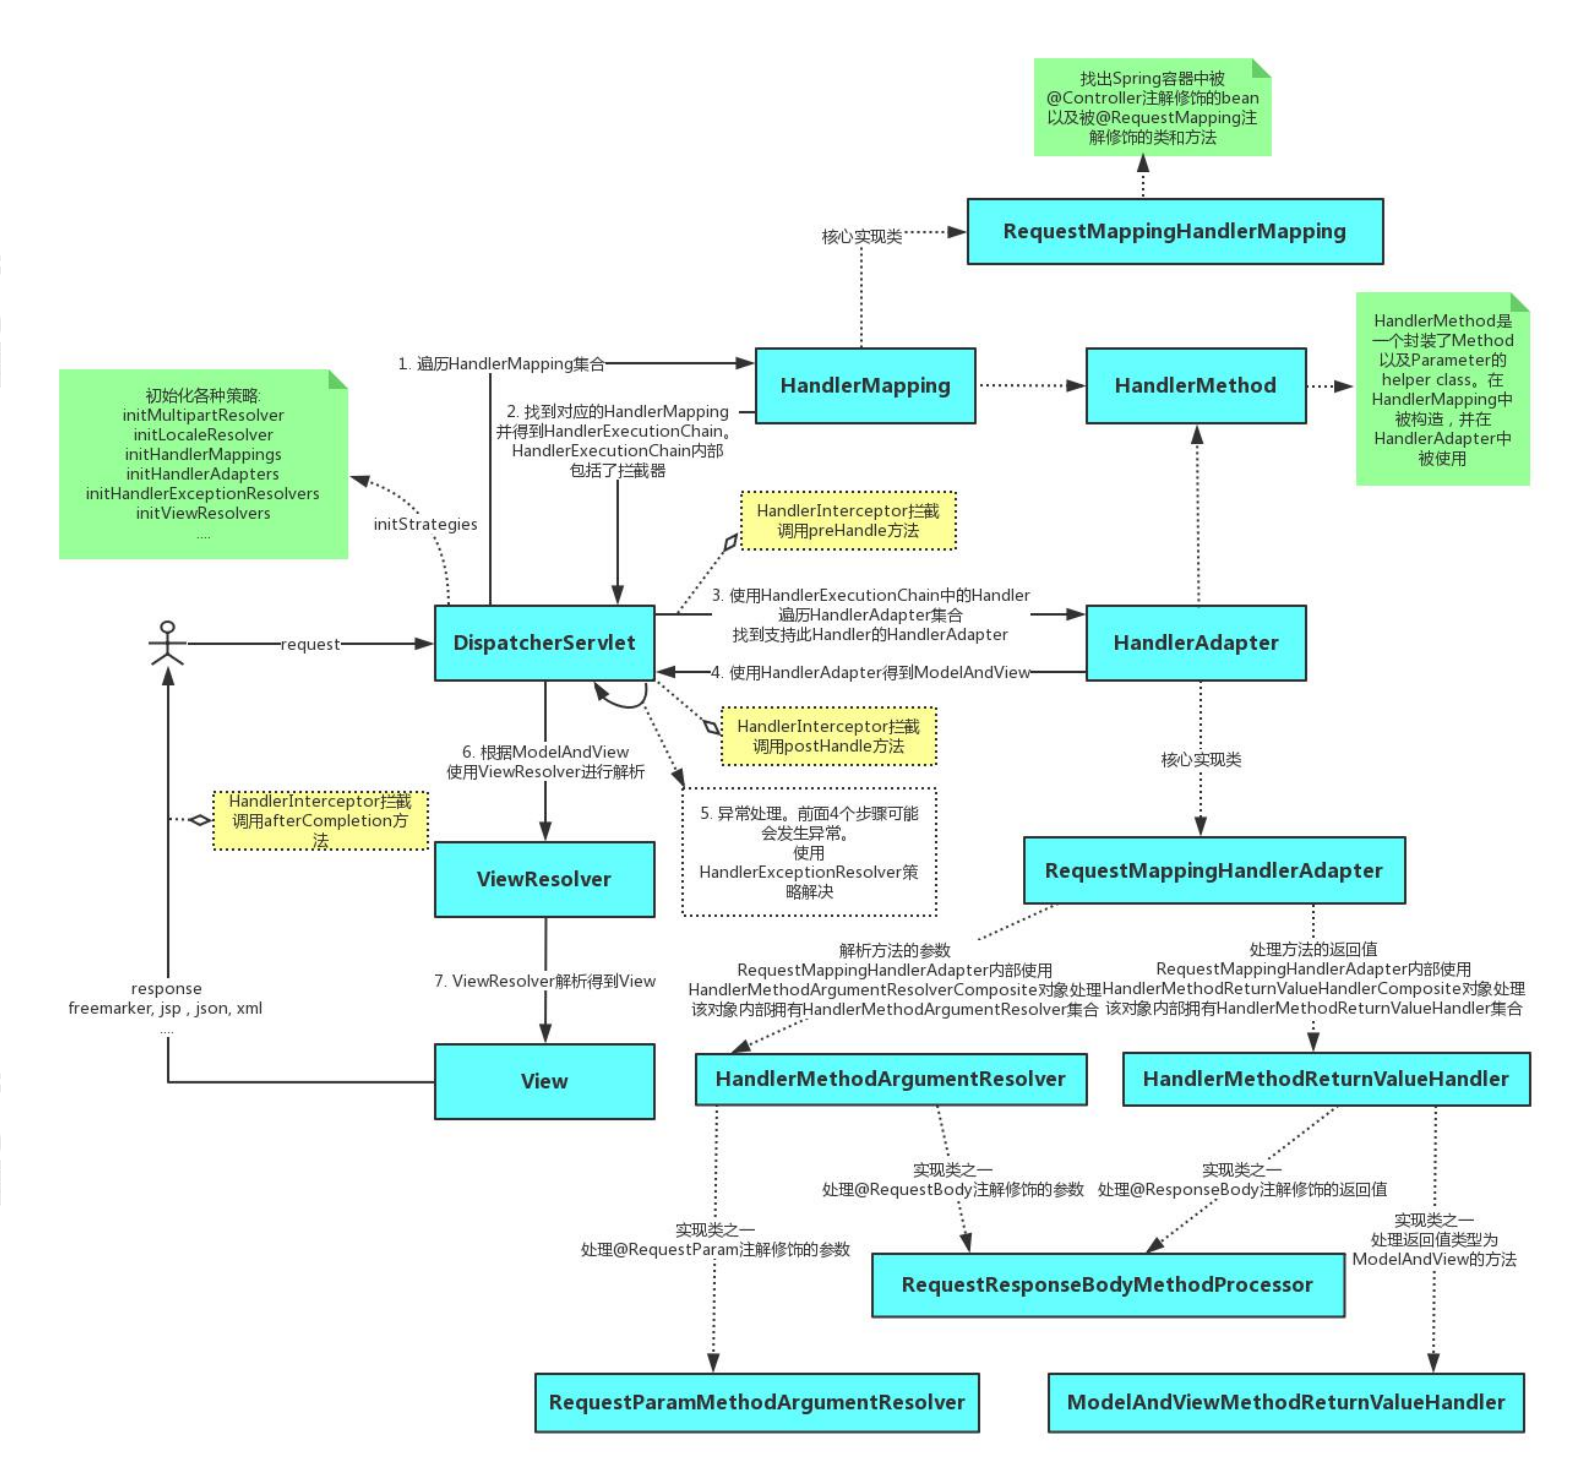
详细的示意图:
Spring中的Service有多个实现类,怎么注入?
- 使用@Qualifier("BeanId")来指定注入哪一个
- 使用@Resource(type="类名.class")来指定注入哪一个
- 每个Service的impl都可以指定名称(使用@Service("名称")),在Controller中注入service的时候使用名称来指定注入哪一个(使用@Resource(name="名称"))
SpringBoot面试题
为什么SpringBoot的 jar可以直接运行?
详细参见:SpringBoot的 jar可以直接运行。
SpringBoot自动装配过程及实现原理?
SpringBoot如何防止表单重复提交?
幂等性,通俗的说就是一个接口,多次发起同一个请求,必须保证操作只能执行一次。
需要幂等性的场景:
- 订单接口,不能多次创建订单
- 支付接口,重复支付同一笔订单只能扣一次钱
- 支付宝回调接口,可能会多次回调,必须处理重复回调
- 普通表单提交接口,因为网络超时、卡顿等原因多次点击提交,只能成功一次等等
常见的方案:
从数据库方面考虑,数据设计的时候,如果有唯一性,考虑建立唯一索引
从应用层面考虑,首先判断是单机服务还是分布式服务
- 单机服务:考虑一些缓存Cache,利用缓存,来保证数据的重复提交
- 分布式服务:考虑将用户的信息,例如token和请求的url进行组装在一起形成令牌,存储到缓存中,例如redis,并设置超时时间为**秒,如此来保证数据的唯一性(利用了redis的分布式锁)
解决方案大致总结如下:
- 唯一索引:防止新增脏数据
- token机制:防止页面重复提交,实现接口的幂等性校验
- 分布式锁:redis(jredis、redisson)或zookeeper实现
- 悲观锁:获取数据的时候加锁(锁表或锁行)
- 乐观锁:基于版本号version实现,在更新数据那一刻校验数据
- 状态机:状态变更,更新数据时判断状态
其中,前三种最为常见,更多内容可以参考:SpringBoot/Web项目防止表单/请求重复提交(单体和分布式)
如何自己写一个SpringBoot Starter?
参见:手把手教你写一个 Starter。
MyBatis面试题
Mybatis接口 Mapper内的方法为什么不能重载?
Mybatis在XML文件中寻找对应的SQL语句的时候,会根据StrictMap<String, MappedStatement>中查找对应的MappedStatement,这里Map的key就是根据Mapper的全类名 + "." + 方法名。一方面,StrictMap如果出现重复的key会直接抛出异常,另一方面,如果允许key重复,也就是允许Mapper内的方法重载,则无法定位到XML文件内唯一的SQL语句。
更多内容可以参考:Mybatis接口 Mapper内的方法为什么不能重载?
Mybatis的XML映射文件中,不同的XML映射文件,id是否可以重复?
同一个namespace下的id不能重复,原因是 namespace + id 会作为Map<String,MapperStatement>的key使用,如果id重复会导致数据互相覆盖。
#{}和${}的区别是什么?
#{} 是预编译处理,${}是字符串替换。
- Mybatis在处理#{}时,会将sql中的#{}替换为“?”号,调用PreparedStatement的set方法来赋值
- Mybatis在处理${}时,就是把${}替换程变量的值
使用#{}可以有效的放置SQL注入,提高系统的安全性。
当实体类中的属性名和表中的字段名不一样怎么办?
- 通过在查询的sql语句中定义字段名的别名,让字段名的别名和实体类的属性名一致
- 通过
<resultMap>来映射字段名和实体类属性名的一一对应的关系。
执行插入语句后如何该数据的主键?
模糊查询like语句该怎么写?
- 在java代码中添加sql通配符
- 在sql语句中拼接通配符,会引起sql注入
Mybatis时如何进行分页的?分页插件的原理是什么?
Mybatis使用RowBounds对象进行分页,它是针对ResultSet结果集执行的内存分页,而非物理分页。
Mybatis有哪些动态sql标签?
tirm、where、set、foreach、if、choose、when、otherwise、bind。
Mybtais动态sql有什么用?执行原理是什么?
MyBatis动态sql可以在XML映射文件内,以标签的形式编写动态sql,执行原理时根据表达式的值,完成逻辑判断并动态拼接sql的功能。
Mapper编写有哪几种方式?
- 接口实现类继承SqlSessionDaoSupport,需要编写mapper接口,mapper接口实现类、mapper.xml文件
- 使用org.mybatis.spring.mapper.MapperFactoryBean;
- 使用mapper扫描器
Mybatis的一级、二级缓存?
- 一级缓存:基于PerpetuaCache的HashMap本地缓存,其存储作作用域为Session,默认打开一级缓存
- 二级缓存与一级缓存机制相同,不做其作用域为Sessionfactory,该缓存是以namespace为单位的(也就是一个Mapper.xml文件),不同namespace下的操作互不影响。
使用二级缓存需要实现序列化接口。
Mybatis有二级缓存,为什么还要用Redis?
使用Mybatis的二级缓存可能会存在如下两个问题:
- 所有对数据表的改变都会刷新缓存,但是一般不要使用二级缓存,例如在UserMappper.xml中有大多数针对user表的操作,但是在另一个
Mapper.xml中,还有针对user单表的操作,这会导致user在两个命名空间下的数据不一致 - 如果在
UserMappper.xml做了刷新缓存的操作,在Mapper.xml中缓存仍然有效,如果有针对user的单表查询,使用缓存的结果可能会不正确
而Redis很好的解决了这个问题,并且还有其它的特性,例如可以搭建在其它服务器上,缓存的容量可扩展等。
Mybatis如何开启二级缓存?
Netty面试题
Netty有哪些应用场景?
- 作为RPC框架的网络通信工具
- 实现Http服务器
- 实现即时通讯系统
- 实现消息推送系统
Netty核心组件有哪些?分别有什么作用?
| 核心组件 | 作用 |
|---|---|
| Channel | Channel接口是Netty对网络操作的抽象类,它包含了基本的I/O操作,如bind()、connect()、read()、write()等 |
| EventLoop | EventLoop(事件循环)定义了Netty的核心抽象,用于处理连接的生命周期中所发生的事件,他的主要作用是负责监听网络事件并调用事件处理器进行相关I/O操作的处理 |
| ChannelFuture | 用于注册异步执行结果的监听器 |
| ChannelHandler | 消息的具体处理器,负责读写操作、客户端连接等事情 |
| ChannelPipeline | ChannelPipeline为ChannelHandler的链,提供了一个容器并定义了用于沿着链传播入站和出战事件流的API。当Channel被创建时,它会被自动地分配到它专属的ChannelPipeline。使用者可以在ChannelPipeline上通过addLast()方法添加一个或者多个ChannelHandler,因为一个数据或事件可能需要多个ChannelHandler来进行处理,在ChannelPipeline中,当一个ChannelHandler处理完之后就会将数据交给下一个ChannelHandler |
EventLoopGroup了解么?和EventLoop什么关系?
Bootstrap和ServerBootstrap了解么?
BootStrap是客户端的启动引导类/辅助类,具体使用如下:
        EventLoopGroup group = new NioEventLoopGroup();
        try {
            //创建客户端启动引导/辅助类:Bootstrap
            Bootstrap b = new Bootstrap();
            //指定线程模型
            b.group(group).
                    ......
            // 尝试建立连接
            ChannelFuture f = b.connect(host, port).sync();
            f.channel().closeFuture().sync();
        } finally {
            // 优雅关闭相关线程组资源
            group.shutdownGracefully();
        }
ServerBootStrap是客户端的启动引导类/辅助类,具体使用如下:
        // 1.bossGroup 用于接收连接,workerGroup 用于具体的处理
        EventLoopGroup bossGroup = new NioEventLoopGroup(1);
        EventLoopGroup workerGroup = new NioEventLoopGroup();
        try {
            //2.创建服务端启动引导/辅助类:ServerBootstrap
            ServerBootstrap b = new ServerBootstrap();
            //3.给引导类配置两大线程组,确定了线程模型
            b.group(bossGroup, workerGroup).
                   ......
            // 6.绑定端口
            ChannelFuture f = b.bind(port).sync();
            // 等待连接关闭
            f.channel().closeFuture().sync();
        } finally {
            //7.优雅关闭相关线程组资源
            bossGroup.shutdownGracefully();
            workerGroup.shutdownGracefully();
        }
    }
可以看出:
- BootStrap通常使用connet()方法连接到远程的主机和端口,作为Netty TCP协议通信中的客户端。另外,Bootstrap也可以通过bind()方法绑定本地的一个端口,作为UDP协议通信中的一段
- ServerBootStrap通常使用bind()方法绑定在本地的端口上,然后等待客户端的连接
- BootStrap只需要配置一个事件循环组,而ServerBootStrap需要配置两个事件循环组,一个用于接收连接,一个用于具体的处理
NioEventLoopGroup默认的构造函数会起多少线程?
CPU核心线程数*2:
    // 从1,系统属性,CPU核心数*2 这三个值中取出一个最大的
    //可以得出 DEFAULT_EVENT_LOOP_THREADS 的值为CPU核心数*2
    private static final int DEFAULT_EVENT_LOOP_THREADS = Math.max(1, SystemPropertyUtil.getInt("io.netty.eventLoopThreads", NettyRuntime.availableProcessors() * 2));

    // 当指定的线程数nThreads为0时,使用默认的线程数DEFAULT_EVENT_LOOP_THREADS
    protected MultithreadEventLoopGroup(int nThreads, ThreadFactory threadFactory, Object... args) {
        super(nThreads == 0 ? DEFAULT_EVENT_LOOP_THREADS : nThreads, threadFactory, args);
    }
Netty线程模型了解么?
基于Reactor线程模型,Reactor采用多路复用将事件分发给相应的Handler处理,非常适合处理海量IO的场景。
Netty服务端和客户端的启动过程了解么?
Netty长连接、心跳机制了解么?
Netty的零拷贝了解么?
零拷贝是指计算机执行操作时,CPU不需要先将数据从某处内存复制到另一个特定区域,这种技术通常用于通过网络传输文件时节省CPU周期和内存带宽。在OS层面上的零拷贝技术通常指避免在用户态和内核态之间来回拷贝数据。在Netty中,零拷贝主要体现在:
- 使用Netty提供的CompositeByteBuf类,可以将多个ByteBuf合并为一个逻辑上的ByteBuf,避免了各个ByteBuf之间的拷贝
- ByteBuf支持slice操作,因此可以将ByteBuf分为多个共享同一个存储区域的ByteBuf,避免了内存的拷贝
- 通过FileRegion包装的FileChannel.tranferTo实现文件传输,可以直接将文件缓冲区的数据发送到目标Channel,避免了传统通过循环write方式导致的内存拷贝问题
认证授权
网络安全
什么是认证和授权?如何设计一个权限认证框架?
认证:就是对系统访问者的身份进行确认(用户名密码登录、二维码登录、指纹、刷脸...)。
授权:就是对系统访问者的行为进行控制,授权通常是在认证之后,对系统内的隐私数据进行保护,后台接口访问权限,前台控件的访问权限。
通常情况下我们通过RBAC模型,也就是用户关联角色 ,而角色访问不同的资源,从而控制用户访问系统的行为。
认证和授权也是对一个权限认证框架进行评估的两个主要的方面。
Cookie和Session有什么区别?如果没有Cookie、Seesion还能进行身份验证吗?
当服务器tomcat第一次接收到客户端的请求时,会开辟一块独立的session空间,建立一个session对象,同时会生成session id,通过响应头的方式保存到客户端浏览器的cookie当中,以后客户端的每次请求,都会在请求头部带上这个session id,这样就可以对应上服务端的一些会话信息,比如用户的登录状态。
如果没有客户端的cookie,session是无法进行身份验证的。
当服务端从单体应用升级为分布式之后,cookie + session要如何扩展?
- session黏贴,在负载均衡中,通过某种机制,保证同一个客户端的所有请求都会转发到同一个tomcat实例当中。当这个tomcat实例出现问题之后,请求就会被转发到其他实例,这时候用户的session用户信息就丢失了。
- session复制:当一个tomcat实例上保存了session信息后,主动将session复制到集群中的其他实例。问题:复制是需要时间的,在复制的过程中,容器产生session信息丢失。
- session共享,就是将服务端的session信息保存到一个第三方中,比如Redis
什么是CSRF攻击?如何防止?
CSRF:Cross Site Request Forgery 跨站请求伪造。
一个正常的请求会将合法用户的session id保存到浏览器的cookie,这时候,如果用户在浏览器中打开另一个Tab页,那这个tab页也是可以获得浏览器的cookie,黑客就可以利用这个cookie信息进行攻击
攻击过程:
某银行网站A可以以GET请求的方式发起转账操作。www.xxx.com/transfor.do?accountNum=100&money=1000 accountNum表示目标账户,这个请求肯定是需要登录才可以正常访问的,
攻击者在某个论坛或者网站上上传一个图片,链接地址是 www.xxx.com/transfor.do?accountNum=100&money=1000,其中accountNum就是攻击者自己的银行账户。
如果有一个用户,登录了银行网站,然后又打开浏览器的另一个Tab页,点击了这个图片,这时,银行就会受理到一个带了正确的cookie的请求,就会完成转账,用户的钱就被盗了。
防止CSRF的方式:
- 尽量使用POST请求,限制GET请求,POST请求可以带请求体,攻击者就不容易伪造出请求。
- 将cookie设置为HttpOnly:response.setHeader("Set-Cookie","cookiename=cookievalue;HttpOnly")。
- 增加token:在请求中放入一个攻击者无法伪造的信息,并且该信息不存在于cookie当中。
- 增加一个额外的隐藏信息
<input type='hidden' value='demo'>这也是Spring Security框架中采用的防范方式。
什么是OAuth2?有哪几种认证方式?
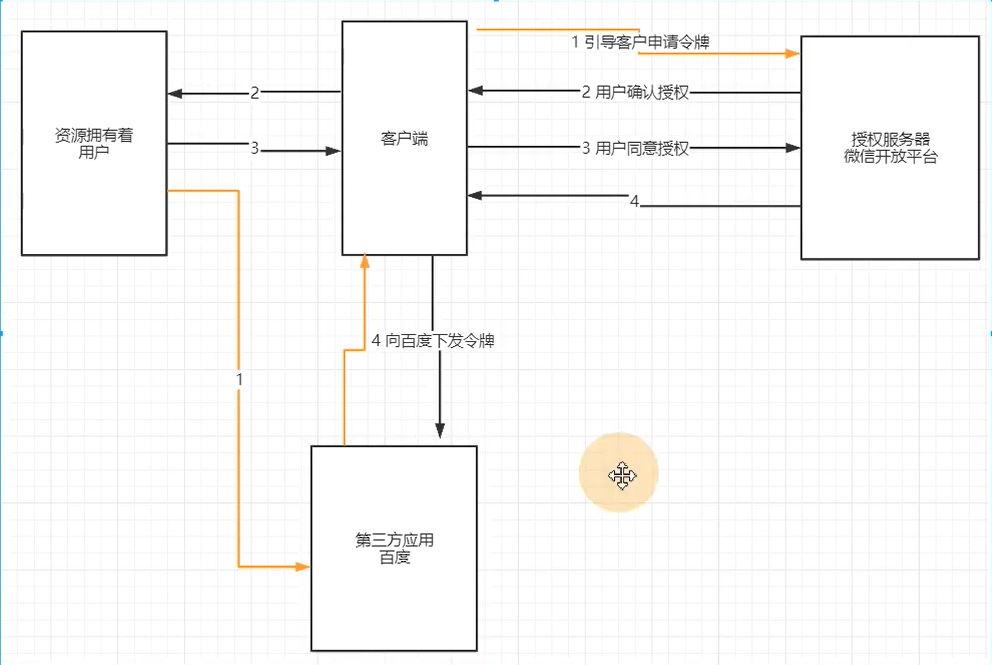
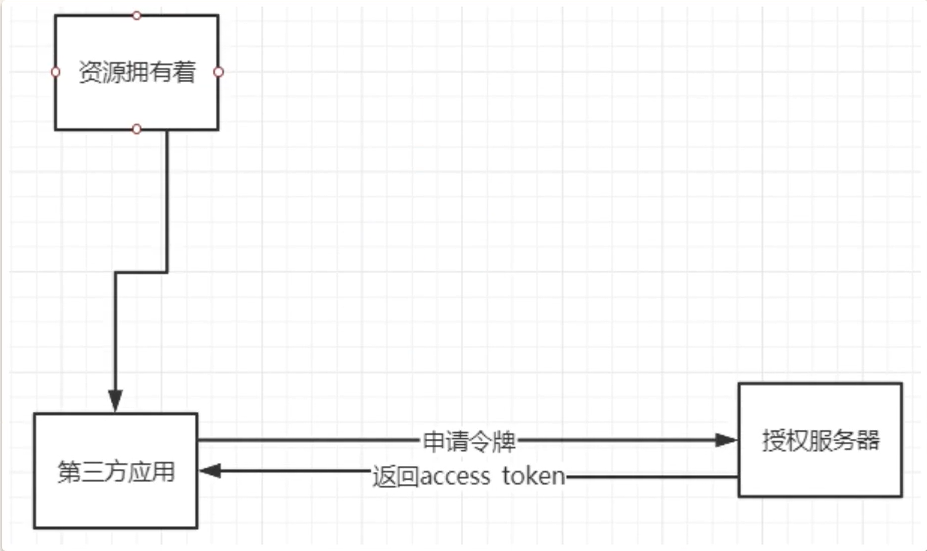
OAuth2.0是一个开放标准,允许用户授权在第三方应用程序访问他们存储在另外的服务提供者上的信息,而不需要将用户名和密码提供给第三方应用分享他们数据的所有内容。
OAuth2.0的协议认证流程,简单理解,就是允许我们将之前的授权和认证过程交给一个独立的第三方进行担保。
OAuth2.0协议有四种模式:
授权码模式:
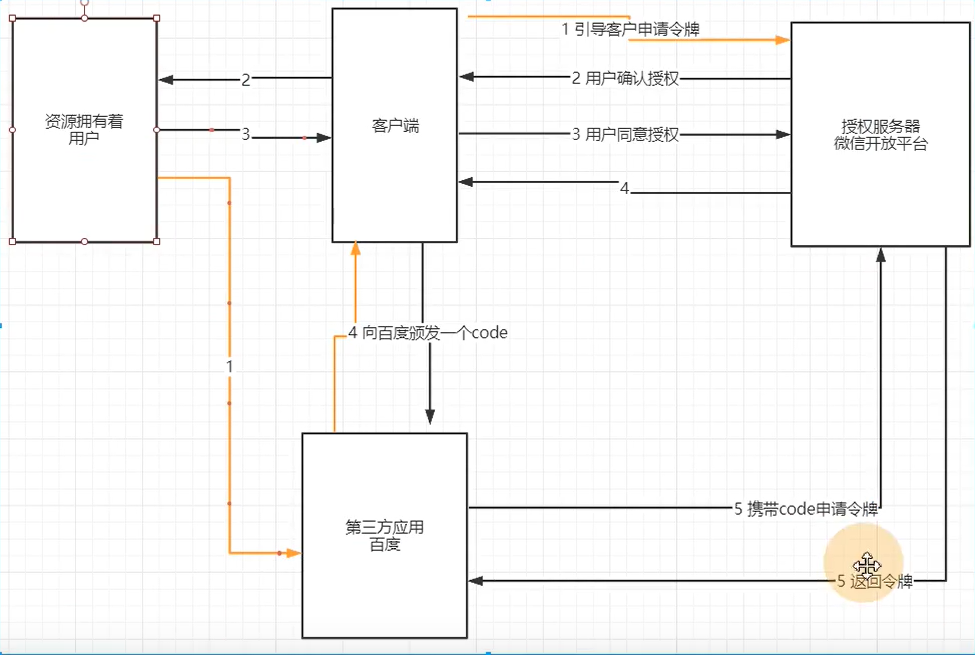
简化模式:
密码模式:
客户端模式:
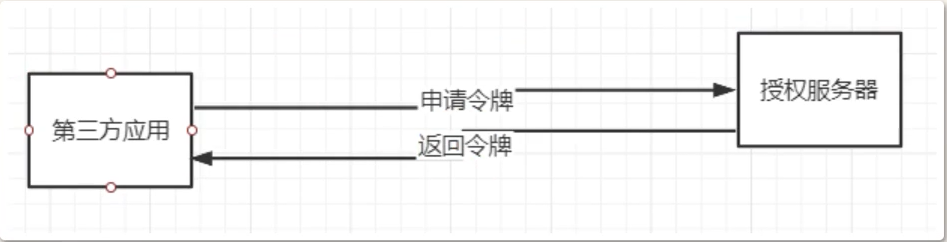
在梳理OAuth2.0协议流程的过程中,其实有一个主线,就是三方参与者的信任程度。
什么是JWT令牌?和普通令牌有什么区别?
普通令牌只是一个普通的字符串,没有特殊的意义,这就意味着,当客户端带上令牌去访问应用的接口时,应用本身无法判断这个令牌是否正确,他就需要到授权服务器上去拍段令牌是否有效,在高并发的场景下,检查令牌的网络请求就有可能成为一个性能瓶颈。
改良的方式就是JWT令牌,将令牌对应的相关信息全部冗余到令牌本身,这样资源服务器就不再需要发送求请给授权服务器去检查令牌了,他自己就可以读取到令牌的授权信息。JWT令牌的本质就是一个加密的字符串。
什么是SSO?与OAuth2.0有什么关系?
OAuth2.0的使用场景通常称为联合登录,一处注册,多处使用。
SSO:Single Sign ON:一处登录,多处同时登录。
SSO的实现关键是将Seesion信息几种存储,通常使用Spring Security实现
如何实现单点登录系统?
微服务/分布式
微服务
谈谈你对微服务的理解,微服务有哪些优缺点?
微服务是由Martin Flowler大师提出的。微服务是一种架构风格,通过将大型的单体应用划分为比较小的服务单元,从而降低整个系统的复杂度。
具有以下优点:
- 服务部署更灵活:每个应用都可以是一个独立的项目,可以独立部署,不依赖其他服务,耦合性降低。
- 技术选型更加灵活,在大型大体应用中,技术要进行更新,往往是非常困难的。而微服务可以根据业务特点,灵活选择技术栈。
- 应用的性能得到提高,大型单体应用中,往往启动就会成为一个很大的难关,而采用微服务之后,整个系统的性能是能够提高的。
- 更容易组合专门的团队,在单体应用中,团队成员往往需要对系统的各个部分都要有深入的了解,门槛是很高的。而采用微服务之后,可以给每个微服务组件专门的团队
- 代码复用:很多底层服务可以以REST API的方式对外提供统一的服务,所有基础服务可以在整个微服务系统中调用。
对应的有以下缺点:
- 服务调用的复杂性提高了,面临网络问题、容错问题、负载问题、高并发等等问题
- 分布式事务,尽量不要使用微服务的分布式事务
- 测试的难度提升了
- 运维的难度提升了,单体架构只要维护一个环节,而到了微服务是很多个环境,并且运维方式还都不一样。所以对部署、监控、告警等要求就会变得非常困难
SpringCloud和SpringCloudAlibaba有哪些组件?都解决了什么问题?
SpringCloud是提供了构建微服务系统所需要的一组通用开发模式以及一系列快速实现这些开发模式的工具。通常所说的SpringCloud是指SpringCloud NetFlix,它和SpringCloudAlibaba都是SpringCloud这一系列开发模式的具体实现。
SpringCloud NetFlix架构图:

SpringCloudAlibaba架构图:

SpringCloud和Dubbo的区别?
SpringCloud使用基于HTTP的REST方式,而Dubbo采用RPC通信。这两种方式各有优劣,前者牺牲了服务调用的性能,但也能避免原生RPC带来的问题,不存在代码级别的强依赖。
分布式事务如何处理?怎么保证事务一致性?
详细参见:深入浅出分布式事务的实现原理。
怎么拆分微服务?怎样设计出高内聚、低耦合的微服务?
拆分微服务的时候,为了保证微服务的稳定,会有一些基本的准则:
- 微服务之间尽量不要有业务交叉。
- 微服务之间只能通过接口进行服务调用,而不能绕过接口直接访问对方的数据
- 高内聚,低耦合。
高内聚低耦合,是一种从上而下指导微服务设计的方法。·实现高内聚低耦合的工具主要有同步的接口调用和异步的事件驱动(MQ)两种方式。
有没有了解通过DDD领域驱动设计?
什么是DDD:在2004年,由Eric Evans提出的,DDD是面对软件复杂之道。Domain-Driven-Design
Martin Flowler - 贫血模型 - 贫血失忆症 充血模型
MVC架构 -> 领域优先的四层架构

大泥团:不利于微服务的拆分,大泥团结构拆分出来的微服务就是泥团结构,当服务业务逐渐复杂,这个泥团又会膨胀成为大泥团。
DDD只是一种方法论,没有一个稳定的技术框架。DDD要求领域是跟技术无关、跟存储无关、跟通信无关。
微服务的链路追踪、持续集成、AB发布要怎么做?
链路追踪:
- 基于日志,形成全局事务ID,落地到日志文件。filebeat -logstash- Elaticsearch形成大型报表
- 基于MQ,往往需要架构支持,经过流式计算形成一些可视化的结果
持续集成:通过jenkins自动化构建任务
AB发布:
- AB发布又称蓝绿发布:红黑发布。老版本和新版本是同时存在的
- 灰度发布:金丝雀发布
Nacos和Eureka的区别?
- Nacos提供了服务的注册与发现,同时也提供了配置中心,而Eureka只提供了服务注册与发现
- Nacos本身支持负载均衡,而Eureka不支持
- Nacos同时支持AP和CP模式,而Eureka只满足AP模式
CAP原则又称为CAP定理,指的是在一个分布式系统中,Consistency(一致性),Availability(可用性)、Partition tolerance(分区容错性),三者不可得兼。
Nacos配置中心,本地Resource,jar包中同级目录的配置文件加载优先级?
Nacos的配置动态更新原理?
使用Nacos配置中心,@Value对应的配置项如何动态更新?
Nacos中命名空间和分组的概念及区别?
Nacos同一个namespace中的不同的group注册的服务可以相互访问吗?
Nacos服务注册的流程是怎么样的?
微服务下服务a调用服务b的流程?
注册中心,如何通过服务名找到服务实例?
熔断和限流有什么区别?
雪花算法有什么缺点?
Gateway有哪些功能?如何配置动态路由?
如何手写一个注册中心?
消息队列
MQ有什么用?有哪些具体的使用场景?
队列是一种FIFO先进先出的数据结构,而MQ(Message Queue)即消息队列消息,主要作用就是由生产者发送到MQ进行排队,然后由消费者对消息进行处理,具体使用场景如下:
- 异步:作用能提高系统的响应速度和吞吐量。
- 解耦:服务之间解耦,可以减少服务之间的影响,提高系统的稳定性和可扩展性,另外,解耦之后可以实现数据分发,生产者发送一个消息后,可以由多个消费者来处理。
- 削峰:以稳定的系统资源应对突发的流量冲击。
不过,MQ也有一些缺点:
- 系统的可用性降低:一旦MQ宕机,整个服务就会产生影响。
- 系统的复杂度提高:引入MQ之后,数据链路就会变得很复杂,并伴随着很多的问题,例如如何保证消息不丢失?消息不会重复调用?怎么保证消息的顺序性?等等
- 数据一致性:A系统发消息,需要B、C两个系统一同处理。如果B系统处理成功,C系统处理失败,这就会造成数据一致性的问题。
如何进行产品选型?
| Kafka | RabbitMQ | RocketMQ | |
|---|---|---|---|
| 优点 | 吞吐量非常大,性能非常好,集群高可用 | 消息可靠性高,功能全面 | 高吞吐,高性能,高可用,功能非常全面 |
| 缺点 | 会丢数据,功能比较单一 | 吞吐量比较低,消息积累会严重影响性能 | 开源版功能不如云上商业版。官方文档和周边生态还不够成熟。客户端只支持Java |
| 适用场景 | 日志分析、大数据采集 | 小规模场景 | 几乎是全场景 |
如何保证消息不丢失?
这个问题主要分为两个方面,第一,哪些环节会造成消息丢失?第二,在这些可能会造成消息丢失的场景下,如何保证不丢失。
总的来说,消息传递过程中如果存在跨网络的请求,或者由IO操作,就有可能会造成消息丢失,具体如下图:

那么如何保证消息不丢失呢?需要按照上面不同场景来单独处理
- 生产者发送消息不丢失
| 产品类型 | 保证生产者发送消息不丢失策略 |
|---|---|
| kafka | 消息发送+回调 |
| RocketMQ | 事务消息 |
| RabbitMQ | 消息发送+回调 |
| 手动事务:Channel:txSelect()开启事务,Channel.txCommit()提交事务,Channel.txRollback()回滚事务,这种方式对channel是会产生阻塞的,造成吞吐量下降 | |
| publisher confirms。整个处理流程跟RocketMQ的事务消息,基本是一样的。 |
具体见下图:

- MQ主从消息同步不丢失
| 产品类型 | 主从消息不丢失策略 |
|---|---|
| RoctMQ | 在普通集群中,同步同步、异步同步。异步同步效率更高,但是有丢消息的风险,同步同步就不会丢消息 |
| Rabbit MQ | 普通集群:消息是分散存储的,节点之间不会主动进行消息同步,是有可能丢失消息的 |
| 镜像集群:镜像集群会在节点之间主动进行数据同步,这样数据安全性得到提高。 | |
| Kafka | 通常都是用在允许消息少量丢失的场景,可以通过参数配置:acks:0,1,all |
- MQ消息存盘不丢失
RocketMQ:同步刷盘、异步刷盘:异步刷盘效率更高,但是有可能丢消息,同步刷盘消息安全性更高,但是效率会降低。
RabbitMQ:将队列配置成持久化队列
- 消费者消费消息不丢失
RocketMQ:使用默认的方式消费就行,不要采用异步方式
RabbitMQ:autoCommit
Kafka:手动提交offset
如何保证消费幂等性?
其实就是要防止消费者重复消费的问题。
所有MQ产品都没有提供主动解决幂等性的机制,需要由消费者自行控制。
RocketMQ:给每个消息分配了MessagesID,这个MessagesID可以作为消费者判断幂等的依据,这种方式不太建议。
最好的方式就是自己带一个有业务标识的id,来进行幂等判断,例如在订单中OrderID
还可以统一ID分配。
MQ如何保证消息顺序?
消息的顺序分为全局有序和局部有序,通常来说,MQ只需要保证局部有序,不需要保证全局有序。

Java当中对零拷贝进行了封装,Mmap方式通过MappedByteBuffer对象进行操作,而transfer通过FileChannel来进行操作。
Mmap适合比较小的文件,通常文件大小不要超过1.5G-2G,transfile没有文件大小限制。
RocketMQ当中使用Mmap方式对它的文件进行读写。
在Kafka当中,它的index日志文件也是通过Mmap的方式来读写的。在其他的日志文件当中,并没有使用零拷贝的方式,Kafka使用transfile方式将硬盘数据加载到网卡。
如何保证消息的高效读写?
零拷贝:Kafka和RocketMQ都是通过零拷贝技术来优化文件读写。
传统文件复制方式:需要对文件在内存中进行四次拷贝。

零拷贝:有两种方式:mmap和 transfile

Java当中对零拷贝进行了封装,Mmap方式通过MappedByteBuffer对象进行操作,而transfer通过FileChannel来进行操作。
Mmap适合比较小的文件,通常文件大小不要超过1.5G-2G,transfile没有文件大小限制。
RocketMQ当中使用Mmap方式对它的文件进行读写。
在Kafka当中,它的index日志文件也是通过Mmap的方式来读写的。在其他的日志文件当中,并没有使用零拷贝的方式,Kafka使用transfile方式将硬盘数据加载到网卡。
MQ 中消费时,业务逻辑出现异常怎么办?
使用MQ如何保证分布式事务的最终一致性?
分布式事务指的是业务相关的多个操作,保证他们同时成功或者同时失败。最终一致性指的是保证事务在最后阶段,能够达到一致性即可,与之对应的就是强一致性。
MQ中要保护事务的最终一致性,就需要做到两点:
- 生产者要保证100%的消息投递(使用事务消息机制)
- 消费者这一段需要保证幂等消费(唯一ID + 业务自己实现幂等)
分布式MQ的三种语义:at least once、at most once、exactly once
Rocket MQ并不能保证exactly once,商业版本中提供了exactly once的实现机制。
Kafka:在最新版本的饿源码当中,提供了exactly once的demo。
RabbitMQ:使用erlang语言天生就成为了一种屏障
Kafka如何避免重复消费?
部署运维
Linux命令
使用cat命令如何统计文件中一个字符串出现的频率?
cat 文件名 | grep -o "要统计的字符串" | wc -l命令含义:
cat命令用于将文件内容输出到标准输出。grep -o "要统计的字符串"命令用于从标准输入中匹配并提取指定字符串(使用-o选项只输出匹配的部分)。wc -l命令用于统计行数(-l选项只统计行数)。
如何查看一个应用的信息?
Dokcer命令
Docker常用的命令?
查看容器情况:
docker ps查看所有容器的命令?
docker ps -aNginx
Nginx如何保证高可用?
系统架构
设计模式
列举一些JDK中用到的设计模式?
列举一些Spring当中用到的设计模式?
项目中有用过设计模式吗?
单例模式有哪些实现方式?
懒汉式
public class Singleton {
    private static Singleton uniqueInstance;

    private Singleton() {
    }

    public static Singleton getUniqueInstance() {
        if (uniqueInstance == null) {
            uniqueInstance = new Singleton();
        }
        return uniqueInstance;
    }
}
说明:先不创建实例,当第一次被调用的时候,再创建实例,所以被称为懒汉式。
优点:延迟了实例化,如果不需要使用该类,就不会被实例化,节约了系统资源。
缺点:线程不安全,如果多个线程同时进入了if(uniqueInstance == null),若此时还未实例化,就会有多个线程同时执行uniqueInstance = new Singleton(),会实例化多个对象。
饿汉式
public class Singleton {
    private static Singleton uniqueInstance = new Singleton();

    private Singleton() {
    }

    public static Singleton getUniqueInstance() {
        return uniqueInstance;
    }
}
说明:
优点:
缺点:
双重检查锁
public class Singleton {

    private volatile Singleton uniqueInstance;

    private Singleton() {}

    public Singleton getInstance() {
        if (null == this.uniqueInstance) {
           synchronized (Singleton.class) {
              if (null == this.singleDemo) {
                    uniqueInstance = new Singleton();
                }
            }
        Singleton = new Singleton();
        return uniqueInstance;
    }
}
说明:
优点:
缺点:
静态内部类
public class Singleton {

    private Singleton() {
    }

    public static Singleton getUniqueInstance() {
        return SingletonHolder.uniqueInstance;
    }

    private static class SingletonHolder {
        private static final Singleton uniqueInstance = new Singleton();
    }
}
说明:
优点:延迟实例化,节约了资源,且线程安全,性能也提高了。
枚举类
public enum Singleton {

    UNIQUE_INSTANCE;

    // 添加自己需要的操作
    public void doSomething() {

    }
}
说明:枚举类的实例就是线程安全的,且在任何情况下都是单例的。
优点:写法简单且线程安全。
单例模式有什么应用场景?
- 数据库连接池
- 线程池
- 网站计数器
- 应用的配置