
基础篇
管程
什么是管程
如果不了解这些现象发生的背后的深层次的原因,很容易导致意外的并发安全问题。要了解这些结果产生的原因,就得了解什么是管程。
前面我们提到过在并发编程领域,有两大核心问题:一个是互斥,即同一时刻只允许一个线程访问共享资源;另一个是同步,即线程之间如何通信、协作。而这两大问题,都可以通过管程来解决。
管程-维基百科,对应的英文是Monitor,很多Java领域的同学都喜欢将其翻译成“监视器”,这是直译。操作系统领域一般都翻译成“管程”。
所谓管程,指的是管理共享变量以及对共享变量的操作过程,让他们支持并发。翻译为Java领域的语言,就是管理类的成员变量和成员方法,让这个类是线程安全的。那管程是怎么管的呢?
MESA模型
在管程的发展史上,先后出现过三种不同的管程模型,分别是:Hasen模型、Hoare模型和MESA模型。其中,现在广泛应用的是MESA模型,并且Java管程的实现参考的也是MESA模型。所以今天我们重点介绍一下MESA模型。
在并发编程领域,有两大核心问题:一个是互斥,即同一时刻只允许一个线程访问共享资源;另一个是同步,即线程之间如何通信、协作。这两大问题,管程都是能够解决的。
我们先来看看管程是如何解决互斥问题的。
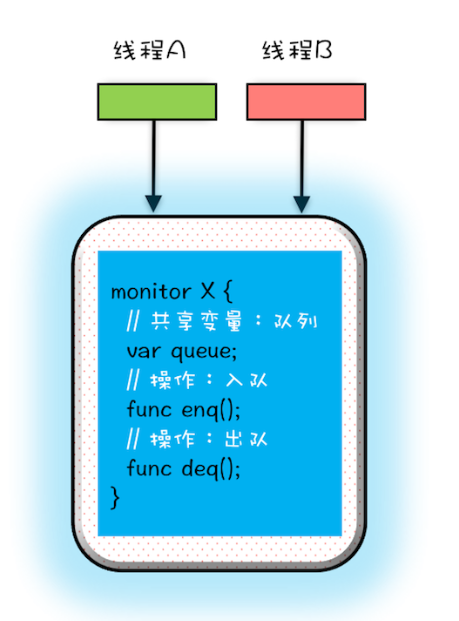
管程解决互斥问题的思路很简单,就是将共享变量及其对共享变量的操作统一封装起来。假如我们要实现一个线程安全的阻塞队列,一个最直观的想法就是:将线程不安全的队列封装起来,对外提供线程安全的操作方法,例如入队操作和出队操作。
利用管程,可以快速实现这个直观的想法。在下图中,管程X将共享变量queue这个线程不安全的队列和相关的操作入队操作enq()、出队操作deq()都封装起来了;线程A和线程B如果想访问共享变量queue,只能通过调用管程提供的enq()、deq()方法来实现;enq()、deq()保证互斥性,只允许一个线程进入管程。
那管程如何解决线程间的同步问题呢?
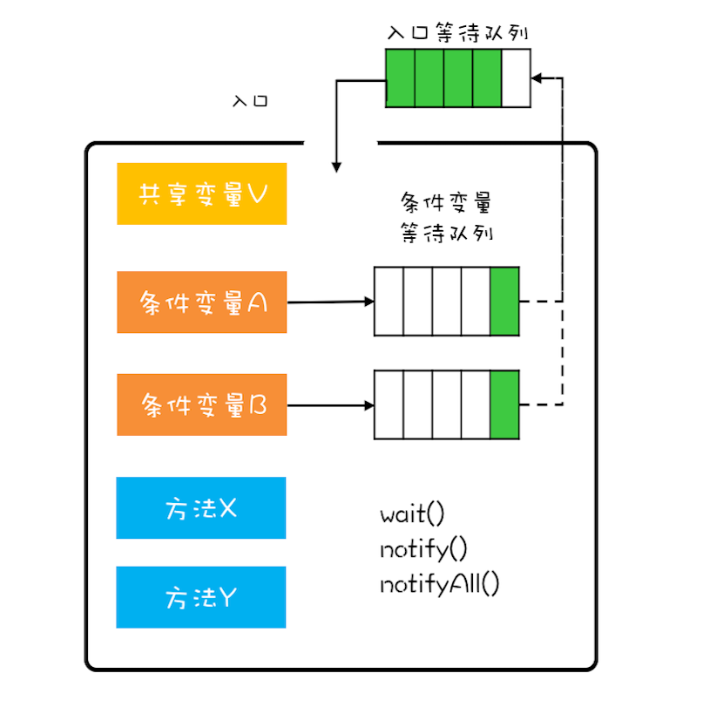
在下面,我展示了一幅MESA管程模型示意图,它详细描述了MESA模型的主要组成部分。
在管程模型里,共享变量和对共享变量的操作是被封装起来的,图中最外层的框就代表封装的意思。框的上面只有一个入口,并且在入口旁边还有一个入口等待队列。当多个线程同时试图进入管程内部时,只允许一个线程进入,其他线程则在入口等待队列中等待。这个过程类似就医流程的分诊,只允许一个患者就诊,其他患者都在门口等待。
管程里还引入了条件变量的概念,而且**每个条件变量都对应有一个等待队列,**如下图,条件变量A和条件变量B分别都有自己的等待队列。
那条件变量和条件变量等待队列的作用是什么呢?
假设有个线程 T1 执行阻塞队列的出队操作,执行出队操作,需要注意有个前提条件,就是阻塞队列不能是空的(空队列只能出 Null 值,是不允许的),阻塞队列不空这个前提条件对应的就是管程里的条件变量。 如果线程 T1 进入管程后恰好发现阻塞队列是空的,那怎么办呢?等待啊,去哪里等呢?就去条件变量对应的等待队列里面等。此时线程 T1 就去“队列不空”这个条件变量的等待队列中等待。这个过程类似于大夫发现你要去验个血,于是给你开了个验血的单子,你呢就去验血的队伍里排队。线程 T1 进入条件变量的等待队列后,是允许其他线程进入管程的。这和你去验血的时候,医生可以给其他患者诊治,道理都是一样的。
再假设之后另外一个线程 T2 执行阻塞队列的入队操作,入队操作执行成功之后,“阻塞队列不空” 这个条件对于线程 T1 来说已经满足了,此时线程 T2 要通知 T1,告诉它需要的条件已经满足了。当线程 T1 得到通知后,会从等待队列里面出来,但是出来之后不是马上执行,而是重新进入到入口等待队列里面。这个过程类似你验血完,回来找大夫,需要重新分诊。
条件变量及其等待队列我们讲清楚了,下面再说说 wait()、notify()、notifyAll() 这三个操作。前面提到线程 T1 发现“阻塞队列不空”这个条件不满足,需要进到对应的等待队列里等待。这个过程就是通过调用 wait() 来实现的。如果我们用对象 A 代表“阻塞队列不空”这个条件,那么线程 T1 需要调用 A.wait()。同理当“阻塞队列不空”这个条件满足时,线程 T2 需要调用 A.notify() 来通知 A 等待队列中的一个线程,此时这个等待队列里面只有线程 T1。至于 notifyAll() 这个方法,它可以通知等待队列中的所有线程。
下面的代码用管程实现了一个线程安全的阻塞队列。阻塞队列有两个操作分别是入队和出队,这两个方法都是先获取互斥锁(通过 synchronized 关键字),类比管程模型中的入口。
- 对于阻塞队列的入队操作,如果阻塞队列已满,就需要等待直到阻塞队列不满,所以这里用了
wait();,让线程进入条件变量的等待队列。 - 对于阻塞出队操作,如果阻塞队列为空,就需要等待直到阻塞队列不空,所以就用了
wait();,让线程进入条件变量的等待队列。 - 如果入队成功,那么阻塞队列就不空了,就需要通知等待队列中的线程,告诉它们"队列不空"这个条件已经满足,所以调用了
notify();。 - 如果出队成功,那就阻塞队列就不满了,就需要通知等待队列中的线程,告诉它们"队列不满"这个条件已经满足,所以调用了
notify();。
public class SynchronizedMesa<T> {
    private final Queue<T> queue = new LinkedList<>();
    private final int capacity;

    public SynchronizedMesa(int capacity) {
        this.capacity = capacity;
    }

    // 入队
    public synchronized void enq(T x) throws InterruptedException {
        while (queue.size() == capacity) {
            // 队列满,等待"队列不满"这个条件
            // wait() 会让当前线程进入条件变量的等待队列
            this.wait();
        }
        queue.add(x);
        System.out.println("入队: " + x + ",当前大小: " + queue.size());

        // 入队后,队列一定不空,唤醒等待"队列不空"条件的线程
        // notify() 会通知等待队列中的一个线程
        this.notify();
    }

    // 出队
    public synchronized T deq() throws InterruptedException {
        while (queue.isEmpty()) {
            // 队列空,等待"队列不空"这个条件
            // wait() 会让当前线程进入条件变量的等待队列
            this.wait();
        }
        T item = queue.poll();
        System.out.println("出队: " + item + ",当前大小: " + queue.size());

        // 出队后队列不满,唤醒等待"队列不满"条件的线程
        // notify() 会通知等待队列中的一个线程
        this.notify();
        return item;
    }

    // demo
    public static void main(String[] args) {
        SynchronizedMesa<Integer> mesa = new SynchronizedMesa<>(3);

        // 生产者
        new Thread(() -> {
            for (int i = 1; i <= 10; i++) {
                try {
                    mesa.enq(i);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        }, "Producer").start();

        // 消费者
        new Thread(() -> {
            for (int i = 1; i <= 10; i++) {
                try {
                    mesa.deq();
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        }, "Consumer").start();
    }
}
在这段示例代码中,我们使用了 Java 内置的 synchronized 和 wait()、notify() 方法。wait() 方法用于让线程进入条件变量的等待队列;notify() 方法用于通知等待队列中的一个线程,告诉它条件已经满足。
需要注意的是,Java 内置的管程(synchronized)只有一个条件变量,所以"队列不满"和"队列不空"这两个条件实际上共享同一个等待队列。但通过 while 循环检查不同的条件,我们可以模拟多个条件变量的效果。当线程被唤醒后,会重新检查条件是否满足,如果不满足就继续等待,这正是 MESA 管程模型的特点。
需要注意的是对于 MESA 管程来说,有一个编程范式,就是需要在一个 while 循环里面调用 wait()。这个是 MESA 管程特有的。
while(条件不满足) {
  wait();
}
Hasen 模型、Hoare 模型和 MESA 模型的一个核心区别就是当条件满足后,如何通知相关线程。管程要求同一时刻只允许一个线程执行,那当线程 T2 的操作使线程 T1 等待的条件满足时,T1 和 T2 究竟谁可以执行呢?
Hasen 模型里面,要求 notify() 放在代码的最后,这样 T2 通知完 T1 后,T2 就结束了,然后 T1 再执行,这样就能保证同一时刻只有一个线程执行。
Hoare 模型里面,T2 通知完 T1 后,T2 阻塞,T1 马上执行;等 T1 执行完,再唤醒 T2,也能保证同一时刻只有一个线程执行。但是相比 Hasen 模型,T2 多了一次阻塞唤醒操作。
MESA 管程里面,T2 通知完 T1 后,T2 还是会接着执行,T1 并不立即执行,仅仅是从条件变量的等待队列进到入口等待队列里面。这样做的好处是 notify() 不用放到代码的最后,T2 也没有多余的阻塞唤醒操作。但是也有个副作用,就是当 T1 再次执行的时候,可能曾经满足的条件,现在已经不满足了,所以需要以循环方式检验条件变量。
notify() 何时可以使用
还有一个需要注意的地方,就是 notify() 和 notifyAll() 的使用,前面章节,我曾经介绍过,除非经过深思熟虑,否则尽量使用 notifyAll()。那什么时候可以使用 notify() 呢?需要满足以下三个条件:
- 所有等待线程拥有相同的等待条件;
- 所有等待线程被唤醒后,执行相同的操作;
- 只需要唤醒一个线程。
比如上面阻塞队列的例子中,对于“阻塞队列不满”这个条件变量,其等待线程都是在等待“阻塞队列不满”这个条件,反映在代码里就是下面这 3 行代码。对所有等待线程来说,都是执行这 3 行代码,重点是 while 里面的等待条件是完全相同的。
管程是一个解决并发问题的模型,你可以参考医院就医的流程来加深理解。理解这个模型的重点在于理解条件变量及其等待队列的工作原理。
Java 参考了 MESA 模型,语言内置的管程(synchronized)对 MESA 模型进行了精简。MESA 模型中,条件变量可以有多个,Java 语言内置的管程里只有一个条件变量。具体如下图所示。
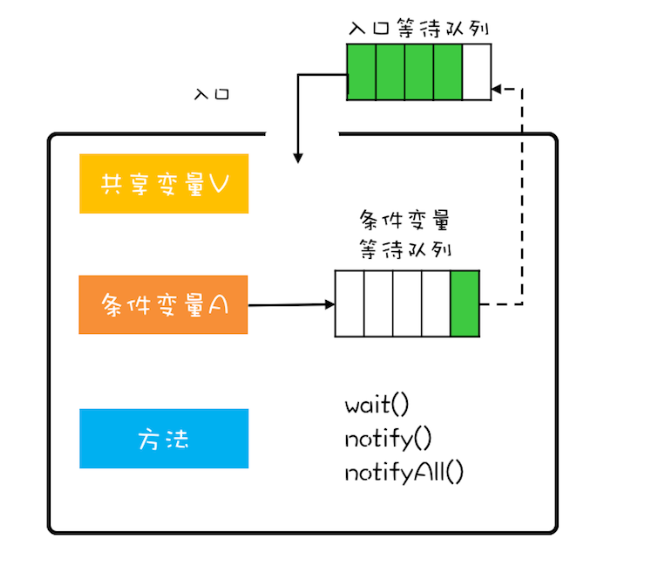
Java 内置的管程方案(synchronized)使用简单,synchronized 关键字修饰的代码块,在编译期会自动生成相关加锁和解锁的代码,但是仅支持一个条件变量;而 Java SDK 并发包实现的管程支持多个条件变量,不过并发包里的锁,需要开发人员自己进行加锁和解锁操作。
并发编程里两大核心问题——互斥和同步,都可以由管程来帮你解决。学好管程,理论上所有的并发问题你都可以解决,并且很多并发工具类底层都是管程实现的,所以学好管程,就是相当于掌握了一把并发编程的万能钥匙。
MESA 与 synchronized
MESA 与 Lock
Lock在实现的时候,仍然是按照管程的MESA模型来实现的。
CPU缓存架构和缓存一致性协议
并发安全问题不是 Java 独有的,它的根在硬件。CPU 为了追上内存的速度,在芯片内部加了好几层缓存,而缓存一旦有副本,就有了「谁的那份是最新的」这个麻烦。Java 内存模型说到底,就是在给这套硬件行为做一层封装。
为什么需要 CPU 缓存
CPU 的运算速度远远快于内存。一次内存访问大约需要上百个时钟周期,而一次寄存器运算只要一个周期,如果每条指令都要等内存,CPU 大部分时间都在空转。
于是硬件在 CPU 和内存之间加了一层容量小但极快的缓存(Cache),把最近用过的数据留在离运算单元更近的地方。这个思路能成立,靠的是程序的局部性原理:
- 时间局部性:刚被访问过的数据,很可能马上还会被访问(比如循环里的计数器)
- 空间局部性:一个地址被访问了,它相邻的地址很可能也会被访问(比如顺序遍历数组)
缓存和内存之间的数据交换不是按字节来的,而是按块来的。这个块叫缓存行(Cache Line),主流 CPU 上是 64 字节。也就是说,读一个 long 类型的变量,硬件实际上会把包括它在内的 64 字节一起搬进缓存。
现代的 CPU 缓存通常分三级:
| 层级 | 位置 | 典型容量 | 特点 |
|---|---|---|---|
| L1 | 每个核心独占 | 几十 KB | 最快,通常又分为指令缓存和数据缓存 |
| L2 | 每个核心独占 | 几百 KB 到几 MB | 比 L1 慢,比 L3 快 |
| L3 | 所有核心共享 | 几 MB 到几十 MB | 最慢,但容量最大 |
数据访问的顺序是 L1 → L2 → L3 → 内存,逐级往下找,越往下越慢。这个结构在单核时代没有任何问题,到了多核时代就出了新的麻烦。
多核缓存架构与缓存一致性问题
多核 CPU 里,每个核心都有自己的 L1、L2 缓存。如果核心 A 和核心 B 都要读同一个变量,那么这份变量会同时存在于 A 的缓存和 B 的缓存里。
现在核心 A 修改了这个变量:它改的只是自己缓存里的副本,主内存没有更新,核心 B 的缓存里还是旧值。核心 B 之后再去读,读到的是过期数据——这就是缓存一致性问题。
所以硬件必须提供一套机制,让一个核心的写入对其他核心可见。有两类做法:
- 总线锁:CPU 发出 LOCK 信号,锁住总线,期间其他核心无法访问内存。粒度太粗,开销很大。
- 缓存锁:只锁住被修改的那一行缓存,配合缓存一致性协议,让其他核心的对应副本失效。粒度小,是现代 CPU 的主流做法。
MESI 协议
缓存锁要落地,需要一套描述「每一行缓存当前处于什么状态」的协议,主流实现是 MESI。它给每个缓存行定义了四种状态:
| 状态 | 含义 |
|---|---|
| M(Modified) | 本核心修改过,与主内存不一致,且只有本核心有这份数据 |
| E(Exclusive) | 与主内存一致,且只有本核心有这份数据 |
| S(Shared) | 与主内存一致,多个核心都持有这份数据 |
| I(Invalid) | 缓存行已失效,需要重新从主内存加载 |
状态之间的流转由各核心在总线上「窥探」(Snooping)到的读写事件驱动,几个典型的流转:
- 核心 A 读一个变量,只有它自己持有 → 状态是 E(独占且干净)
- 核心 B 也来读这个变量 → 两边都变成 S(共享)
- 核心 A 要修改它 → A 把自己那行置为 M,并通知 B 把 B 那行置为 I
- 核心 B 之后再读 → 发现自己是 I,必须从主内存(或从 A 的缓存)重新加载
关键点在于:写操作要生效,必须先把其他核心的副本置为无效。这个动作在硬件上是一次 RFO(Request For Ownership)请求——「我要独占这一行,你们都放弃」。等所有其他核心都确认失效之后,写才算完成。
伪共享
MESI 是按缓存行来管理状态的,这带来一个副作用:两个毫无关系的变量,只要落在同一行缓存里,就会被当成一份数据来处理。
class Counter {
    // 两个字段大概率落在同一个缓存行
    volatile long a;
    volatile long b;
}
线程 1 只改 a,线程 2 只改 b,逻辑上互不干扰。但因为在同一行缓存里,线程 1 的写会不断让线程 2 的副本失效,线程 2 的写又反过来让线程 1 失效,两边在总线上反复争夺同一行缓存的独占权。程序逻辑没有共享,性能却被硬件拖垮了——这叫伪共享(False Sharing)。
消除办法就是把热点变量拆到不同的缓存行里去,常见手段是填充(Padding):
class PaddedCounter {
    volatile long value;
    // 用无意义的字段把一行缓存填满,保证 value 独占一行
    long p1, p2, p3, p4, p5, p6, p7;
}
JDK 8 之后提供了更规范的写法,用 @sun.misc.Contended 注解让 JVM 自动完成填充,LongAdder 的内部类就是这么做的。
写缓冲与失效队列
如果每一次写都要等所有核心确认失效,那写操作的延迟会高得离谱。硬件用了两个缓冲来异步化这个过程:
- 写缓冲(Store Buffer):核心把写操作丢进写缓冲就继续往下执行,不必等缓存行真正拿到独占权。乱序的种子就是这里埋下的——写操作的生效时间被推迟了。
- 失效队列(Invalidate Queue):核心收到「你的某行缓存失效了」的通知时,先记在队列里就立刻回 ack,不必马上处理。这让「收到失效通知」和「缓存真的失效」之间有了时间差。
这两个缓冲换来了性能,代价是引入了新的可见性问题:核心 A 的写可能还压在写缓冲里没落盘,核心 B 已经认为 A 写完了;核心 B 收到的失效通知可能还躺在失效队列里没处理,于是它读到的还是旧值。
内存屏障
要恢复可控性,就需要在关键位置插入指令,强制把缓冲里的东西刷出去、或者拦住后面的读写不许越过去。这类指令就是内存屏障(Memory Barrier / Fence)。
x86 架构上主要有三类:
| 指令 | 类型 | 作用 |
|---|---|---|
lfence | 读屏障 | 保证前面的读先于后面的读完成 |
sfence | 写屏障 | 保证前面的写先于后面的写写回 |
mfence | 全屏障 | 兼具读写屏障的能力 |
除了这三条指令,x86 还有一个更常用的手段:lock 前缀。lock addl $0x0, (%rsp) 这样一条看似什么都没干的指令,实际效果是:
- 等待之前的所有指令完成、写缓冲全部写回内存
- 根据缓存一致性协议,让其他核心中对应的缓存副本失效
- 指令本身不允许与前后指令重排序
HotSpot 在 x86 上正是用 lock; addl $0,0(%rsp) 来实现 OrderAccess::fence() 的。而在 ARM 这种弱内存模型架构上,硬件本身允许更多重排序,需要插入的屏障指令也更多——这也是同一段 Java 代码在不同架构上性能表现不同的原因之一。
与 Java 内存模型的关系
硬件层的这些概念,在 Java 里都能找到对应:
| 硬件概念 | Java 中的对应 |
|---|---|
| L1/L2/L3 缓存、写缓冲、寄存器 | JMM 里统称为「工作内存」(本地内存) |
| 主内存 | JMM 里的「主内存」 |
| 缓存一致性协议、总线嗅探 | JMM 未直接暴露,由 JVM 通过屏障指令间接利用 |
| 内存屏障、lock 前缀 | volatile、synchronized、final 背后的实现手段 |
Java 内存模型并没有重新发明一套机制,它做的是屏蔽硬件差异:不管你跑在 x86 还是 ARM 上,volatile 的语义都是确定的,至于底下要插几条屏障指令,那是 JVM 的事。
理解了硬件这一层,回头看 volatile 为什么会禁止重排序、synchronized 为什么会保证可见性,就不再是记忆关键字,而是有据可循了。
CAS与原子操作
CAS-解决并发编程的基石
什么是原子操作?
并发里的原子性和事务中的原子操作是完全一样的概念,假定有两个操作 A 和 B 都包含多个步骤,如果从执行 A 的线程来看, 当另一个线程执行 B 时, 要么将 B 全部执行完, 要么完全不执行 B ,执行 B 的线程看 A 的操作也是一样的, 那么 A 和 B 对彼此来说是原子的。
实现原子操作可以使用锁, 锁机制满足基本的需求是没有问题的了, 但是有的时候我们的需求并非这么简单,我们需要更有效,更加灵活的机制,synchronized 关键字是基于阻塞的锁机制,也就是说当一个线程拥有锁的时候, 访问同一资源的其它线程需要等待,直到该线程释放锁。
使用锁机制实现的原子性可能存在问题: 首先,如果被阻塞的线程优先级很高很重要怎么办?其次, 如果获得锁的线程一直不释放锁怎么办? 同时,还有可能出现一些例如死锁之类的情况, 最后,其实锁机制是一种比较粗糙, 粒度比较大的机制, 相对于像计数器这样的需求有点儿过于笨重。这个时候就需要用到CAS机制。
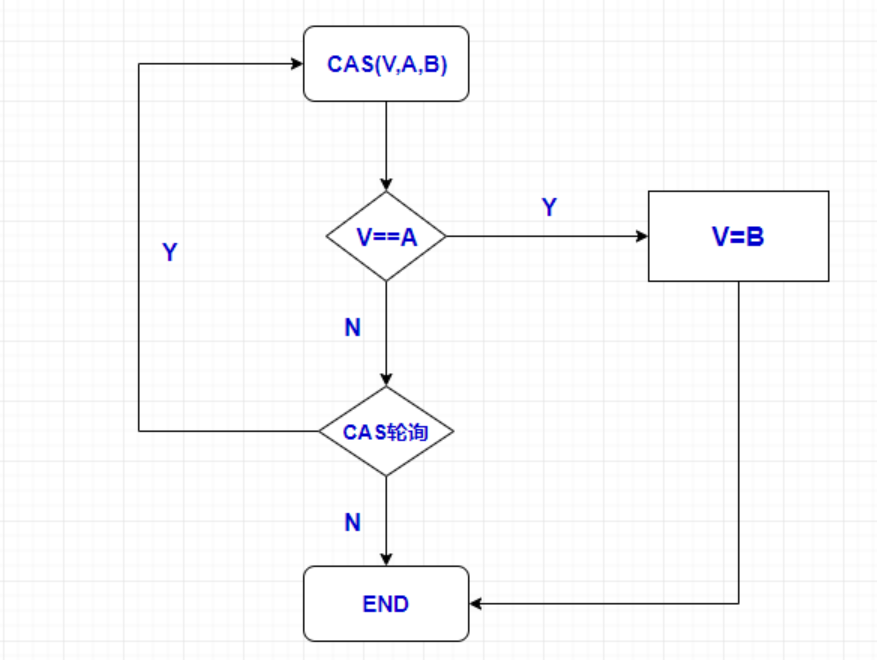
CAS,全称Compare And Swap(比较与交换), CAS(V, A, B),V为内存地址、A为预期原值,B为新值。如果内存地址的值与预期原值相匹配,那么将该位置值更新为新值。否则,说明已经被其他线程更新,处理器不做任何操作;无论哪种情况,它都会在 CAS 指令之前返回该位置的值。而我们可以使用自旋,循环CAS,重新读取该变量再尝试再次修改该变量,也可以放弃操作。
CAS实现原子操作的三大问题
ABA 问题
CAS 在更新前会检查值是否被改动过,若未变则更新。但它只看“当前值”,不关心历史: 如果一个值从 A → B → 又变回 A,CAS 会误以为“没变过”,从而错误地认为可以安全更新,这就是 ABA 问题。
解决方法:给变量加一个递增的版本号(stamp)。 每次修改都同时更新版本号,序列就变成: 1A → 2B → 3A 即使值又回到 A,版本号不同,CAS 就能识别出中间被改过。
通俗比喻: 你桌上一杯水,走开一趟回来发现水还在,就直接喝了 —— 这就是典型的 ABA 问题(你以为没人动,其实被同事喝光又续满了一杯)。
而讲卫生的程序员会这样做: 放杯子时在旁边贴张纸条写上 “0”。 规定:谁动水就必须先把数字加 1。 你回来一看纸条上写着 “2”,哪怕水还是满的,你也知道:这杯水已经“脏”了,不能喝了。
Java 直接提供了这个机制:
AtomicStampedReference<V>(值 + int 版本号)AtomicMarkableReference<V>(值 + boolean 标记位,简化版)
用它们实现 CAS,就彻底杜绝 ABA 问题。
循环时间长开销大
自旋 CAS 如果长时间不成功,会给 CPU 带来非常大的执行开销。
只能保证一个共享变量的原子操作
CAS 原生只能保证单个共享变量的原子性。
- 对单个变量,可通过循环 CAS(自旋)实现原子更新。
- 对多个共享变量,循环 CAS 无法保证整体原子性,此时需使用锁。
- 替代方案:将多个共享变量合并为一个对象,通过
AtomicReference<V>对该对象整体进行 CAS,从而实现多变量的复合原子操作。
Java 1.5 引入的 AtomicReference 正是为此设计:把任意数量的变量封装进一个对象,用一次引用 CAS 完成“多字段”原子更新,巧妙规避了传统锁。
JDK 中相关原子操作类的使用
以AtomicInteger为例:
| 方法 | 功能描述 | 返回值含义 |
|---|---|---|
int addAndGet(int delta) | 原子地将 delta 加到当前值,返回加后的结果 | 新值 |
int getAndAdd(int delta) | 原子地将 delta 加到当前值,返回加前的旧值 | 旧值 |
boolean compareAndSet(int expect, int update) | 如果当前值 == expect,则原子更新为 update | 是否更新成功(true/false) |
int getAndIncrement() | 原子自增(+1),返回自增前的值 | 旧值(等价于 i++) |
int incrementAndGet() | 原子自增(+1),返回自增后的值 | 新值(等价于 ++i) |
int getAndSet(int newValue) | 原子地将值设为 newValue,返回设置前的旧值 | 旧值 |
CAS 实现机制深度解析
硬件原子指令实现CAS
不支持原子指令的硬件: - 早期的简单处理器(如 8086、某些 8 位微控制器)没有原生的原子指令。 一些低端嵌入式系统(如老式 AVR 或 PIC 微控制器)缺乏硬件支持。 某些特殊用途处理器可能故意省略复杂指令以简化设计。
现代处理器几乎都支持原子指令,因为多核和并发是标配。但在极低功耗或极简设计的场景中,硬件可能不提供。
主流架构的CAS实现
x86/x86_64架构
- 核心指令:
cmpxchg(Compare and Exchange) - 关键机制:
lock前缀确保原子性 - 汇编示例:asm修正说明:原示例缺少
mov eax, [expected] ; 加载期望值 lock cmpxchg [ptr], desired ; 原子比较并交换 setz al ; 设置操作结果标志setz al指令,需补充返回值设置
ARM架构
- 指令对:
ldrex和strex(Load-Exclusive/Store-Exclusive) - 乐观锁机制:通过本地监视器检测并发冲突asm
ldrex r1, [ptr]         ; 加载当前值并标记监视器
cmp r1, expected        ; 比较值
bne fail                ; 不相等则失败
strex r2, desired, [ptr]; 尝试存储新值
cmp r2, #0              ; 检查是否成功(0表示成功)
beq success             ; 成功跳转
fail:
编译器支持
- GCC/Clang等编译器通过
__atomic内置函数生成架构优化指令 - 示例:
__atomic_compare_exchange_n会映射到cmpxchg或ldrex/strex
硬件原子指令支持现状
| 架构 | 原子指令支持 | 关键特性 |
|---|---|---|
| x86/x86_64 | cmpxchg, lock前缀 | 支持字节/字/双字/四字操作 |
| ARMv6+ | ldrex/strex | 需配合内存屏障使用 |
| RISC-V | AMO指令(A扩展) | 支持原子加减/逻辑运算 |
| PowerPC | lwarx/stwcx. | 需配合cmp指令完成CAS逻辑 |
硬件原子性实现关键技术
三大核心技术:原子指令集、缓存一致性协议、内存屏障。
原子指令集
- x86的
LOCK前缀会:- 锁定总线直至指令完成
- 阻塞其他核心的缓存访问
- ARM的
ldrex/strex通过本地监视器实现:- 加载时标记缓存行独占
- 存储时验证独占状态
缓存一致性协议(MESI)
当CPU执行原子操作(如LOCK CMPXCHG)时,MESI协议会将目标缓存行状态从Shared(S)提升至Exclusive(E)或Modified(M),此时其他核心的相同缓存行会被标记为Invalid(I),形成硬件级互斥锁
内存屏障(Memory Barrier)
强制原子写操作结果对其他核可见,保证原子读操作后的加载顺序,阻止所有指令重排序。
硬件没有原子指令实现CAS
| 平台/时代 | 实现方式 | 原理/代价 |
|---|---|---|
| 早期 x86(386/486 无 CMPXCHG) | 用 XCHG 指令(隐含 LOCK)或 .byte 0xF0,0x0F,0xB0,... 强制总线锁 | XCHG 本身总是带 LOCK,拿它模拟 CAS,但逻辑复杂、性能差 |
| 单核或无 SMP 的机器 | 直接关闭中断(CLI/STI) | 最简单:禁止中断 = 禁止抢占 = 单线程串行执行 → 天然原子,但不支持多核 |
| 早期 PowerPC、MIPS、SPARC | LL/SC(Load-Linked / Store-Conditional)序列 + 总线仲裁 | 硬件虽提供 LL/SC,但若无 CAS,内核用总线锁或全局自旋锁包装成 CAS 接口 |
| 所有没有硬件 CAS 的多核系统(最通用做法) | 操作系统提供的原子原语(内核态总线锁) | 用户态调用系统调用(如 Linux 的 futex、cmpxchg 模拟)或 rt_mutex,内核用总线锁或大内核锁(Big Kernel Lock)实现真正原子性 |
Java中的CAS实现
Java层(Unsafe)
jdk/src/share/classes/sun/misc/Unsafe.java
JVM native实现(HotSpot)
查看链接:https://hg.openjdk.org/jdk8/jdk8/hotspot/file/87ee5ee27509/src/share/vm/prims/unsafe.cpp
搜索:CompareAndSwapLong
核心代码:
Atomic::cmpxchg(x, addr, e)真正汇编实现(CPU相关)
查看链接:https://hg.openjdk.org/jdk8/jdk8/hotspot/file/87ee5ee27509/src/cpu/x86/vm/x86_64.ad
搜索:CompareAndSwapL
实现代码:
instruct compareAndSwapL(rRegI res,
                         memory mem_ptr,
                         rax_RegL oldval, rRegL newval,
                         rFlagsReg cr)
%{
  predicate(VM_Version::supports_cx8());
  match(Set res (CompareAndSwapL mem_ptr (Binary oldval newval)));
  effect(KILL cr, KILL oldval);

  format %{ "cmpxchgq $mem_ptr,$newval\t# "
            "If rax == $mem_ptr then store $newval into $mem_ptr\n\t"
            "sete    $res\n\t"
            "movzbl  $res, $res" %}
  opcode(0x0F, 0xB1);
  ins_encode(lock_prefix,
             REX_reg_mem_wide(newval, mem_ptr),
             OpcP, OpcS,
             reg_mem(newval, mem_ptr),
             REX_breg(res), Opcode(0x0F), Opcode(0x94), reg(res), // sete
             REX_reg_breg(res, res), // movzbl
             Opcode(0xF), Opcode(0xB6), reg_reg(res, res));
  ins_pipe( pipe_cmpxchg );
%}
解释:
instruct compareAndSwapL(
    rRegI res,          // 返回值:1 表示成功,0 表示失败(boolean)
    memory mem_ptr,     // 要操作的内存地址
    rax_RegL oldval,    // 预期值,必须预先放在 RAX 寄存器(x86 cmpxchg 硬件要求)
    rRegL newval,       // 要写入的新值
    rFlagsReg cr        // 影响 ZF 标志位,用于判断是否成功
)
predicate(VM_Version::supports_cx8()); 只有 CPU 支持 CMPXCHG8B(即支持 64 位原子操作)才启用此指令。
对应 Java 中 Unsafe.compareAndSwapLong 返回 boolean 的版本:
match(Set res (CompareAndSwapL mem_ptr (Binary oldval newval)));生成的真实汇编(核心就两行):
LOCK CMPXCHGQ [mem_ptr], newval     ; 原子比较并交换
SETE al                              ; 如果相等(成功),把 1 写入 al
MOVZBL res, al                       ; 把 al 零扩展到 32 位返回
必须 LOCK 前缀 → 保证多核原子性
成功时:ZF=1,内存被写入 newval,RAX 仍为 oldval。
失败时:ZF=0,RAX 被更新为内存当前实际值(这就是为什么 CAS 失败后要重试时直接用 RAX 里的值)。
最后用 SETE + MOVZBL 把成功/失败转成 0/1 返回给 Java。
LOCK 前缀 = 告诉 CPU:“我要独占这 64 字节缓存行,别的核在我的指令完成前,一律不准碰它!”
具体过程(现代 Intel/AMD CPU,2010 年以后)
- 你执行一条带 LOCK 前缀的指令 例如:lock cmpxchg [addr], rax
- 当前核立刻向总线发出 RFO(Request For Ownership) 请求 → 意思是“我要独占(Ownership)addr 所在的缓存行”
- 所有其他核收到这个请求后,强制把自己的同一缓存行设为 Invalid → 哪怕它们正准备读或写,也必须立刻放弃
- 当前核拿到独占权后,只有它一个人能修改这 64 字节 → 整个 cmpxchg 指令期间,没有任何其他核能干扰
- 指令执行完后,当前核把新值写回,并解除独占 → 其他核重新可以访问
这整个过程由硬件(MESI 协议 + 总线仲裁)在几十纳秒内自动完成,不需要操作系统、也不需要锁总线,只锁一行缓存,所以极快。
参考链接
在线查看JDK源码:https://hg.openjdk.org/jdk8/jdk8/hotspot/file
JSR133:http://ifeve.com/wp-content/uploads/2014/03/JSR133中文版.pdf
思考题
volatile可以解决原子性的问题吗?
核心篇
什么是并发编程?
为什么学习并发编程?
- 并发无处不在,是构建高性能应用的基础,是阅读开源代码的基础
- 企业面试的核心
并发编程有什么难点?
- 并发编程涉及到计算机的知识面非常广,数据结构,计算机组成原理,内存、操作系统,JVM,CPU等都需要一定的了解;
- 如果要了解底层的实现原理,必然要阅读一些C/C++代码,这对大部分Java程序员也是不友好的;
- 在缺乏知识体系的情况下,很多概念理解起来会非常抽象和难以理解,例如 happen-before;
- 对JSR的不了解,导致不理解有些概念是怎么来的,例如volatile关键字的作用;
- 网上的资料虽然很多,但缺少从全局的角度介绍某些概念的来源。例如,Java 里 synchronized、wait()/notify() 相关的知识很琐碎,看懂难,会用更难。但实际上 synchronized、wait()、notify() 不过是操作系统领域里管程模型的一种实现而已,Java SDK 并发包里的条件变量 Condition 也是管程里的概念,synchronized、wait()/notify()、条件变量这些知识如果单独理解,自然是管中窥豹。但是如果站在管程这个理论模型的高度,你就会发现这些知识原来这么简单,同时用起来也就得心应手了。
如何学习并发编程?
跳出来,看全景,钻进去,看本质。
学习最忌讳的就是“盲人摸象”,只看到局部,而没有看到全局。所以,需要从一个个单一的知识和技术中“跳出来”,高屋建瓴地看并发编程。当然,这首要之事就是你建立起一张全景图。
但是光跳出来还不够,还需要下一步,就是在某个问题上钻进去,深入理解,找到本质。对知识点不是浅尝辄止,知其然知其所以然,才算真的学明白了。
并发编程的核心问题
并发编程领域可以抽象成三个核心问题:分工、同步和互斥。
分工指的是:将大的问题拆分成互不相干的子问题。
同步指的是:线程与线程之间存在依赖关系。
互斥指的是:对共享资源访问的顺序。
你会发现所有并发编程中的概念、关键字、工具类都是围绕这三个方面展开的。
什么是线程安全问题?
在进入并发编程的技术细节之前,先看一个例子。它足够简单,简单到你会觉得「这不可能出问题」——而这正是线程安全问题最迷惑人的地方。
从一个计数器开始
观察下面的程序,你觉得它会输出什么?
public class Counter {

    private int count = 0;

    public void increment() {
        count++;
    }

    public int getCount() {
        return count;
    }

    public static void main(String[] args) throws InterruptedException {
        Counter counter = new Counter();
        Runnable task = () -> {
            for (int i = 0; i < 1000; i++) {
                counter.increment();
            }
        };

        Thread t1 = new Thread(task);
        Thread t2 = new Thread(task);
        t1.start();
        t2.start();

        // 等待两个线程执行完
        t1.join();
        t2.join();

        System.out.println("最终计数: " + counter.getCount()); // 期待输出 2000
    }
}
两个线程各做 1000 次自增,没有任何共享之外的操作,直觉上结果应该是 2000。
但多运行几次,你会发现结果几乎每次都不一样——可能是 1873,可能是 1994,极少数情况下才是 2000。而且每次运行的结果都不确定。
这就是线程安全问题:程序在多线程环境下运行,结果产生了错误。注意关键词是「可能」——它不一定错,但错的时候你毫无察觉。这类问题在测试环境往往复现不了,一上线就在生产环境以数据错乱的形式暴露出来。
为什么 count++ 会出错
问题出在 count++ 这行看起来「一步」的代码上。它实际上是三步:
1. 读取 count 的当前值到寄存器   (read + load)
2. 寄存器里的值加 1              (计算)
3. 把结果写回 count              (assign + store)
两个线程交错执行时,就会出现丢失更新的情况:
时刻  线程 A                    线程 B                  count
─────────────────────────────────────────────────────────────
T1    读取 count = 5                                     5
T2                              读取 count = 5           5
T3    计算 5 + 1 = 6                                     5
T4                              计算 5 + 1 = 6           5
T5    写回 count = 6                                     6
T6                              写回 count = 6           6   ← 丢了 1 次自增
两次自增,最终只加了 1。线程 A 和线程 B 各读到了 5,各写回了 6,其中一个的结果被覆盖掉了。
还有更隐蔽的情况——第 1 步读到的值可能压根不是最新的。如果线程 A 改完 count 之后,线程 B 读到的还是自己缓存里的旧值,那它接下来的整个计算都是基于过期数据做的。
这两种失效方式,对应着并发编程里两个不同的底层原因:
- 原子性被破坏:
count++的读-改-写三步被打断(上面那个丢失更新的例子) - 可见性被破坏:一个线程的修改,另一个线程看不到
再加上第三个——有序性:编译器和处理器为了优化性能,会重排指令顺序,导致代码的实际执行顺序和你写的不一样。
这三个词——可见性、原子性、有序性——就是「并发三大特性」,也是所有线程安全问题的根源。下一节会把它们逐一拆开,看每一类问题是怎么产生的,以及 Java 分别提供了什么手段来应对。
产生线程安全问题的根源是什么?
并发三大特性
要理解产生这个问题的原因,我们就需要对并发三大特性有所了解。
并发三大特性指的是:可见性、有序性、原子性。
可见性
在单核时代,所有的线程都是在一颗 CPU 上执行,CPU 缓存与内存的数据一致性容易解决。因为所有线程都是操作同一个 CPU 的缓存,一个线程对缓存的写,对另外一个线程来说一定是可见的。例如在下面的图中,线程 A 和线程 B 都是操作同一个 CPU 里面的缓存,所以线程 A 更新了变量 V 的值,那么线程 B 之后再访问变量 V,得到的一定是 V 的最新值(线程 A 写过的值)。
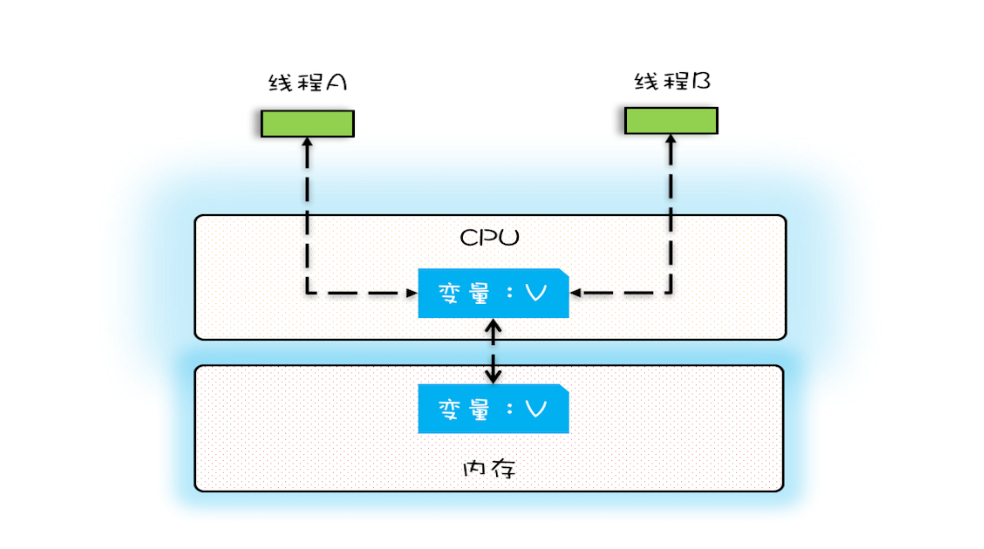
一个线程对共享变量的修改,另外一个线程能够立刻看到,我们称为可见性。
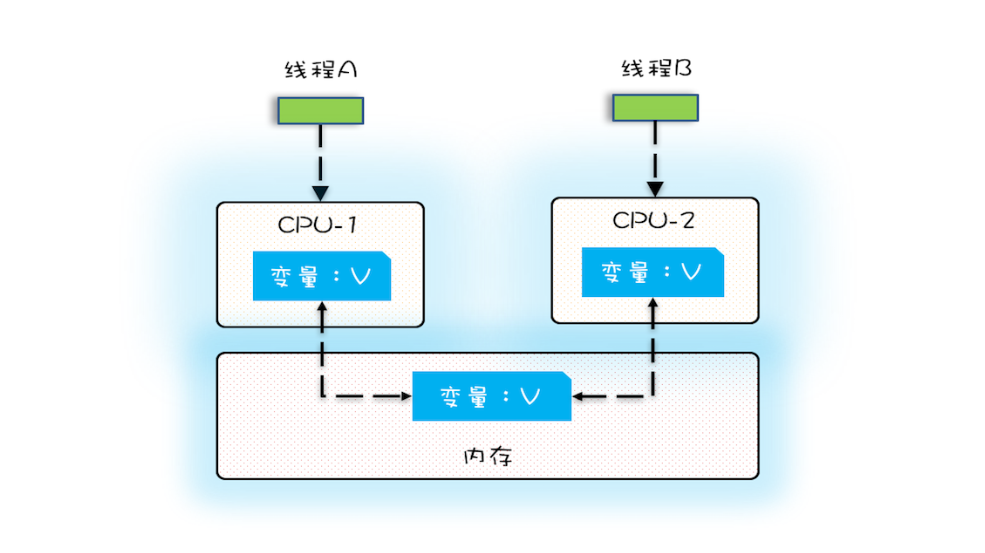
多核时代,每颗 CPU 都有自己的缓存,这时 CPU 缓存与内存的数据一致性就没那么容易解决了,当多个线程在不同的 CPU 上执行时,这些线程操作的是不同的 CPU 缓存。比如下图中,线程 A 操作的是 CPU-1 上的缓存,而线程 B 操作的是 CPU-2 上的缓存,很明显,这个时候线程 A 对变量 V 的操作对于线程 B 而言就不具备可见性了。这个就属于硬件程序员给软件程序员挖的“坑”。
原子性
由于 IO 太慢,早期的操作系统就发明了多进程,即便在单核的 CPU 上我们也可以一边听着歌,一边写 Bug,这个就是多进程的功劳。
操作系统允许某个进程执行一小段时间,例如 50 毫秒,过了 50 毫秒操作系统就会重新选择一个进程来执行(我们称为“任务切换”),这个 50 毫秒称为“时间片”。
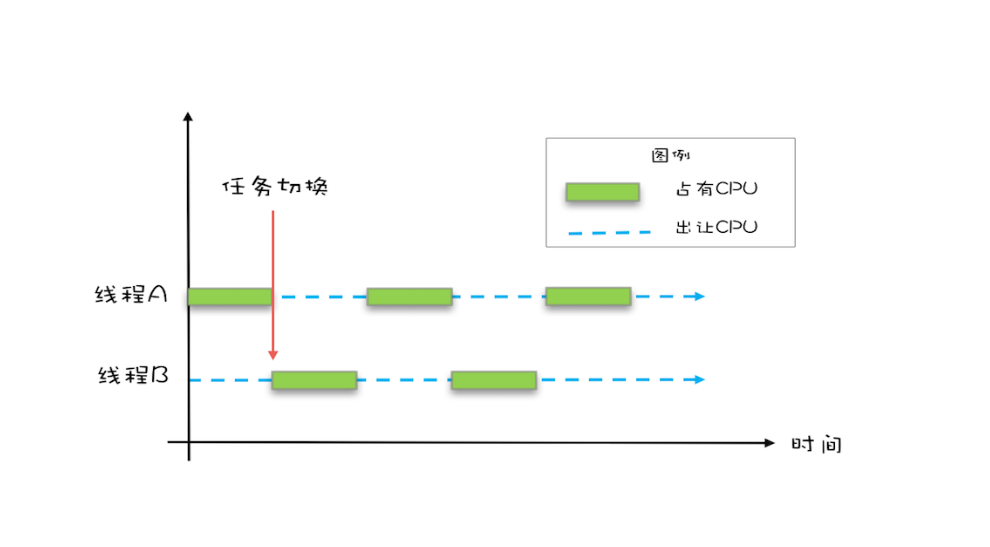
在一个时间片内,如果一个进程进行一个 IO 操作,例如读个文件,这个时候该进程可以把自己标记为“休眠状态”并出让 CPU 的使用权,待文件读进内存,操作系统会把这个休眠的进程唤醒,唤醒后的进程就有机会重新获得 CPU 的使用权了。
这里的进程在等待 IO 时之所以会释放 CPU 使用权,是为了让 CPU 在这段等待时间里可以做别的事情,这样一来 CPU 的使用率就上来了;此外,如果这时有另外一个进程也读文件,读文件的操作就会排队,磁盘驱动在完成一个进程的读操作后,发现有排队的任务,就会立即启动下一个读操作,这样 IO 的使用率也上来了。
Java 并发程序都是基于多线程的,自然也会涉及到任务切换,任务切换的时机大多数是在时间片结束的时候,我们现在基本都使用高级语言编程,高级语言里一条语句往往需要多条 CPU 指令完成,例如上面代码中的count += 1,至少需要三条 CPU 指令。
指令 1:首先,需要把变量 count 从内存加载到 CPU 的寄存器;
指令 2:之后,在寄存器中执行 +1 操作;
指令 3:最后,将结果写入内存(缓存机制导致可能写入的是 CPU 缓存而不是内存)。
操作系统做任务切换,可以发生在任何一条 CPU 指令执行完,是的,是 CPU 指令,而不是高级语言里的一条语句。对于上面的三条指令来说,我们假设 count=0,如果线程 A 在指令 1 执行完后做线程切换,线程 A 和线程 B 按照下图的序列执行,那么我们会发现两个线程都执行了 count+=1 的操作,但是得到的结果不是我们期望的 2,而是 1。
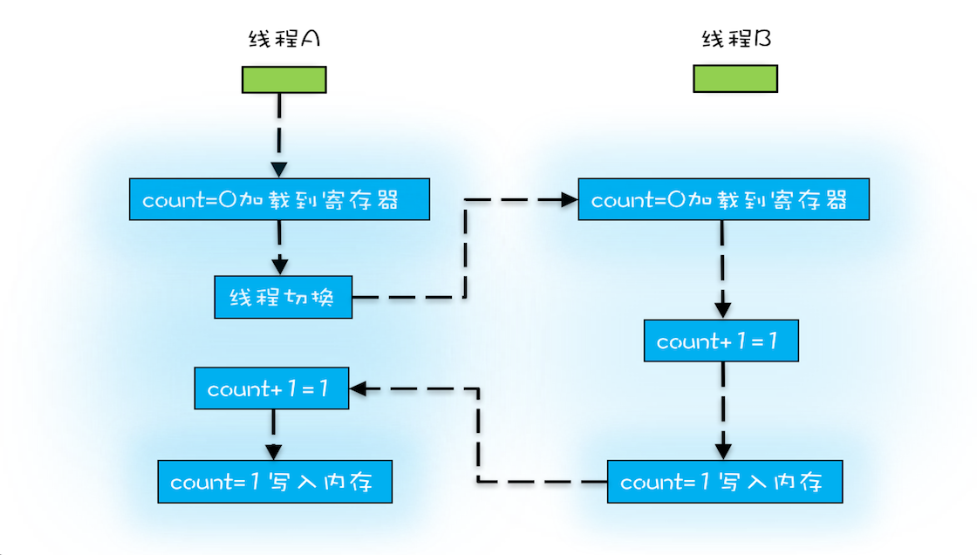
我们潜意识里面觉得 count+=1 这个操作是一个不可分割的整体,就像一个原子一样,线程的切换可以发生在 count+=1 之前,也可以发生在 count+=1 之后,但就是不会发生在中间。我们把一个或者多个操作在 CPU 执行的过程中不被中断的特性称为原子性。CPU 能保证的原子操作是 CPU 指令级别的,而不是高级语言的操作符,这是违背我们直觉的地方。因此,很多时候我们需要在高级语言层面保证操作的原子性。
原子性的例子:
public class AtomicityTest {

    private int count = 0;

    public void increment() {
        count++;
    }

    public int getCount() {
        return count;
    }

    public static void main(String[] args) throws InterruptedException {
        AtomicityTest counter = new AtomicityTest();
        Runnable task = () -> {
            for (int i = 0; i < 1000; i++) {
                counter.increment();
            }
        };

        Thread t1 = new Thread(task);
        Thread t2 = new Thread(task);
        t1.start();
        t2.start();

        // 等待两个线程执行完
        t1.join();
        t2.join();

        System.out.println("最终计数: " + counter.getCount()); // 期待输出 2000
    }
}
有序性
有序性指的是程序按照代码的先后顺序执行。编译器为了优化性能,有时候会改变程序中语句的先后顺序,例如程序中:“a=6;b=7;”编译器优化后可能变成“b=7;a=6;”,在这个例子中,编译器调整了语句的顺序,但是不影响程序的最终结果。不过有时候编译器及解释器的优化可能导致意想不到的 Bug。
public class OrderingTest {

    // volatile 防止指令重排序
    private volatile static OrderingTest singleDcl = null;

    private static OrderingTest getInstance() {
        if (singleDcl == null) {
            synchronized (SingleDcl.class) {
                if (singleDcl == null) {
                    // 1.开辟内存空间
                    // 2.对象初始化
                    // 3.singleDcl指向内存空间的地址
                    singleDcl = new OrderingTest();
                }
            }
        }
        return singleDcl;
    }
}
为什么会出现指令重排序?
计算机在执行程序时,为了提高性能,编译器和处理器常常会对指令做重排。
为什么指令重排序可以提高性能?
简单地说,每一个指令都会包含多个步骤,每个步骤可能使用不同的硬件。因此,流水线技术产生了,它的原理是指令1还没有执行完,就可以开始执行指令2,而不用等到指令1执行结束之后再执行指令2,这样就大大提高了效率。
但是,流水线技术最害怕中断,恢复中断的代价是比较大的,所以我们要想尽办法不让流水线中断。指令重排就是减少中断的一种技术。
a = b + c;
d = e - f ;先加载b、c(注意,即有可能先加载b,也有可能先加载c),但是在执行add(b,c)的时候,需要等待b、c装载结束才能继续执行,也就是增加了停顿,那么后面的指令也会依次有停顿,这降低了计算机的执行效率。
为了减少这个停顿,我们可以先加载e和f,然后再去加载add(b,c),这样做对程序(串行)是没有影响的,但却减少了停顿。既然add(b,c)需要停顿,那还不如去做一些有意义的事情。
综上所述,指令重排对于提高CPU处理性能十分必要。虽然由此带来了乱序的问题,但是这点牺牲是值得的。
指令重排一般分为以下三种:
编译器优化重排
编译器在不改变单线程程序语义的前提下,可以重新安排语句的执行顺序。
指令并行重排
现代处理器采用了指令级并行技术来将多条指令重叠执行。如果不存在数据依赖性(即后一个执行的语句无需依赖前面执行的语句的结果),处理器可以改变语句对应的机器指令的执行顺序。
内存系统重排
由于处理器使用缓存和读写缓存冲区,这使得加载(load)和存储(store)操作看上去可能是在乱序执行,因为三级缓存的存在,导致内存与缓存的数据同步存在时间差。
指令重排可以保证串行语义一致,但是没有义务保证多线程间的语义也一致。所以在多线程下,指令重排序可能会导致一些问题。
如何解决线程安全问题?
Java 语言层面
- 原子性:单个变量用 JUC 原子类(AtomicInteger、AtomicLong 等);任意代码段用 synchronized 或 ReentrantLock。
- 可见性:volatile、synchronized、Lock、final、static 以及所有 JUC 并发工具均保证。
- 有序性:volatile、synchronized、Lock、final、static 均禁止编译器和处理器重排序。
JVM 底层实现
- 原子性:原子类依赖单指令 LOCK CMPXCHG(CAS),synchronized 依赖 monitorenter/monitorexit 结合偏向锁/轻量锁/重量锁。
- 可见性:写线程在 volatile 通过内存屏障失效本地缓存;synchronized 和 Lock 通过内存屏障,配合 MESI 协议+缓存锁/总线锁实现。
- 有序性:volatile 写插入 StoreLoad 屏障,volatile 读插入 LoadLoad + LoadStore 屏障,synchronized/Lock/final 插入全屏障,彻底阻止重排序。
开发者层面
- happens-before
总结
Java 层通过关键字和 JUC 工具提供简洁接口
JVM 层通过内存屏障、LOCK 前缀指令和 MESI 缓存一致性协议真正保障原子性、可见性与有序性。
提供 happens-before 原则帮助开发者判断编写的程序是否有并发安全问题。
Jvm是如何解决线程安全问题的?
上一节说清楚了问题的根源:可见性、原子性、有序性。接下来的问题是,Java 语言层面给出了 volatile、synchronized 这些关键字,它们背后的 JVM 到底做了什么,才能让这些关键字在不同的 CPU 上有统一的行为?答案就是 Java 内存模型(Java Memory Model,JMM)。
JMM 的由来
编程语言其实可以直接复用操作系统的内存模型,但不同的操作系统内存模型不一样。直接复用会导致同一份代码换个系统就行为不同——而 Java 的立身之本就是跨平台,所以它必须自己提供一套内存模型来屏蔽系统差异。
这就是 JMM 存在的第一个理由。把它说得更准确一点:JMM 不是一块内存,而是 Java 定义的一组并发规范(JSR-133)。它除了抽象出线程与主内存的关系,还规定了从 Java 源码到 CPU 可执行指令这个转化过程中,必须遵守哪些并发相关的原则。目的很明确:简化多线程编程,增强程序的可移植性。
主内存与工作内存
JMM 的核心是它定义的抽象关系:所有共享变量存在主内存,每个线程有一个私有的本地内存,本地内存里放的是共享变量的副本。
- 主内存:所有线程创建的实例对象都在这里,不管是成员变量还是局部变量,类信息、常量、静态变量也都放这儿。为了更快的访问速度,虚拟机和硬件系统可能让工作内存优先落在寄存器和高速缓存里。
- 本地内存:每个线程私有的抽象概念,存的是该线程读写的共享变量副本。它并不真实存在,涵盖的是缓存、写缓冲区、寄存器以及其他的硬件和编译器优化。
从这张抽象图里能得到两条关键结论:
- 所有共享变量都存在主内存;
- 每个线程都保存了一份自己用到的共享变量的副本。
所以线程 A 和线程 B 要通信,必须走两步:
- 线程 A 把本地内存中更新过的共享变量刷新到主内存;
- 线程 B 到主内存去读取这个更新过的值(或者,根据协议让本地副本失效后重新加载)。
线程之间无法直接互相访问工作内存,通信必须经过主内存。 这解释了为什么两个线程对着同一个变量写,对方却可能看不见——它们各自改的是自己那份副本。
八种交互操作
一个变量怎么从主内存拷到工作内存、又怎么同步回去,JMM 定义了八种原子操作来描述:
| 操作 | 作用对象 | 含义 |
|---|---|---|
lock(锁定) | 主内存变量 | 把一个变量标识为一条线程独占 |
unlock(解锁) | 主内存变量 | 释放锁定状态,释放后其他线程才能锁定它 |
read(读取) | 主内存变量 | 把变量值从主内存传到工作内存,供后续 load 使用 |
load(载入) | 工作内存变量 | 把 read 得到的值放进工作内存的变量副本 |
use(使用) | 工作内存变量 | 把变量值传给执行引擎 |
assign(赋值) | 工作内存变量 | 把执行引擎接收到的值赋给工作内存变量 |
store(存储) | 工作内存变量 | 把工作内存的值传送到主内存,供后续 write 使用 |
write(写入) | 主内存变量 | 把 store 传来的值写入主内存变量 |
这些操作本身是原子的,但它们之间还必须满足一些规则:
read和load、store和write必须按顺序执行且不允许单独出现(不允许读了不载入,也不允许存了不写入)- 不允许丢弃最近的
assign操作——工作内存改了就必须同步回主内存 - 不允许无原因地把数据从工作内存同步回主内存(没发生过
assign就不该store) - 新变量只能在主内存诞生,
use和store之前必须先执行过assign和load - 同一个变量同一时刻只允许一条线程
lock,但同一条线程可以重复lock多次,必须执行相同次数的unlock才真正解锁(这就是锁可重入的规范来源) lock会清空工作内存中该变量的值,用之前必须重新load或assign- 没有
lock过的变量不允许unlock,也不允许unlock别人锁住的变量 unlock之前必须先把变量同步回主内存
有一点容易混淆:问到「Java 内存模型」时,面试官想问的通常是多线程和并发,而不是堆、栈、GC 那套内存结构。两者名字像,说的完全是两回事。
三大特性在 JMM 中如何落地
原子性
一个或多个操作要么全部执行且不被任何因素打断,要么全部不执行。Java 中基本数据类型的读取和赋值是原子操作(64 位处理器下 long/double 也是),但 i++ 这种复合操作不是——它包含读、加、写三步,多线程下必然出错。
保证手段有三个层次:synchronized、Lock 锁,以及 CAS。CAS 我们已经在前面单独讲过,它依赖硬件原子指令,是原子类的基石。
可见性
一个线程修改变量后,其他线程能立即看到。底层有两条实现路径:
- 内存屏障:
volatile、synchronized、Thread.sleep(10)都走这条 - CPU 上下文切换:
Thread.yield()、Thread.sleep(0)这类让出 CPU 的操作,会顺带让其他线程看到更新的值
实现可见性的关键字有 volatile、synchronized、Lock,final 的可见性则由 JMM 的初始化安全性保证。
有序性
程序按代码先后顺序执行。为了性能,编译器和处理器都会做指令重排序,所以存在有序性问题。保证手段是 volatile、内存屏障、synchronized 和 Lock。
锁的内存语义
加锁和解锁不只是互斥,它还带着内存语义:
- 线程获取锁时,JMM 会把这个线程对应的本地内存置为无效
- 线程释放锁时,JMM 会把本地内存中的共享变量刷新到主内存
所以 synchronized 的可见性不是额外赠品,而是锁语义的一部分:进入同步块必须重新从主内存读,离开同步块必须把改动写回主内存。
volatile 的内存语义
volatile 有两件事:保证内存可见性、禁止重排序。
- 写一个 volatile 变量:JMM 会把该线程本地内存中的共享变量值刷新到主内存
- 读一个 volatile 变量:JMM 会把该线程的本地内存置为无效,接下来从主内存重新读
这两句话比它的实际作用要窄。真正关键的是「禁止重排序」这一半,它是 JSR-133 才补上的——Java 5 才开始有「增强的 volatile 内存语义」。
在 JSR-133 之前,volatile 变量和普通变量之间是允许重排序的,于是下面这个经典的例子会出问题:
public class VolatileExample {
    int a = 0;
    volatile boolean flag = false;

    public void writer() {
        a = 1;        // step 1
        flag = true;  // step 2
    }

    public void reader() {
        if (flag) {          // step 3
            System.out.println(a);  // step 4
        }
    }
}
如果 step 1 和 step 2 被重排序,执行时序可能变成:线程 A 先写 flag(step 2),线程 B 读到 flag 为 true(step 3),然后读到 a = 0(step 4),最后线程 A 才写 a = 1(step 1)。volatile 变量本身可见,普通变量却读错了。
JSR-133 因此严格限制 volatile 与普通变量之间的重排序。规则可以总结成三条:
- 第二个操作是 volatile 写时,不管第一个操作是什么,都不能重排序
- 第一个操作是 volatile 读时,不管第二个操作是什么,都不能重排序
- 第一个操作是 volatile 写、第二个操作是 volatile 读时,不能重排序
反过来说,第一个是普通变量读、第二个是 volatile 读,这种是可以重排序的:
int a = 0;                     // 普通变量
volatile boolean flag = false; // volatile 变量

// 这两个读操作允许重排序
int i = a;
boolean j = flag;
双重检查锁为什么需要 volatile
这是 volatile 禁止重排序最经典的应用场景。下面这个写法是错误的:
public class Singleton {

    private static Singleton singleton;   // 少了 volatile

    public static Singleton getSingleton() {
        if (singleton == null) {
            synchronized (Singleton.class) {
                if (singleton == null) {
                    singleton = new Singleton();
                }
            }
        }
        return singleton;
    }
}
问题出在 singleton = new Singleton() 这行,它其实是三步伪代码:
memory = allocate();   // 1. 分配对象内存空间
ctorInstance(memory);  // 2. 初始化对象
singleton = memory;    // 3. 设置 singleton 指向刚分配的内存地址
2 和 3 之间可以重排序。重排之后变成:
memory = allocate();   // 1. 分配内存
singleton = memory;    // 3. 先让 singleton 指向内存地址(对象还没初始化!)
ctorInstance(memory);  // 2. 才初始化对象
这时候线程 B 进到第一个 if (singleton == null),发现 singleton 已经不为 null,直接返回——拿到的是一个构造到一半的对象。
加上 volatile 就是为了禁止这个重排序:
private volatile static Singleton singleton;JMM 的内存屏障插入策略
编译器是通过在字节码指令序列里插入内存屏障来禁止特定类型的处理器重排序的。JMM 给出的策略比较保守:
- 每个 volatile 写操作前面插入 StoreStore 屏障
- 每个 volatile 写操作后面插入 StoreLoad 屏障
- 每个 volatile 读操作后面插入 LoadLoad 屏障
- 每个 volatile 读操作后面再插入 LoadStore 屏障
保守的意思是:在任何处理器平台上、任何程序里,这套策略都能得到正确的 volatile 语义。
但不同处理器的内存模型松紧程度不同,可以在此基础上优化。以 x86 为例,x86 本身不会对读-读、读-写、写-写做重排序,所以这三类屏障在 x86 上会被省略,只保留写-读这一类。这也是为什么同一段并发代码在不同架构上性能表现不一样。
HotSpot 在 x86 上实现屏障用的是 lock 前缀指令而非 mfence——因为 mfence 在某些场景下更慢:
inline void OrderAccess::storeload()  { fence(); }
inline void OrderAccess::fence() {
  if (os::is_MP()) {
    // always use locked addl since mfence is sometimes expensive
#ifdef AMD64
    __asm__ volatile ("lock; addl $0,0(%%rsp)" : : : "cc", "memory");
#else
    __asm__ volatile ("lock; addl $0,0(%%esp)" : : : "cc", "memory");
#endif
  }
}
lock 前缀指令做了三件事:
- 确保后续指令执行的原子性(新处理器上用缓存锁定而非锁总线,开销小得多)
- 具有类似内存屏障的功能,禁止该指令与前后读写指令重排序
- 等待它之前的所有指令完成、所有写缓冲写回内存之后才开始执行,并按缓存一致性协议让其他核心的副本失效
总结
volatile 保证多线程下共享变量的可见性、禁止指令重排序;synchronized 除了可见性还保证原子性(互斥性)。再往下,JMM 通过内存屏障实现可见性和禁止重排序。
为了让程序员不必直接面对重排序规则和屏障指令,JMM 又提供了 happens-before 这套更易懂的规则——这是下一节的内容。
happens-before:如何判断程序有没有并发安全问题
上一节讲了 JMM 靠内存屏障来保证可见性和禁止重排序。但内存屏障是给编译器和处理器看的,程序员不可能每次都去数「这里该插几个屏障」——太底层,也太容易错。为此 JSR-133 提出了 happens-before:一套用起来简单、又能覆盖内存可见性全部要求的规则。
为什么需要 happens-before
happens-before 的含义很直白:前面一个操作的结果,对后续操作是可见的。
它同时约束了两件事:
- 对程序员:如果 A happens-before B,那么 A 的执行结果对 B 可见,且 A 的执行顺序排在 B 之前。这是 JMM 给程序员的承诺。
- 对编译器和处理器:JMM 允许重排序,只要重排序后的执行结果与按 happens-before 关系执行的结果一致。换句话说 happens-before 不要求真实执行顺序,只要求结果一致。
第二条经常被误解。两个操作之间存在 happens-before 关系,并不意味着 Java 平台的具体实现必须按这个顺序执行指令。JMM 遵循一个基本原则:只要不改变程序的执行结果,编译器和处理器怎么优化都行。
as-if-serial语义保证单线程内程序执行结果不被改变- happens-before 关系保证正确同步的多线程程序执行结果不被改变
这样做的目的,是在不改变结果的前提下尽可能提高并行度。
八条规则
JSR-133 定义了八条 happens-before 规则,这就是判断程序有没有并发安全问题的工具箱:
| # | 规则 | 内容 |
|---|---|---|
| 1 | 程序顺序规则 | 一个线程中的每个操作,happens-before 于该线程中的任意后续操作 |
| 2 | 锁定规则 | 对一个锁的解锁,happens-before 于随后对这个锁的加锁 |
| 3 | volatile 变量规则 | 对一个 volatile 变量的写,happens-before 于任意后续对这个变量的读 |
| 4 | 传递规则 | 如果 A happens-before B,且 B happens-before C,那么 A happens-before C |
| 5 | 线程启动规则 | 线程 A 调用线程 B 的 start(),则该操作 happens-before 于线程 B 中的任意操作 |
| 6 | 线程中断规则 | 对线程 interrupt() 的调用 happens-before 于被中断线程检测到中断事件 |
| 7 | 线程终结规则 | 线程 B 中的任意操作 happens-before 于线程 A 从 ThreadB.join() 成功返回 |
| 8 | 对象终结规则 | 一个对象的初始化完成 happens-before 于它的 finalize() 方法开始 |
前四条是最常用的,尤其是传递规则——它把单条规则串成链条,让可见性能够跨线程传递。
规则 1:程序顺序规则
在一个线程中,按程序顺序,前面的操作 happens-before 于后续的任意操作。
class VolatileExample {
    int x = 0;
    volatile boolean v = false;

    public void writer() {
        x = 42;      // 这一行
        v = true;    // happens-before 这一行
    }

    public void reader() {
        if (v == true) {
            // 这里 x 会是多少?
        }
    }
}
这符合单线程的直觉:前面对某个变量的修改,一定对后续操作可见。
规则 3:volatile 变量规则
对一个 volatile 变量的写,happens-before 于后续对这个变量的读。
单看这条好像只是「禁用了缓存」,和 Java 5 之前的语义没区别。但它和程序顺序规则、传递规则组合起来,效果就完全不同了。
规则 4:传递性
如果 A happens-before B,且 B happens-before C,那么 A happens-before C。
把传递性用到上面的例子上:
x = 42happens-before 写v = true—— 这是规则 1- 写
v = truehappens-before 读v == true—— 这是规则 3 - 由传递性推出:
x = 42happens-before 读v == true
意味着如果线程 B 读到了 v == true,那么线程 A 设置的 x = 42 对线程 B 就是可见的,线程 B 一定能看到 x == 42。
public class Transitivity {

    int x = 0;
    volatile boolean v = false;

    public static void main(String[] args) throws InterruptedException {
        Transitivity transitivity = new Transitivity();
        Thread threadA = new Thread(() -> transitivity.writer());
        Thread threadB = new Thread(() -> transitivity.reader());

        threadA.start();
        threadA.join();
        threadB.start();
        threadB.join();
    }

    public void writer() {
        x = 42;
        v = true;
    }

    public void reader() {
        if (v == true) {
            // 这里 x 会是 42
            System.out.println(x);
        }
    }
}
这也是「volatile 能保证它之前的所有写操作对后续读线程可见」这个常见说法的由来——volatile 本身只保证它自己那一个变量,是传递性把范围扩大了。
规则 2:管程中锁的规则
对一个锁的解锁,happens-before 于随后对这个锁的加锁。
这里的「管程」在 Java 里就是 synchronized。管程的加锁解锁是隐式实现的:进入同步块前自动加锁,离开时自动解锁,都是编译器帮我们做的。
synchronized (this) { // 此处自动加锁
  // x 是共享变量,初始值 = 10
  if (this.x < 12) {
    this.x = 12;
  }
} // 此处自动解锁
假设 x 初始值是 10。线程 A 执行完代码块,x 变成 12,同时自动释放锁;线程 B 进入代码块时能读到线程 A 对 x 的写,也就是看到 x == 12。这就是锁的可见性保证。
规则 5:线程 start() 规则
主线程 A 启动子线程 B 后,子线程 B 能看到主线程在启动它之前做的所有操作。
public class StartHappenBefore {

    public static void main(String[] args) {
        int i = 0;
        Thread B = new Thread(() -> {
            // 主线程调用 B.start() 之前
            // 所有对共享变量的修改,此处皆可见
            // 此例中 i == 1
            System.out.println(i);
        });

        i = 1;      // 此处对共享变量 i 修改
        B.start();  // 主线程启动子线程
    }
}
规则 7:线程 join() 规则
主线程 A 调用子线程 B 的 join() 并成功返回后,线程 B 中的所有操作对主线程 A 可见。
public class JoinHappenBefore {

    public static void main(String[] args) {
        int i = 0;
        Thread B = new Thread(() -> {
            i = 1;  // 此处对共享变量 i 修改
        });

        B.start();
        B.join();
        // 子线程所有对共享变量的修改
        // 在主线程调用 B.join() 之后皆可见
        // 此例中 i == 1
        System.out.println(i);
    }
}
怎么用它判断并发安全
有了这八条规则,判断一段代码有没有并发安全问题就有了可操作的路径:
- 找出所有共享可变变量——被多个线程读写、且至少有一个线程会写
- 看每对「写 → 读」之间有没有 happens-before 关系
- 如果能用这八条规则串出关系,那读线程就能看到写线程的值,是安全的
- 如果串不出关系,就存在可见性问题,需要补上
volatile、synchronized或Lock来建立关系
最常见的误用,是把 happens-before 当成「代码执行顺序」。它的本质是可见性,不是时序:
happens-before 的语义是一种因果关系。现实中如果 A 是 B 的起因,那么 A 一定先于 B 发生——这是它的现实理解。在 Java 里,A happens-before B 意味着 A 事件对 B 事件可见,无论两者是否在同一个线程。A 在线程 1、B 在线程 2 也一样,规则保证线程 2 能看到 A 的发生。
所以看到 happens-before,脑子里该浮现的是「可见」,而不是「先后」。真正的执行顺序,只要不改变结果,JVM 怎么排都可以。
并发、线程与等待通知机制
前面几节都在讲「怎么让线程之间不打架」——互斥。但线程之间不只有竞争,还有协作:一个线程要等另一个线程准备好才能继续。这就是并发编程的另一个核心问题:同步。
Java 里实现线程协作的原语是 wait / notify,它和管程是同一套东西的两个面。这一节先把线程本身说清楚,再看等待通知机制是怎么工作的。
并发与并行
这两个词经常被混用,但说的不是一件事:
- 并发:多个事情在同一时间段内同时发生了。多个任务之间互相抢占资源,宏观上像同时进行,微观上仍是交替执行。
- 并行:多个事情在同一时间点上同时发生了。真正的同时执行,需要多核支持。
并发是一种程序结构,并行是一种执行方式。单核 CPU 上也能写并发程序,只是不会有真正的并行。
生产者—消费者模式
理解等待通知机制最好的入口是生产者—消费者模式。这是并发协作里最经典的场景:
- 生产者线程生产数据
- 消费者线程消费数据
- 两者不直接打交道,而是通过一个共享数据区(相当于仓库)解耦
生产者把数据放进仓库就不用管谁来消费,消费者从仓库取数据也不用管谁生产的。但这个共享区必须具备线程间协作的能力:
- 仓库满了,生产者必须停下来等,不能继续往里塞
- 仓库空了,消费者必须停下来等,不能空转取
- 生产者放进一个数据后,要通知等待的消费者可以取了
- 消费者取走一个数据后,要通知等待的生产者可以放了
「停下來等」和「被唤醒」这两个动作,就是 wait 和 notify 要解决的事。
用 wait/notify 实现生产者—消费者
wait、notify、notifyAll 都是 Object 上的方法(不是 Thread 的),因为它们操作的是对象的监视器。使用它们有三条铁律:
- 必须在
synchronized块或方法中调用,否则抛IllegalMonitorStateException wait()会释放锁并进入等待队列,被唤醒后重新竞争锁,拿到锁才从wait()返回- 必须在循环里判断条件,用
while而不是if
第三条最容易写错,原因在下一节解释。
public class ProducerConsumer {

    private final int[] buffer;
    private int count = 0;

    public ProducerConsumer(int size) {
        this.buffer = new int[size];
    }

    public synchronized void produce(int value) throws InterruptedException {
        // 仓库满:生产者等待,且必须用 while 循环判断
        while (count == buffer.length) {
            wait();
        }
        buffer[count++] = value;
        System.out.println("生产:" + value);
        // 通知等待的消费者
        notifyAll();
    }

    public synchronized int consume() throws InterruptedException {
        // 仓库空:消费者等待
        while (count == 0) {
            wait();
        }
        int value = buffer[--count];
        System.out.println("消费:" + value);
        // 通知等待的生产者
        notifyAll();
        return value;
    }
}
用起来是这样:
public static void main(String[] args) {
    ProducerConsumer pc = new ProducerConsumer(5);

    new Thread(() -> {
        for (int i = 0; i < 20; i++) {
            try {
                pc.produce(i);
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        }
    }, "producer").start();

    new Thread(() -> {
        for (int i = 0; i < 20; i++) {
            try {
                pc.consume();
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
            }
        }
    }, "consumer").start();
}
为什么必须用 while 而不是 if
这是 wait 最容易踩的坑。if 看起来更直观——「条件不满足就等一下」,但它是错的:
// 错误写法
if (count == 0) {
    wait();
}
原因有两层:
第一,被唤醒不代表条件成立。 notifyAll() 唤醒的是所有等待线程,它们会一起去抢锁,只有一个能抢到。抢到锁的线程从 wait() 返回时,条件可能已经被别的线程改回去了——比如消费者 A 被唤醒拿到锁,发现仓库又空了。用 if 的话它会直接往下执行,从空仓库里取数据,直接出错。
第二,唤醒可能是「假的」。 虽然 Java 里没有 spurious wakeup 的正式保证问题,但把条件检查放在循环里是操作系统层面的通行做法,wait 的语义从来不保证「唤醒时条件一定成立」。
所以正确姿势是:在循环中检查条件,不满足就继续 wait。
notify 还是 notifyAll
notify() 只唤醒一个等待线程,notifyAll() 唤醒全部。默认应该用 notifyAll()。
因为 notify() 唤醒哪个线程是不确定的。在生产者—消费者里,如果仓库状态变化后只唤醒了一个同类线程(比如仓库从满变成不满,却唤醒了一个生产者——如果当时等待队列里既有生产者又有消费者),条件不匹配的线程醒来后会重新 wait,而真正该被唤醒的线程可能永远等不到。用 notifyAll() 就没这个问题,代价是多了几次无意义的竞争和重检查。
只有在等待队列中所有线程等待的条件完全相同时,notify() 才是安全的。这个前提很容易在不经意间被打破,所以除非有明确的性能理由,一律用 notifyAll()。
wait 会释放锁,sleep 不会
这是另一个高频混淆点:
| 方法 | 所属 | 是否释放锁 | 是否可被中断 | 何时使用 |
|---|---|---|---|---|
wait() | Object | 会释放 | 会 | 等待某个条件成立 |
sleep() | Thread | 不释放 | 会 | 单纯想让当前线程停一会儿 |
join() | Thread | 内部用 wait 实现,会释放 | 会 | 等另一个线程执行完 |
wait 必须释放锁,否则别的线程永远进不来改条件,就会死等下去——这也是「wait 必须在同步块里」的根本原因:不持有锁,就无从谈释放锁。
wait/notify 的实现原理
wait 和 notify 在 JVM 层面对应的是 ObjectMonitor 上的操作。理解它需要管程模型,这部分我们已经在《管程》和《Jvm层面的管程实现-synchronized》里详细讲过,这里只补一句关键结论:
synchronized 的监视器里有两类队列:
- 入口队列(EntryList):等着抢锁的线程
- 等待队列(WaitSet):调用了
wait()后挂起的线程
wait() 做的事是:把当前线程放进 WaitSet,释放监视器,然后挂起;notify() 做的事是:从 WaitSet 里挑一个(或全部)线程移到 EntryList,让它重新参与抢锁。唤醒不等于立即继续执行,被唤醒的线程还得再去抢一次锁——这正好解释了为什么醒来后条件可能又变了,也再次说明了为什么必须用 while。
LockSupport:更底层的等待通知
wait / notify 有两个限制:必须在 synchronized 里用,且唤醒必须在等待之后发生(先 notify 后 wait,那个 notify 就丢了)。
LockSupport 绕开了这两点,它提供的是线程级别的阻塞与唤醒:
public class LockSupportDemo {

    public static void main(String[] args) throws InterruptedException {
        Thread t = new Thread(() -> {
            System.out.println("线程开始等待");
            // 阻塞当前线程,不要求持有任何锁
            LockSupport.park();
            System.out.println("线程被唤醒");
        });
        t.start();

        Thread.sleep(1000);
        System.out.println("主线程发起唤醒");
        // 唤醒指定线程
        LockSupport.unpark(t);
    }
}
关键差异:
wait / notify | LockSupport.park / unpark | |
|---|---|---|
是否必须在 synchronized 内 | 必须 | 不需要 |
| 唤醒对象 | 只能唤醒等待同一个监视器的线程 | 可以直接指定线程 |
| 先唤醒后等待 | 唤醒会丢失 | 许可机制,unpark 先调用,park 会立即返回 |
| 中断表现 | 抛 InterruptedException | 直接返回,不抛异常 |
最后一点很重要:LockSupport 内部用一个「许可」(permit)来记录状态,unpark 相当于发放许可,park 消费许可。许可最多一个,这点和 Semaphore(1) 类似。
LockSupport 是 AQS 里阻塞线程的实现基础——ReentrantLock 在抢不到锁时,最终就是通过 LockSupport.park() 挂起的,这部分我们在 AQS 源码那节看过。
小结
- 并发编程有两大核心问题:互斥和同步(协作)。前面几节讲互斥,这节讲同步。
- 等待通知机制的载体是对象的监视器,所以
wait/notify定义在Object上。 - 三条铁律:必须在
synchronized内;wait释放锁;条件判断必须用while循环。 - 默认用
notifyAll(),notify()只有在等待条件完全相同时才安全。 - 需要更底层的控制(不持有锁、指定线程、不丢失唤醒)时,用
LockSupport。
synchronized 的用法
synchronized 关键字
思考:有了分布式锁,还有必要学习使用synchronized 和 Lock吗?
synchronized 简介
synchronized 是 Java 的内置锁机制,用于实现线程同步,防止并发问题。它可作用于方法或代码块,确保同一时刻只有一个线程访问受保护代码。
用法一:作用于实例方法
public synchronized void instanceMethod() {
    // 代码
}效果:锁定当前实例对象(this)。不同实例可并发执行同一方法,但同一实例的多个 synchronized 实例方法互斥。
适用:保护实例变量。
用法二:作用于静态方法
public static synchronized void staticMethod() {
    // 代码
}效果:锁定类对象(Class)。所有实例共享此锁,静态方法互斥执行。
适用:保护静态变量。
用法三:作用于类
synchronized (ClassName.class) {
    // 代码
}效果:等同静态方法锁,锁定类对象。用于非静态方法中实现类级同步。
适用:跨实例同步。
用法四:作用于任意对象
private final Object lock = new Object();

public void doSomething() {
    synchronized (lock) {
        // 受保护的代码
        count++;
    }
}
效果:锁定指定的对象(lock)。只有持有同一对象锁的线程才能互斥执行该代码块。
适用:细粒度控制、保护特定资源、不想锁整个实例或类时使用。
synchronized 与 Integer
public class SynchronizedInteger {

    static void test() throws Exception {
        Integer lock1 = 100;           // 缓存对象
        Integer lock2 = 100;           // 同一个对象

        Thread t1 = new Thread(() -> {
            synchronized (lock1) {
                System.out.println("T1 got lock");
                sleep();
                System.out.println("T1 release");
            }
        });

        Thread t2 = new Thread(() -> {
            synchronized (lock2) {
                System.out.println("T2 got lock");
            }
        });

        t1.start();
        Thread.sleep(100);
        t2.start();
    }

    static void sleep() {
        try {
            Thread.sleep(3000);
        } catch (Exception ignored) {
        }
    }

    public static void main(String[] args) throws Exception {
        test();
    }
}
结果:T2 必须等 T1 睡完 3 秒才能打印,意外串行。
synchronized 与 String
public class SynchronizedString {

    static void test() throws Exception {
        String lockA = "GLOBAL_LOCK";   // 常量池同一对象
        String lockB = "GLOBAL_LOCK";   // 同一对象

        Thread t1 = new Thread(() -> {
            synchronized (lockA) {
                System.out.println("T1 got lock");
                sleep();
                System.out.println("T1 release");
            }
        });

        Thread t2 = new Thread(() -> {
            synchronized (lockB) {
                System.out.println("T2 got lock");
            }
        });

        t1.start();
        Thread.sleep(100);
        t2.start();
    }

    static void sleep() {
        try {
            Thread.sleep(3000);
        } catch (Exception ignored) {
        }
    }

    public static void main(String[] args) throws Exception {
        test();
    }
}
结果:T2 被阻塞,直到 T1 结束 ,不同类/模块间意外互斥。
synchronized 使用总结
| 使用场景 | 锁对象 | 适用情况 |
|---|---|---|
| 同步实例方法 | this | 保护整个实例方法 |
| 同步代码块 | 自定义对象 | 保护部分代码,灵活性更高 |
| 同步静态方法 | Class 对象 | 保护类级别的静态资源 |
| 同步类对象 | Class 对象 | 在实例方法中保护静态资源 |
| 同步不同实例 | 各自的 this | 实例级独立同步,不干扰其他实例 |
Jvm层面的管程实现-synchronized
synchronized 与管程
ObjectMonitor
JVM 在底层通过 monitorenter 和 monitorexit 指令实现 synchronized 的同步机制。这些指令操作对象的监视器。下面是原理的简化和对应的伪代码解释:
- 当线程进入 synchronized (object) 时:
- 执行 monitorenter 指令,尝试获取 object 的监视器。
- 如果监视器未被占用,线程成功获取并进入代码块。
- 如果监视器已被其他线程持有,当前线程阻塞等待。
- 当线程离开 synchronized 块时:
- 执行 monitorexit 指令,释放 object 的监视器。
- 其他等待的线程可以竞争获取监视器。
监视器的C++代码:
class ObjectMonitor {
private:
    volatile intptr_t _header;         // 对象头的 Mark Word
    void* _object;                     // 指向被锁的 Java 对象
    pthread_mutex_t _mutex;            // 互斥锁,用于保护监视器
    pthread_cond_t _cond;              // 条件变量,用于线程等待和唤醒
    Thread* _owner;                    // 当前持有锁的线程
    ObjectWaiter* _waiters;            // 等待队列(等待锁的线程)
    int _recursions;                   // 重入次数(支持锁重入)

public:
    ObjectMonitor() {
        _header = 0;
        _object = nullptr;
        _owner = nullptr;
        _waiters = nullptr;
        _recursions = 0;
        pthread_mutex_init(&_mutex, nullptr);
        pthread_cond_init(&_cond, nullptr);
    }

    ~ObjectMonitor() {
        pthread_mutex_destroy(&_mutex);
        pthread_cond_destroy(&_cond);
    }

    void enter(Thread* self);          // 进入监视器(获取锁)
    void exit(Thread* self);           // 退出监视器(释放锁)
    void wait(Thread* self);           // 等待
    void notify(Thread* self);         // 通知一个等待线程
    void notifyAll(Thread* self);      // 通知所有等待线程
};地址:https://hg.openjdk.org/jdk8/jdk8/hotspot/file/87ee5ee27509/src/share/vm/runtime/objectMonitor.hpp
搜索: _EntryList = NULL ;
字段说明:
- _mutex:互斥锁,确保同一时刻只有一个线程操作监视器。
- _cond:条件变量,用于实现 wait() 和 notify() 的等待/唤醒机制。
- _owner:记录当前持有锁的线程。
- _recursions:支持锁的可重入性(同一个线程可以多次获取锁)。
- _waiters:等待队列,存储因锁竞争而阻塞的线程。
监视器池
当 synchronized 锁升级为重量级锁时,JVM 需要一个机制来管理锁的竞争,包括记录持有锁的线程、维护等待队列、处理线程的阻塞和唤醒等。由于锁竞争可能发生在多个对象上,JVM 不可能为每个对象都预先分配一个完整的监视器结构(内存开销太大)。因此,JVM 使用一个 ObjectMonitor 池 来动态分配和重用监视器对象,以优化内存使用和性能。
在 HotSpot JVM 中,ObjectMonitor 是一个 C++ 类,定义在 hotspot/src/share/vm/runtime/objectMonitor.hpp 和 objectMonitor.cpp 中。JVM 通过一个池(或类似的内存管理机制)来维护这些 ObjectMonitor 实例。
监视器池的实现
全局池:JVM 维护一个全局的 ObjectMonitor 池,通常是一个链表或类似的数据结构,用于存储空闲的 ObjectMonitor 实例。
在源码中,这由 ObjectSynchronizer 类管理(位于 synchronizer.cpp)。
示例字段(简化):
C++static ObjectMonitor* gFreeMonitorList; // 空闲监视器链表 static volatile intptr_t gMonitorFreeCount; // 空闲监视器数量
初始化:
- JVM 启动时会预分配一定数量的 ObjectMonitor 实例,放入空闲池中。
- 数量通常由 JVM 参数(如 -XX:MonitorBound)控制,默认值取决于系统资源。
动态分配:
- 当需要新的 ObjectMonitor 时,JVM 从池中取出一个空闲实例。
- 如果池为空,则动态分配一个新的实例(通过 new ObjectMonitor())并初始化。
回收:
- 当锁释放且不再需要某个 ObjectMonitor 时,它会被清理并放回池中,以便重用。
为Java对象分配监视器
地址:https://hg.openjdk.org/jdk8/jdk8/hotspot/file/87ee5ee27509/src/share/vm/runtime/objectMonitor.cpp
搜索:
检查锁状态
- JVM 检查目标对象(如 MyClass.class)的 Mark Word。
- 如果是轻量级锁且竞争加剧,进入锁膨胀流程。
从监视器池中获取监视器
调用 ObjectSynchronizer::inflate:
c++ObjectMonitor* ObjectSynchronizer::inflate(oop obj) { if (gFreeMonitorList != NULL) { // 从空闲池中取出一个监视器 ObjectMonitor* monitor = gFreeMonitorList; gFreeMonitorList = monitor->next_free(); gMonitorFreeCount--; monitor->recycle(); // 重置状态 return monitor; } else { // 池为空,分配新实例 return new ObjectMonitor(); } }参数 obj 是被锁的 Java 对象(这里是 MyClass.class)。
inflate 这个单词是膨胀的意思
初始化监视器
- 将 ObjectMonitor 的 _object 字段设置为 MyClass.class 的指针。
- 清空 _owner、_EntryList 等字段,准备接收线程。
将 ObjectMonitor 地址写入 Mark Word
在分配 ObjectMonitor 后,JVM 需要将其地址与 Class 对象关联起来,这一过程通过更新 Mark Word 完成。
Mark Word 与监视器
Mark Word 是一个动态结构,其内容根据锁状态变化:
- 无锁:存储哈希码或 GC 信息。
- 偏向锁:存储线程 ID 和偏向标志。
- 轻量级锁:指向线程栈中的锁记录。
- 重量级锁:存储指向 ObjectMonitor 的指针。
在 64 位 JVM 中,Mark Word 通常是 64 位,格式如下(简化):
|-----------------------------------------------|
| 锁状态 | 内容                                      |
|--------|------------------------------------------|
| 无锁   | hash:31 | age:4 | 0 | 01                |
| 偏向锁 | thread:54 | epoch:2 | 1 | 01            |
| 轻量级 | ptr_to_lock_record:62 | 00              |
| 重量级 | ptr_to_monitor:62 | 10                  |
|-----------------------------------------------|- 重量级锁状态:最后两位是 10,其余位存储 ObjectMonitor 的地址。
写入Mark Word过程
锁膨胀:
ObjectSynchronizer::inflate 返回 ObjectMonitor 实例后,JVM 更新 Mark Word。
示例代码(简化):
c++void inflate_and_associate(oop obj, ObjectMonitor* monitor) { markOop mark = obj->mark(); // 获取当前 Mark Word if (mark->is_neutral()) { // 无锁状态 markOop new_mark = (markOop)(monitor | WEIGHTED_LOCK_FLAG); if (Atomic::cmpxchg_ptr(new_mark, obj->mark_addr(), mark) == mark) { monitor->set_object(obj); // 关联对象 } } else if (mark->has_locker()) { // 轻量级锁 // 撤销轻量级锁,更新为重量级锁 markOop new_mark = (markOop)(monitor | WEIGHTED_LOCK_FLAG); Atomic::cmpxchg_ptr(new_mark, obj->mark_addr(), mark); } }使用 CAS(cmpxchg_ptr)原子地将 ObjectMonitor 地址写入 Mark Word。
标志位设置:
- 将 Mark Word 的低两位设置为 10,表示重量级锁。
- 高位存储 ObjectMonitor 的内存地址。
关联完成:
- 此时,MyClass.class 的 Mark Word 指向 ObjectMonitor,线程通过该指针访问监视器。
监视器的后续管理
- 线程竞争:
- 第一个线程获取锁,ObjectMonitor 的 _owner 设置为该线程。
- 其他线程加入 _EntryList,通过 pthread_mutex_t 和 futex 阻塞。
- 锁释放:
- 线程退出 synchronized 块,调用 monitorexit。
- JVM 检查 _recursions,若为 0,则释放 ObjectMonitor,唤醒 _EntryList 中的线程。
- 回收:
- 如果 ObjectMonitor 不再需要,JVM 将其放回空闲池(gFreeMonitorList)。
思考题
既然 synchronized 和 Lock 都是基于管程来实现的,那为什么已经有了synchronized ,还需要 Lock ?
Lock 入门
Lock接口的使用
Lock l = ...;

l.lock();
try {
    // access the resource protected by this lock
} finally {
    l.unlock();
}
Lock的由来
前面我们提到过在并发编程领域,有两大核心问题:一个是互斥,即同一时刻只允许一个线程访问共享资源;另一个是同步,即线程之间如何通信、协作。这两大问题,管程都是能够解决的。Java SDK 并发包通过 Lock 和 Condition 两个接口来实现管程,其中 Lock 用于解决互斥问题,Condition 用于解决同步问题。
Java 语言本身提供的 synchronized 也是管程的一种实现,既然 Java 从语言层面已经实现了管程了,那为什么还要在 SDK 里提供另外一种实现呢?
再造管程的理由
对于死锁问题,可以采用破坏不可抢占条件方案,即占用部分资源的线程进一步申请其他资源时,如果申请不到,可以主动释放它占有的资源。
但synchronized 没有办法解决。原因是 synchronized 申请资源的时候,如果申请不到,线程直接进入阻塞状态了,而线程进入阻塞状态,啥都干不了,也释放不了线程已经占有的资源。
如果我们重新设计一把互斥锁去解决这个问题,那该怎么设计呢?
能够响应中断。synchronized 的问题是,持有锁 A 后,如果尝试获取锁 B 失败,那么线程就进入阻塞状态,一旦发生死锁,就没有任何机会来唤醒阻塞的线程。但如果阻塞状态的线程能够响应中断信号,也就是说当我们给阻塞的线程发送中断信号的时候,能够唤醒它,那它就有机会释放曾经持有的锁 A。这样就破坏了不可抢占条件了。
支持超时。如果线程在一段时间之内没有获取到锁,不是进入阻塞状态,而是返回一个错误,那这个线程也有机会释放曾经持有的锁。这样也能破坏不可抢占条件。
非阻塞地获取锁。如果尝试获取锁失败,并不进入阻塞状态,而是直接返回,那这个线程也有机会释放曾经持有的锁。这样也能破坏不可抢占条件。
这三种方案可以全面弥补 synchronized 的问题。
// 支持中断的API
void lockInterruptibly() throws InterruptedException;

// 支持超时的API
boolean tryLock(long time, TimeUnit unit) throws InterruptedException;

// 支持非阻塞获取锁的API
boolean tryLock();
来源:JDK注释。
MESA 与 Java中的锁机制
MESA 与 synchronized

MESA 与 Lock

可重入锁
Synchronized 与可重入锁
public class SynchronizedDemo {

    public synchronized void methodA() {
        System.out.println("进入 methodA");
        methodB();
        System.out.println("退出 methodA");
    }

    public synchronized void methodB() {
        System.out.println("进入 methodB");
    }

    public static void main(String[] args) {
        SynchronizedDemo demo = new SynchronizedDemo();
        demo.methodA();
    }
}
ReentrantLock 与可重入锁
public class ReentrantLockDemo {

    private final ReentrantLock lock = new ReentrantLock();

    public void methodA() {
        lock.lock();
        try {
            System.out.println("进入 methodA");
            methodB();
            System.out.println("退出 methodA");
        } finally {
            lock.unlock();
        }
    }

    public void methodB() {
        lock.lock();
        try {
            System.out.println("进入 methodB");
        } finally {
            lock.unlock();
        }
    }

    public static void main(String[] args) {
        ReentrantLockDemo demo = new ReentrantLockDemo();
        demo.methodA();
    }
}
公平锁与非公平锁
import java.util.concurrent.locks.ReentrantLock;

public class FairAndNonFairLockDemo {

    public static void main(String[] args) throws InterruptedException {

        System.out.println("====== 公平锁 ======");
        testLock(new ReentrantLock(true));

        Thread.sleep(3000);

        System.out.println("\n====== 非公平锁 ======");
        testLock(new ReentrantLock(false));
    }

    private static void testLock(ReentrantLock lock) {
        for (int i = 1; i <= 5; i++) {
            final int threadNum = i;

            new Thread(() -> {
                System.out.println(Thread.currentThread().getName() + " 等待获取锁");

                lock.lock();
                try {
                    System.out.println(Thread.currentThread().getName() + " 获取到锁");

                    try {
                        Thread.sleep(500);
                    } catch (InterruptedException e) {
                        e.printStackTrace();
                    }

                } finally {
                    System.out.println(Thread.currentThread().getName() + " 释放锁");
                    lock.unlock();
                }

            }, "Thread-" + threadNum).start();

            try {
                Thread.sleep(100);
            } catch (InterruptedException e) {
                e.printStackTrace();
            }
        }
    }
}
Java语言层面的管程实现-AQS
AQS 源码探究
什么是AQS?
AQS 核心封装了三样东西:
- state(同步状态)
- 用来表示锁是否被占用、剩余许可证数量、倒计时次数等。
- CLH 等待队列
- 获取资源失败的线程自动排队等待。
- Node 节点
- 等待线程会包装成 Node。
- 模板方法
- 获取锁/释放锁的逻辑,acquire/release
一句话总结:AQS(AbstractQueuedSynchronizer)是 Java 并发包中的同步器框架,它把“线程排队、阻塞、唤醒、状态管理”等通用逻辑统一封装起来,让开发者只需要定义资源的获取和释放规则,就能快速实现各种锁和同步器。
CLH队列
AQS的结构
public class AbstractQueuedSynchronizer {
    // 头结点,你直接把它当做 当前持有锁的线程 可能是最好理解的
	private transient volatile Node head;

    // 阻塞的尾节点,每个新的节点进来,都插入到最后,也就形成了一个链表
    private transient volatile Node tail;

    // 这个是最重要的,代表当前锁的状态,0代表没有被占用,大于 0 代表有线程持有当前锁
    // 这个值可以大于 1,是因为锁可以重入,每次重入都加上 1
    private volatile int state;

    // 代表当前持有独占锁的线程,举个最重要的使用例子,因为锁可以重入
    // ReentrantLock#lock()可以嵌套调用多次,所以每次用这个来判断当前线程是否已经拥有了锁
    // if (currentThread == getExclusiveOwnerThread()) {state++}
    private transient Thread exclusiveOwnerThread; //继承自AbstractOwnableSynchronizer

    // 获取锁
    public final void acquire(int arg);

    // 把线程包装成node,同时进入到队列中
    private Node addWaiter(Node mode);

    // 队列中是否有其他的线程在等待锁
    // 方法返回值的含义:true:如果当前线程之前有一个排队线程,false:如果当前线程是头结点是当前线程或者队列为空
    public final boolean hasQueuedPredecessors();

    // 负责处理这个节点在队列中的逻辑,决定线程是继续等待还是尝试获取锁。
    // 如果线程无法立即获取锁,acquireQueued会通过LockSupport.park挂起线程,减少CPU资源浪费。
    // 当锁被释放或其他条件满足时,前驱节点会通过LockSupport.unpark唤醒后续节点的线程,线程继续尝试获取锁。
    // 会检测线程是否被中断。如果线程在等待过程中被中断,它会记录中断状态并根据调用上下文决定是否抛出InterruptedException。
   	final boolean acquireQueued(final Node node, int arg);
}
AbstractQueuedSynchronizer 的等待队列示意如下所示,注意了,之后分析过程中所说的 queue,也就是阻塞队列不包含 head。

等待队列中每个线程被包装成一个 Node 实例,数据结构是链表:
static final class Node {
    // 标识节点当前在共享模式下
    static final Node SHARED = new Node();

    // 标识节点当前在独占模式下
    static final Node EXCLUSIVE = null;

    // ======== 下面的几个int常量是给waitStatus用的 ===========

    // 表示此线程取消了争抢这个锁
    static final int CANCELLED =  1;

    // 表示当前node的后继节点对应的线程需要被唤醒
    static final int SIGNAL = -1;

    // 表示阻塞在条件等待队列上
    static final int CONDITION = -2;

    // 表示应将releaseShared传播到其他节点。这是在doReleaseShared中设置的(仅适用于头部节点),以确保传播继续,即使此后有其他操作介入。
    static final int PROPAGATE = -3;

    // 取值为上面的1、-1、-2、-3,或者0(以后会讲到)
    // 这么理解,暂时只需要知道如果这个值 大于0 代表此线程取消了等待
    volatile int waitStatus;

    // 前驱节点的引用
    volatile Node prev;

    // 后继节点的引用
    volatile Node next;

   // 在同步队列里用来标识节点是独占锁节点还是共享锁节点,在条件队列里代表条件条件队列的下一个节点
   Node nextWaiter;

    // 当前线程
    volatile Thread thread;
}
等待队列

加锁过程
如果同时有三个线程并发抢占锁,此时线程一抢占锁成功,线程二和线程三抢占锁失败,具体执行流程如下:
那么此时AQS内部的数据是:
加锁的源码解析:
static final class FairSync extends Sync {

    // 争锁
    final void lock() {
       acquire(1);
    }

    // 我们看到,这个方法,如果tryAcquire(arg) 返回true, 也就结束了。
    // 否则,acquireQueued方法会将线程压到队列中
    public final void acquire(int arg) { // 此时 arg == 1
        // 首先调用tryAcquire(1)一下,尝试获取锁,如果获取到锁,就不需要进阻塞队列
        // 公平锁的语义:线程按请求锁的先后顺序排队,先请求的线程先获得锁
        // 非公平锁的语义:线程可以直接尝试获取锁
        if (!tryAcquire(arg) &&
            // tryAcquire(arg) 没有成功,这个时候需要把当前线程挂起,放到阻塞队列中。
            acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) {
            selfInterrupt();
        }
    }

    // 尝试直接获取锁,返回值是boolean,代表是否获取到锁
    // 返回true:1.没有线程在等待锁;2.重入锁,线程本来就持有锁,也就可以理所当然可以直接获取
    protected final boolean tryAcquire(int acquires) {
        final Thread current = Thread.currentThread();
        int c = getState();
        // state == 0 此时此刻没有线程持有锁
        if (c == 0) {
            // 虽然此时此刻锁是可以用的,但是这是公平锁,既然是公平,就得讲究先来后到,
            // 看看有没有别人在队列中等了半天了
            if (!hasQueuedPredecessors() &&
                // 如果没有线程在等待,那就用CAS尝试一下,成功了就获取到锁了,
                // 不成功的话,只能说明一个问题,就在刚刚几乎同一时刻有个线程抢先了 =_=
                // 因为刚刚还没人的,我判断过了
                compareAndSetState(0, acquires)) {

                // 到这里就是获取到锁了,标记一下,告诉大家,现在是我占用了锁
                setExclusiveOwnerThread(current);
                return true;
            }
        }
          // 会进入这个else if分支,说明是重入了,需要操作:state=state+1
        // 这里不存在并发问题
        else if (current == getExclusiveOwnerThread()) {
            int nextc = c + acquires;
            if (nextc < 0)
                throw new Error("Maximum lock count exceeded");
            setState(nextc);
            return true;
        }
        // 如果到这里,说明前面的if和else if都没有返回true,说明没有获取到锁
        // 回到上面一个外层调用方法继续看:
        // if (!tryAcquire(arg)
        //        && acquireQueued(addWaiter(Node.EXCLUSIVE), arg))
        //     selfInterrupt();
        return false;
    }

    // 假设tryAcquire(arg) 返回false,那么代码将执行:
      //		acquireQueued(addWaiter(Node.EXCLUSIVE), arg),
    // 这个方法,首先需要执行:addWaiter(Node.EXCLUSIVE)


    // 此方法的作用是把线程包装成node,同时进入到队列中
    // 参数mode此时是Node.EXCLUSIVE,代表独占模式
    private Node addWaiter(Node mode) {
        Node node = new Node(Thread.currentThread(), mode);
        // Try the fast path of enq; backup to full enq on failure
        // 以下几行代码想把当前node加到链表的最后面去,也就是进到阻塞队列的最后
        Node pred = tail;

        // tail!=null => 队列不为空(tail==head的时候
        if (pred != null) {
            // 将当前的队尾节点,设置为自己的前驱
            node.prev = pred;
            // 用CAS把自己设置为队尾, 如果成功后,tail == node 了,这个节点成为阻塞队列新的尾巴
            if (compareAndSetTail(pred, node)) {
                // 进到这里说明设置成功,当前node==tail, 将自己与之前的队尾相连,
                // 上面已经有 node.prev = pred,加上下面这句,也就实现了和之前的尾节点双向连接了
                pred.next = node;
                // 线程入队了,可以返回了
                return node;
            }
        }
        // 仔细看看上面的代码,如果会到这里,
        // 说明 pred==null(队列是空的) 或者 CAS失败(有线程在竞争入队)
        enq(node);
        return node;
    }


    // 采用自旋的方式入队
    // 之前说过,到这个方法只有两种可能:等待队列为空,或者有线程竞争入队,
    // 自旋在这边的语义是:CAS设置tail过程中,竞争一次竞争不到,我就多次竞争,总会排到的
    private Node enq(final Node node) {
        for (;;) {
            Node t = tail;
            // 之前说过,队列为空也会进来这里
            if (t == null) { // Must initialize
                // 初始化head节点
                // 细心的读者会知道原来 head 和 tail 初始化的时候都是 null 的
                // 还是一步CAS,你懂的,现在可能是很多线程同时进来呢
                if (compareAndSetHead(new Node()))
                    // 给后面用:这个时候head节点的waitStatus==0, 看new Node()构造方法就知道了

                    // 这个时候有了head,但是tail还是null,设置一下,
                    // 把tail指向head,放心,马上就有线程要来了,到时候tail就要被抢了
                    // 注意:这里只是设置了tail=head,这里可没return哦,没有return,没有return
                    // 所以,设置完了以后,继续for循环,下次就到下面的else分支了
                    tail = head;
            } else {
                // 下面几行,和上一个方法 addWaiter 是一样的,
                // 只是这个套在无限循环里,反正就是将当前线程排到队尾,有线程竞争的话排不上重复排
                node.prev = t;
                if (compareAndSetTail(t, node)) {
                    t.next = node;
                    return t;
                }
            }
        }
    }


    // 现在,又回到这段代码了
    // if (!tryAcquire(arg)
    //        && acquireQueued(addWaiter(Node.EXCLUSIVE), arg))
    //     selfInterrupt();

    // 下面这个方法,参数node,经过addWaiter(Node.EXCLUSIVE),此时已经进入阻塞队列
    // 注意一下:如果acquireQueued(addWaiter(Node.EXCLUSIVE), arg))返回true的话,
    // 意味着上面这段代码将进入selfInterrupt(),所以正常情况下,下面应该返回false
    // 这个方法非常重要,应该说真正的线程挂起,然后被唤醒后去获取锁,都在这个方法里了
    final boolean acquireQueued(final Node node, int arg) {
        boolean failed = true;
        try {
            boolean interrupted = false;
            for (;;) {
                final Node p = node.predecessor();
                // p == head 说明当前节点虽然进到了阻塞队列,但是是阻塞队列的第一个,因为它的前驱是head
                // 注意,阻塞队列不包含head节点,head一般指的是占有锁的线程,head后面的才称为阻塞队列
                // 所以当前节点可以去试抢一下锁
                // 这里我们说一下,为什么可以去试试:
                // 首先,它是队头,这个是第一个条件,其次,当前的head有可能是刚刚初始化的node,
                // enq(node) 方法里面有提到,head是延时初始化的,而且new Node()的时候没有设置任何线程
                // 也就是说,当前的head不属于任何一个线程,所以作为队头,可以去试一试,
                // tryAcquire已经分析过了, 忘记了请往前看一下,就是简单用CAS试操作一下state
                if (p == head && tryAcquire(arg)) {
                    setHead(node);
                    p.next = null; // help GC
                    failed = false;
                    return interrupted;
                }
                // 到这里,说明上面的if分支没有成功,要么当前node本来就不是队头,
                // 要么就是tryAcquire(arg)没有抢赢别人,继续往下看
                if (shouldParkAfterFailedAcquire(p, node) &&
                    parkAndCheckInterrupt())
                    interrupted = true;
            }
        } finally {
            // 什么时候 failed 会为 true???
            // tryAcquire() 方法抛异常的情况
            if (failed)
                cancelAcquire(node);
        }
    }

    // 刚刚说过,会到这里就是没有抢到锁呗,这个方法说的是:"当前线程没有抢到锁,是否需要挂起当前线程?"
    // 第一个参数是前驱节点,第二个参数才是代表当前线程的节点
    private static boolean shouldParkAfterFailedAcquire(Node pred, Node node) {
        int ws = pred.waitStatus;
        // 前驱节点的 waitStatus == -1 ,说明前驱节点状态正常,当前线程需要挂起,直接可以返回true
        if (ws == Node.SIGNAL)
            /*
             * This node has already set status asking a release
             * to signal it, so it can safely park.
             */
            return true;

        // 前驱节点 waitStatus大于0 ,之前说过,大于0 说明前驱节点取消了排队。
        // 这里需要知道这点:进入阻塞队列排队的线程会被挂起,而唤醒的操作是由前驱节点完成的。
        // 所以下面这块代码说的是将当前节点的prev指向waitStatus<=0的节点,
        // 简单说,就是为了找个好爹,因为你还得依赖它来唤醒呢,如果前驱节点取消了排队,
        // 找前驱节点的前驱节点做爹,往前遍历总能找到一个好爹的
        if (ws > 0) {
            /*
             * Predecessor was cancelled. Skip over predecessors and
             * indicate retry.
             */
            do {
                node.prev = pred = pred.prev;
            } while (pred.waitStatus > 0);
            pred.next = node;
        } else {
            // 仔细想想,如果进入到这个分支意味着什么
            // 前驱节点的waitStatus不等于-1和1,那也就是只可能是0,-2,-3
            // 在我们前面的源码中,都没有看到有设置waitStatus的,所以每个新的node入队时,waitStatu都是0
            // 正常情况下,前驱节点是之前的 tail,那么它的 waitStatus 应该是 0
            // 用CAS将前驱节点的waitStatus设置为Node.SIGNAL(也就是-1)
            compareAndSetWaitStatus(pred, ws, Node.SIGNAL);
        }
        // 这个方法返回 false,那么会再走一次 for 循序,
        // 然后再次进来此方法,此时会从第一个分支返回 true
        return false;
    }

    // private static boolean shouldParkAfterFailedAcquire(Node pred, Node node)
    // 这个方法结束根据返回值我们简单分析下:
    // 如果返回true, 说明前驱节点的waitStatus==-1,是正常情况,那么当前线程需要被挂起,等待以后被唤醒
    //		我们也说过,以后是被前驱节点唤醒,就等着前驱节点拿到锁,然后释放锁的时候叫你好了
    // 如果返回false, 说明当前不需要被挂起,为什么呢?往后看

    // 跳回到前面是这个方法
    // if (shouldParkAfterFailedAcquire(p, node) &&
    //                parkAndCheckInterrupt())
    //                interrupted = true;

    // 1. 如果shouldParkAfterFailedAcquire(p, node)返回true,
    // 那么需要执行parkAndCheckInterrupt():

    // 这个方法很简单,因为前面返回true,所以需要挂起线程,这个方法就是负责挂起线程的
    // 这里用了LockSupport.park(this)来挂起线程,然后就停在这里了,等待被唤醒=======
    private final boolean parkAndCheckInterrupt() {
        LockSupport.park(this);
        return Thread.interrupted();
    }

    // 2. 接下来说说如果shouldParkAfterFailedAcquire(p, node)返回false的情况

   // 仔细看shouldParkAfterFailedAcquire(p, node),我们可以发现,其实第一次进来的时候,一般都不会返回true的,原因很简单,前驱节点的waitStatus=-1是依赖于后继节点设置的。也就是说,我都还没给前驱设置-1呢,怎么可能是true呢,但是要看到,这个方法是套在循环里的,所以第二次进来的时候状态就是-1了。
}
acquireQueued方法的示意图:

shouldParkAfterFailedAcquire方法的示意图:

unparkSuccessor方法的示意图:

解锁过程
执行完后等待队列数据如下:
解锁的源码解析:
// 唤醒的代码还是比较简单的,你如果上面加锁的都看懂了,下面都不需要看就知道怎么回事了
public void unlock() {
    sync.release(1);
}

public final boolean release(int arg) {
    if (tryRelease(arg)) {
        Node h = head;
        if (h != null && h.waitStatus != 0)
            unparkSuccessor(h);
        return true;
    }
    return false;
}

// 回到ReentrantLock看tryRelease方法
protected final boolean tryRelease(int releases) {
    int c = getState() - releases;
    if (Thread.currentThread() != getExclusiveOwnerThread())
        throw new IllegalMonitorStateException();
    // 是否完全释放锁
    boolean free = false;
    // 其实就是重入的问题,如果c==0,也就是说没有嵌套锁了,可以释放了,否则还不能释放掉
    if (c == 0) {
        free = true;
        setExclusiveOwnerThread(null);
    }
    setState(c);
    return free;
}

/**
 * Wakes up node's successor, if one exists.
 *
 * @param node the node
 */
// 唤醒后继节点
// 从上面调用处知道,参数node是head头结点
private void unparkSuccessor(Node node) {
    /*
     * If status is negative (i.e., possibly needing signal) try
     * to clear in anticipation of signalling.  It is OK if this
     * fails or if status is changed by waiting thread.
     */
    int ws = node.waitStatus;
    // 如果head节点当前waitStatus<0, 将其修改为0
    if (ws < 0)
        compareAndSetWaitStatus(node, ws, 0);
    /*
     * Thread to unpark is held in successor, which is normally
     * just the next node.  But if cancelled or apparently null,
     * traverse backwards from tail to find the actual
     * non-cancelled successor.
     */
    // 下面的代码就是唤醒后继节点,但是有可能后继节点取消了等待(waitStatus==1)
    // 从队尾往前找,找到waitStatus<=0的所有节点中排在最前面的
    Node s = node.next;
    if (s == null || s.waitStatus > 0) {
        s = null;
        // 从后往前找,仔细看代码,不必担心中间有节点取消(waitStatus==1)的情况
        for (Node t = tail; t != null && t != node; t = t.prev)
            if (t.waitStatus <= 0)
                s = t;
    }
    if (s != null)
        // 唤醒线程
        LockSupport.unpark(s.thread);
}
唤醒线程以后,被唤醒的线程将从以下代码中继续往前走:
private final boolean parkAndCheckInterrupt() {
    LockSupport.park(this); // 刚刚线程被挂起在这里了
    return Thread.interrupted();
}
// 又回到这个方法了:acquireQueued(final Node node, int arg),这个时候,node的前驱是head了
独占锁总结

synchronized、Lock 与 MESA模型
| 功能/概念 | synchronized | Lock(如 ReentrantLock) | MESA 模型 | 说明 |
|---|---|---|---|---|
| 互斥锁获取 | 隐式(进入 synchronized 块/方法时) | lock() | 进入临界区(enter monitor) | 控制对共享资源的互斥访问 |
| 互斥锁释放 | 隐式(方法或代码块执行完自动释放) | unlock() | 离开临界区(exit monitor) | 防止死锁需手动释放 Lock |
| 等待条件 | wait()(需在同步块中使用) | await()(需结合 Condition 使用) | wait(进入等待队列,释放锁) | 条件等待机制 |
| 唤醒线程 | notify() / notifyAll() | signal() / signalAll() | signal(从等待队列移到就绪队列) | 通知等待线程资源可能可用 |
| 条件对象 | 无独立条件对象(隐式绑定 monitor) | Condition(通过 Lock.newCondition() 获取) | 等待队列(condition queue) | 每个条件可对应一个等待队列 |
| 可重入性 | 支持(可重入监视器锁) | ReentrantLock 支持可重入 | 支持 | 同一个线程可以多次获取同一把锁 |
| 中断响应 | wait() 可被中断 | await() 可中断 | wait 可中断 | 支持对等待线程进行中断控制 |
| 是否必须释放锁 | 自动(离开 synchronized 代码块) | 必须手动释放(使用 try-finally 推荐) | 手动 | Lock 更灵活,但更易出错 |
加餐
synchronized 不可中断:
public class SynchronizedInterruptExample {

    private static final Object lock = new Object();

    public static void main(String[] args) throws Exception {

        Thread t1 = new Thread(() -> {
            synchronized (lock) {
                System.out.println("T1 获取锁");
                try {
                    Thread.sleep(10000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        });

        Thread t2 = new Thread(() -> {
            System.out.println("T2 尝试获取锁");
            synchronized (lock) {
                System.out.println("T2 获取锁成功");
            }
        });

        t1.start();
        Thread.sleep(100);
        t2.start();
        Thread.sleep(1000);
        System.out.println("中断 T2");
        t2.interrupt();
    }
}
ReentrantLock的中断锁:
public class ThreadInterruptExample {

    private static final ReentrantLock lock = new ReentrantLock();

    public static void main(String[] args) throws Exception {

        Thread t1 = new Thread(() -> {
            lock.lock();
            try {
                System.out.println("T1 获取锁");
                Thread.sleep(10000);
            } catch (Exception e) {
                e.printStackTrace();
            } finally {
                lock.unlock();
            }
        });

        Thread t2 = new Thread(() -> {
            try {
                System.out.println("T2 等待锁");
                lock.lockInterruptibly();
                try {
                    System.out.println("T2 获取锁");
                } finally {
                    lock.unlock();
                }
            } catch (InterruptedException e) {
                System.out.println("T2 被中断");
            }
        });

        t1.start();
        Thread.sleep(100);
        t2.start();
        Thread.sleep(1000);
        System.out.println("主线程中断T2");
        t2.interrupt();
    }
}
思考题
- 锁的设计中为什么要记录可重入的次数?
- 请举出不可重入锁的一个例子。
并发编程的本质
回到最开始提出的三个核心问题——分工、同步、互斥。前面十几节把每个具体的技术都拆开看过了,这一节把它们收拢起来。
并发编程的本质,就是解决多线程之间的同步、互斥、分工问题。而所有技术手段,最终都可以归到两条路线上:加锁,或者不加锁。
加锁过程总结
从 synchronized 到 ReentrantLock,中间隔着管程模型和 AQS,但把加锁这件事串起来看,它始终是同一套流程:
第一步,尝试获取锁。
synchronized编译成monitorenter指令,由 JVM 在对象头(Mark Word)上记录锁状态ReentrantLock调用AQS.acquire(),用 CAS 尝试把state从 0 改成 1
两者的共同点是都先做一次乐观尝试:synchronized 有偏向锁/轻量级锁,AQS 有 tryAcquire。低竞争时根本不会真的进入内核挂起线程。
第二步,记录持有者。
拿到锁的线程把自己的标识写进去:
synchronized把线程 ID 写进ObjectMonitor的_ownerAQS把state置为 1,并把exclusiveOwnerThread指向自己
第三步,处理重入。
如果是同一个线程再次申请:
ObjectMonitor把_count加 1AQS把state加 1
这就是「可重入」的实现——不靠额外的标识,靠一个计数器。相应地,释放时也必须减到 0 才真正释放。
第四步,竞争失败则入队等待。
synchronized竞争失败先自旋,自旋失败后升级为重量级锁,线程进入ObjectMonitor的_EntryList,被挂起AQS把线程包成Node加入 CLH 队列尾部,然后LockSupport.park()挂起
注意两者的队列语义不同:ObjectMonitor 的 EntryList 是不公平的(唤醒后要重新抢),而 AQS 既支持公平也支持非公平,由 tryAcquire 里要不要检查前驱节点决定。
第五步,释放并唤醒。
monitorexit减少_count,减到 0 时唤醒_EntryList中的线程AQS.release()减少state,减到 0 时把队列中第一个有效节点唤醒(unparkSuccessor)
加锁的代价到底在哪? 不在「拿到锁」这个动作,而在竞争失败后的挂起与唤醒——那是一次系统调用,需要陷入内核、保存和恢复线程上下文。所以优化锁的核心思路永远是:尽量别让线程真的去排队。偏向锁、轻量级锁、自旋、CAS 无锁,都是在做这件事。
无锁保证线程安全总结
不加锁也能保证线程安全,思路只有两条:不共享可变状态,或者把「检查 + 更新」变成一次原子操作。
下面按「共享程度」从小到大排一遍。
单线程
最彻底的无锁:数据只被一个线程访问,自然不存在并发问题。
- 线程封闭:把对象限制在单个线程内使用,不发布出去
- 栈封闭:局部变量天生就在栈上,每个线程一份,天然安全
- 不可变对象:状态创建后不再改变,多个线程同时读没有风险
Java 里典型的不可变类:String、Integer 等包装类、LocalDate 等时间类。
让对象不可变需要满足几个条件:
- 对象创建后状态不能修改(所有字段
final) - 所有字段都是
final的 - 对象创建期间
this引用没有逸出(构造方法里别把this传出去) - 如果字段是引用类型,指向的对象本身也必须不可变
不可变对象的线程安全是「免费」的,但代价是每次修改都要创建新对象——String 拼接的坑就来自这里。
ThreadLocal
ThreadLocal 提供的是线程级别的变量副本:每个线程都有自己独立的一份,互不干扰。
它的用法很简单:
public class UserContext {

    private static final ThreadLocal<User> CURRENT = new ThreadLocal<>();

    public static void set(User user) {
        CURRENT.set(user);
    }

    public static User get() {
        return CURRENT.get();
    }

    public static void remove() {
        CURRENT.remove();
    }
}理解它必须理解它的设计:ThreadLocal 本身不存数据,数据存在 Thread 对象里。
每个 Thread 内部有一个 ThreadLocalMap 字段,ThreadLocal 实例只是作为这个 Map 的 key:
// Thread 类里
ThreadLocal.ThreadLocalMap threadLocals = null;

// ThreadLocal.get() 的实质
public T get() {
    Thread t = Thread.currentThread();
    ThreadLocalMap map = getMap(t);      // 拿当前线程自己的 Map
    if (map != null) {
        ThreadLocalMap.Entry e = map.getEntry(this);
        if (e != null) return (T) e.value;
    }
    return setInitialValue();
}
所以「线程隔离」不是 ThreadLocal 做的,是 Thread 自带的那个 Map 做的。这个设计的好处是:线程死了,副本跟着一起没,不需要额外的清理机制。
Spring 的事务管理用的就是它。回顾一下前面提到的场景:业务方法要在一个连接里完成「开启事务 → 执行多条 SQL → 提交」,「把连接当参数逐层传递」显然不现实。Spring 的做法就是在事务开始时把连接绑定到当前线程:
// DataSourceTransactionManager#doBegin 的核心
Connection newCon = dataSource.getConnection();
// 把连接和当前线程绑定
TransactionSynchronizationManager.bindResource(dataSource, new ConnectionHolder(newCon));
bindResource 内部就是一个 ThreadLocal。于是同一线程里任何地方调 DataSourceUtils.getConnection() 拿到的都是同一个连接,事务才能生效。
它的代价是内存泄漏。 ThreadLocalMap 的 key 是 ThreadLocal 实例本身的弱引用,而 value 是强引用:
Thread → ThreadLocalMap → Entry → (弱) ThreadLocal 实例
                                 → (强) value 对象
当外部的 ThreadLocal 强引用被清掉(比如类被卸载、或者 ThreadLocal 是局部变量),key 会被 GC 回收,但 value 还挂在 Entry 上——而 Entry 被 Map 强引用,Map 被 Thread 强引用。
在线程池场景下这尤其致命:线程是复用的,不会结束,于是这些 value 就永远留在堆里,积少成多就是 OOM。
标准解法是用完必须 remove():
try {
    UserContext.set(user);
    doBusiness();
} finally {
    UserContext.remove();   // 必须放在 finally
}特别注意:ThreadLocalMap 在 set/get 时确实会顺手清理一部分 key 为 null 的 Entry(探测式清理/启发式清理),但这是附带的、不可靠的——它只清理碰巧遇到的那些,不能指望它兜底。
final 关键字
final 修饰变量时,初衷是告诉编译器「这个变量生而不变」。
它的可见性由 JMM 的初始化安全性保证:正确构造的对象,只要没有 this 逸出,那么所有线程都能看到构造方法里对 final 字段的写入,不需要额外同步。
效果类似内存屏障,但实现上依赖编译器约束和硬件内存模型。在 x86 这种强内存模型上通常不需要显式屏障;在 ARM 等弱内存模型架构上,可能需要在 final 字段写入后插入 StoreStore 屏障。
CAS 乐观锁
CAS 的思路是把「检查 + 更新」压缩成一条硬件指令:只有当内存里的值等于预期值时才写入新值,整个过程不可分割。
// 伪代码,实际由 CPU 的 cmpxchg 指令完成
boolean cas(address, expect, update) {
    if (*address == expect) {
        *address = update;
        return true;
    }
    return false;
}它建立在一个前提上:大多数竞争其实并不发生。所以不做加锁这种悲观假设,而是先直接改,改了发现冲突再重试。
什么是原子操作
并发里的原子性和事务里的原子性是完全一样的概念。假定有两个操作 A 和 B 都包含多个步骤,如果从执行 A 的线程来看,当另一个线程执行 B 时,要么 B 全部执行完,要么完全不执行 B,执行 B 的线程看 A 也一样——那么 A 和 B 对彼此来说就是原子的。
用锁能实现原子操作,但 synchronized 是基于阻塞的:一个线程持有锁时,其他线程必须等待直到锁释放。CAS 想避免的正是这个等待。
三大问题
一、ABA 问题。
线程 1 读到值是 A,准备 CAS 成 C。这期间线程 2 把 A 改成 B,又改回 A。线程 1 的 CAS 成功执行——它以为值没变过,实际上已经被改了两轮。
多数场景下这无所谓(值对就行),但如果是链表节点之类的引用,中间那轮改动可能已经破坏了结构。
解法是给变量加递增的版本号(stamp),每次修改都同时更新版本号:
1A → 2B → 3A即使值又回到 A,版本号不同,CAS 也能识别出中间被改过。
Java 直接提供了这个机制:
AtomicStampedReference<V>(值 + int 版本号)AtomicMarkableReference<V>(值 + boolean 标记位,简化版)
用它们实现 CAS,就彻底杜绝 ABA 问题。
二、循环时间长开销大。
自旋 CAS 如果长时间不成功,会给 CPU 带来非常大的执行开销。这也是 LongAdder 存在的理由——它把单点热点拆成多个 Cell,让不同线程分散累加,最后汇总,避免了所有线程自旋在同一个变量上。
三、只能保证一个共享变量的原子操作。
CAS 原生只能保证单个共享变量的原子性:
- 对单个变量,可通过循环 CAS(自旋)实现原子更新
- 对多个共享变量,循环 CAS 无法保证整体原子性,此时需使用锁
- 替代方案:将多个共享变量合并为一个对象,通过
AtomicReference<V>对该对象整体进行 CAS,从而实现多变量的复合原子操作
Java 1.5 引入的 AtomicReference 正是为此设计:把任意数量的变量封装进一个对象,用一次引用 CAS 完成「多字段」原子更新,巧妙规避了传统锁。
Atomic 原子类
原子类是把 CAS 包装成易用 API 的产物,可以按用途分几类:
| 类别 | 代表类 |
|---|---|
| 基本类型 | AtomicInteger、AtomicLong、AtomicBoolean |
| 数组 | AtomicIntegerArray、AtomicLongArray、AtomicReferenceArray |
| 引用类型 | AtomicReference、AtomicStampedReference、AtomicMarkableReference |
| 字段更新器 | AtomicIntegerFieldUpdater、AtomicReferenceFieldUpdater |
| 累加器 | LongAdder、DoubleAdder、LongAccumulator |
以 AtomicInteger 为例,自增用的是「CAS + 自旋」:
public final int getAndIncrement() {
    return U.getAndAddInt(this, VALUE, 1);
}

// Unsafe 里
public final int getAndAddInt(Object o, long offset, int delta) {
    int v;
    do {
        v = getIntVolatile(o, offset);   // 读当前值
    } while (!compareAndSwapInt(o, offset, v, v + delta));  // CAS 失败就重试
    return v;
}
两个细节值得注意:
- 读用了
getIntVolatile,因为要保证读到的是最新值,否则v是过期的,CAS 必然失败 - 循环没有退避策略,高竞争下会大量空转——这正是
LongAdder要解决的问题
LongAdder 的思路是分散热点:内部维护一个 base 变量和一个 Cell[] 数组,没有竞争时直接 CAS base,出现竞争时把线程按哈希分散到不同的 Cell 上各自累加,求总和时再把它们加起来。
代价是 sum() 只能返回一个近似一致的快照(累加过程中其他线程还在写),所以 LongAdder 适合「统计计数」这类场景,不适合「需要精确值」的场景。
小结
| 路线 | 手段 | 适用条件 |
|---|---|---|
| 不共享 | 单线程、线程封闭、不可变对象 | 数据本来就只被一个线程用,或不需要修改 |
| 隔离副本 | ThreadLocal | 状态天然属于单个线程(连接、上下文),且用完能正确 remove |
| 不修改 | final | 对象构造后状态不变 |
| 原子操作 | CAS、原子类 | 单变量更新,竞争不激烈 |
| 分散热点 | LongAdder | 高频累加统计,不需要精确读 |
| 加锁 | synchronized、Lock | 多变量复合操作,或临界区较长 |
选型的顺序应该是:先问能不能不共享,再问能不能只读不改,再问能不能用原子操作解决单变量,最后才考虑加锁。
之所以把加锁放在最后,是因为它的代价最高——挂起和唤醒是内核级的操作。但也要清楚它的优势:锁是唯一能保证「多步操作整体原子」的手段,这恰恰是 CAS 做不到的。
到这里,Java 并发编程的核心问题就讲完了。往后再遇到并发问题,先回到这三个问题上问一遍:分工分清楚了吗?该同步的地方同步了吗?互斥的范围对不对?
实战篇
JUC中的并发容器与工具类
前面讲的都是「怎么自己保证线程安全」:加锁、用 volatile、写 CAS 循环。但工程里更常见的情况是——我需要一个线程安全的 HashMap,总不能每次都自己包一层 synchronized 吧。
java.util.concurrent(JUC)包就是为这个准备的。它提供两类东西:并发容器(线程安全的集合),和同步工具类(协调多线程的工具)。
从同步容器到并发容器
Java 的集合框架有四大类别:List、Set、Queue、Map。我们最熟悉的 ArrayList、LinkedList、HashMap 都不是线程安全的。
最早的解决方案是同步容器:Vector、Hashtable,以及 Collections.synchronizedXxx() 包装出来的 SynchronizedList 等。它们本质上就是给每个方法加 synchronized。
问题在于粒度:锁的是整个容器。多个线程哪怕读的是不同位置的数据,也要排队抢同一把锁,并发性被彻底削弱,吞吐量随线程数增加不升反降。
并发容器的思路是把锁的粒度做细,或者干脆在某些路径上不加锁:
| 并发容器 | 对应的非并发容器 | 主要用途 |
|---|---|---|
CopyOnWriteArrayList | ArrayList | 替代 Vector、SynchronizedList |
CopyOnWriteArraySet | HashSet | 替代 SynchronizedSet |
ConcurrentHashMap | HashMap | 替代 Hashtable、SynchronizedMap |
ConcurrentSkipListMap | TreeMap | 替代 SynchronizedSortedMap |
ConcurrentLinkedQueue | LinkedList | 无界非阻塞队列 |
BlockingQueue 家族 | — | 阻塞队列,另开一节 |
CopyOnWriteArrayList
CopyOnWriteArrayList 利用了一个观察:很多场景是读多写少的。既然读远多于写,那就让读操作完全不加锁,代价由写操作来承担。
原理:写的时候先把底层数组整体复制一份,在副本上修改,改完之后把新数组的引用赋回去。读操作永远读那个引用指向的数组,不加锁。
因为数组引用是 volatile 的,写线程改完之后,读线程能立刻看到新数组——这里就用上了我们前面讲的 volatile 可见性和传递性。
public boolean add(E e) {
    synchronized (lock) {
        Object[] es = getArray();
        int len = es.length;
        // 复制一份,长度 +1
        Object[] newElements = Arrays.copyOf(es, len + 1);
        newElements[len] = e;
        // 引用切换,volatile 写
        setArray(newElements);
        return true;
    }
}
读写分离带来的特性:
- 读不加锁,并发读性能极高
- 读写不互斥,读线程看到的是「读的那一刻」的那个快照,不会读到写了一半的状态
- 写操作开销大,每次都要复制整个数组,元素多的时候很昂贵
- 读到的数据可能不是最新的,因为写完成之前读方看到的还是旧数组
适用场景:
- 读多写少:像配置、白名单、监听器列表这种「偶尔变一次,频繁被读」的数据
- 不需要实时一致:读方拿到旧值可以接受
不适合的场景也很明确:写频繁、元素数量大、或者要求读到的一定是最新值。
一个实战场景:IP 黑名单
典型的用法是「频繁判断,偶尔更新」——比如 IP 黑名单拦截:
public class IpBlackList {

    private final CopyOnWriteArrayList<String> blackList = new CopyOnWriteArrayList<>();

    /** 高频调用:判断是否在黑名单中 */
    public boolean isBlocked(String ip) {
        return blackList.contains(ip);
    }

    /** 低频调用:新增封禁 */
    public void block(String ip) {
        blackList.addIfAbsent(ip);
    }
}
拦截是每次请求都要做的事,封禁可能一天才发生几次。这个读写比例正是 CopyOnWriteArrayList 的主场。
如果换成 Collections.synchronizedList(),每次拦截都要抢锁,所有请求串行化,性能会差一个数量级;而这个场景下 CopyOnWriteArrayList 的「读到的可能不是最新值」又完全可以接受。
fail-fast 与 fail-safe
CopyOnWriteArrayList 的迭代器还有一个重要特性,值得单独说,因为它经常出现在面试里。
ArrayList 的迭代器是 fail-fast 的:迭代过程中如果集合被修改,会立刻抛 ConcurrentModificationException。它靠维护一个 modCount 计数器实现,每次迭代时比对,发现不一致就抛异常——这是尽力而为的错误检测,不是并发安全的保证。
CopyOnWriteArrayList 的迭代器是 fail-safe 的:迭代器持有的是创建它那一刻的数组快照,整个迭代过程中都读这个快照。
CopyOnWriteArrayList<String> list = new CopyOnWriteArrayList<>();
list.add("a");
list.add("b");

for (String s : list) {
    list.add("c");        // 不会抛异常
    System.out.println(s); // 只会打印 a、b
}
所以 fail-safe 的代价是:迭代过程中看不到后来的修改。好处是永远不会抛并发修改异常,缺点是你以为的「遍历全部元素」可能只是某个历史时刻的全部元素。
ConcurrentHashMap
ConcurrentHashMap 是 JUC 里最常用的容器,它的实现思路随 JDK 版本演进了两次,每次都是在解决同一个问题:怎么让并发的读写尽量不互相阻塞。
Hashtable 和 SynchronizedMap 的做法是给整个表加一把锁,所有操作串行,读读之间也互斥。ConcurrentHashMap 要做的就是把锁的粒度降下来。
JDK 1.7:分段锁
JDK 1.7 引入了 Segment 的概念,把整个哈希表拆成若干段,每段是一把独立的可重入锁,段内还各自维护一个 HashEntry 数组:
ConcurrentHashMap
  └── Segment[](默认 16 个,每段一把 ReentrantLock)
        └── HashEntry[](每段自己的桶数组)
定位过程是两次哈希:先按 hash 的高位找到 Segment,再按低位找到段内的桶。不同 Segment 之间的读写是完全并行的,并发度等于 Segment 的数量(默认 16),理论上可以同时支持 16 个线程写入。
size() 也做了优化:不直接加锁统计,而是先尝试无锁累加,失败重试,重试到一定次数才给所有 Segment 加锁统计。
JDK 1.8:CAS + synchronized
JDK 1.8 放弃了 Segment,改用和 HashMap 一致的「数组 + 链表 + 红黑树」结构,并发控制换成更细粒度的方式:
- 空桶插入:用 CAS 直接写入,无锁
- 桶内已有节点:只对这一个桶的头节点加
synchronized,不影响其他桶 - 链表过长(超过 8)且数组长度达标时转红黑树,避免极端情况下的查询退化
粒度从「一段(多个桶)」降到了「一个桶」,并发度大幅提升,而且锁的实现也从 ReentrantLock 换成了内置的 synchronized(JVM 对偏向锁/轻量锁的优化让它在低竞争下更划算)。
复合操作的坑
有一点必须记住:ConcurrentHashMap 保证的只是单个操作的原子性,复合操作依然不安全。
// 错误:先检查再操作,两步之间可能被其他线程插入
if (!map.containsKey(key)) {
    map.put(key, value);
}
正确做法是用 putIfAbsent、computeIfAbsent、replace 这些原子复合方法:
// 正确
map.putIfAbsent(key, value);

// 或者
map.computeIfAbsent(key, k -> createValue(k));
这类方法内部是在同一个桶锁的保护下完成「检查 + 写入」的,不会被打断。
ConcurrentSkipListMap
对应 TreeMap,但 TreeMap 没法简单并发化——红黑树在插入时需要旋转平衡,旋转会影响一大片节点,很难把锁限制在局部。
ConcurrentSkipListMap 换了一种数据结构:跳表(Skip List)。
跳表是在有序链表基础上加多级索引:最底层是完整的有序链表,上面每层都是下层的「抽样」,查找时从最高层开始,能跳就跳:
Level 2:  1 ──────────────→ 9
Level 1:  1 ──────→ 5 ────→ 9
Level 0:  1 → 3 → 5 → 7 → 9   (完整链表)
查找一个值,从顶层往下走,每层做一次「跳到下一个节点还是下降一层」的判断。平均查找复杂度是 O(log n),和平衡树相当,但插入只需要改动局部的指针,并发控制容易得多,天然适合无锁实现。
跳表的缺点是实现比红黑树直观但常数项偏大,空间上因为多级索引也要多花一些。
需要并发 + 有序时(比如按时间排序的订单、排行榜)才用它;只要并发不需要有序,ConcurrentHashMap 更快。
同步工具类
并发容器解决的是「共享数据」,同步工具类解决的是「线程之间的协作」。它们都在 java.util.concurrent 下。
| 工具类 | 作用 | 典型场景 |
|---|---|---|
ReentrantLock | 可重入的显式锁 | 需要可中断、超时、公平锁、多条件变量时替代 synchronized |
Semaphore | 控制同时访问资源的线程数 | 接口限流、数据库连接池 |
CountDownLatch | 一个线程等 N 个线程完成 | 主线程汇总多个子任务的结果 |
CyclicBarrier | N 个线程互相等待到齐 | 分阶段并行计算,用人满发车理解 |
Exchanger | 两个线程交换数据 | 对账、双缓冲 |
Phaser | 可重用的、分阶段的屏障 | 多阶段任务,比 CyclicBarrier 更灵活 |
关于这几把锁本身的实现(AQS、条件变量、可重入),前面几节已经讲过,这里补充两个容易混的点。
CountDownLatch 与 CyclicBarrier 的区别
这是最常被问到的对比,核心差异有两点:
一是等待的方向不同。
CountDownLatch是「一个等多个」:主线程调await()等在那里,N 个工作线程各自countDown(),计数归零后主线程继续CyclicBarrier是「多个互相等」:N 个线程各自调await(),等到 N 个都到了,大家一起继续
二是能否重复使用。
CountDownLatch是一次性的,计数归零后就废了,想再用只能新建一个CyclicBarrier可以循环使用(名字里的 Cyclic 就是这个意思),每凑齐一轮就重置一次,还能传一个Runnable在每轮到齐时执行
类比一下:CountDownLatch 像等所有人到齐才能开饭,CyclicBarrier 像人满发车,发完一趟车还能继续等下一趟。
Semaphore
Semaphore 管的是许可(permit),可以理解成一个能容纳 N 个许可的池子:
- 线程执行前调
acquire()拿许可,拿到才能往下走 - 执行完调
release()还回去 - 许可被拿光后,
acquire()会阻塞直到有人归还
限流是它最典型的用法,用一个固定容量保护下游:
public class RateLimiter {

    // 最多允许 10 个线程同时调用下游接口
    private final Semaphore semaphore = new Semaphore(10);

    public String callDownstream() throws InterruptedException {
        semaphore.acquire();
        try {
            return doCall();
        } finally {
            semaphore.release();  // 必须放在 finally,否则异常时许可泄漏
        }
    }
}这里有个坑值得强调:release() 一定要放在 finally 里。如果业务代码抛异常导致许可没能归还,池子会越来越少,最后所有线程都阻塞在 acquire() 上——这种问题在压测之外的场景很难暴露,一上线就是死锁。
用 Semaphore(1) 还能当互斥锁用,效果类似 ReentrantLock,但不能重入。区别是 Semaphore 的获释不要求是同一个线程(A 线程 acquire、B 线程 release 是合法的),而 ReentrantLock 要求谁加锁谁解锁。
怎么选
| 需求 | 选择 |
|---|---|
| 并发 Map,不需要有序 | ConcurrentHashMap |
| 并发 Map,需要有序 | ConcurrentSkipListMap |
| 读多写少的 List | CopyOnWriteArrayList |
| 需要队列 | 见《阻塞队列》一节 |
| 一个线程等多个线程 | CountDownLatch |
| 多个线程互相等 | CyclicBarrier / Phaser |
| 控制并发度 | Semaphore |
| 两个线程交换数据 | Exchanger |
选型的核心永远是先想清楚读写比例和一致性要求:读多写少可以用空间换时间(CopyOnWrite),写多则要控制锁粒度(ConcurrentHashMap 的分桶),而一旦要求强一致,往往就得回到加锁的老路上。
阻塞队列
阻塞队列是线程池的底座,也是生产者—消费者模式最现成的实现。理解它,就理解了「为什么线程池一定得用阻塞队列」以及「为什么 LinkedBlockingQueue 比 ArrayBlockingQueue 吞吐量高」这类问题。
队列与阻塞队列
队列(Queue)大家都不陌生:先进先出,从尾部入队,从头部出队。Java 里 Queue 接口定义了三类操作,每类都有「抛异常」和「返回特殊值」两种形式:
| 操作 | 抛异常 | 返回特殊值 |
|---|---|---|
| 入队 | add(e) | offer(e)(失败返回 false) |
| 出队 | remove() | poll()(队空返回 null) |
| 查看队头 | element() | peek()(队空返回 null) |
阻塞队列(BlockingQueue)在此基础上加了「阻塞」这一种处理方式,因为它要解决的是线程协作问题:队满和队空不该是错误,而应该是「等一下」。
BlockingQueue 在 Queue 之上补了四个方法:
| 操作 | 阻塞 | 超时 |
|---|---|---|
| 入队 | put(e):队满则阻塞等待 | offer(e, time, unit):等一段时间,仍失败返回 false |
| 出队 | take():队空则阻塞等待 | poll(time, unit):等一段时间,仍失败返回 null |
于是四种处理策略凑齐了:抛异常、返回特殊值、无限阻塞、超时放弃。选哪种取决于业务上「队满/队空算不算异常」。
阻塞队列的价值在于它天然实现了生产者—消费者的完整语义:生产者满了就等,消费者空了就等,入队成功自动唤醒等待的消费者,出队成功自动唤醒等待的生产者。你不用再手写 wait / notifyAll,队列内部已经处理好了——而且处理得比手写更准确,因为它知道该唤醒的是生产者还是消费者。
JUC 里的阻塞队列家族
| 实现 | 数据结构 | 是否有界 | 特点 |
|---|---|---|---|
ArrayBlockingQueue | 数组 | 有界 | 必须指定容量,一把锁 + 两个条件变量 |
LinkedBlockingQueue | 链表 | 可选 | 默认 Integer.MAX_VALUE(相当于无界),两把锁 |
SynchronousQueue | 不存储 | — | 没有容量,一次配对一次传递 |
PriorityBlockingQueue | 堆 | 无界 | 按优先级出队,不是 FIFO |
DelayQueue | 堆 + 延迟 | 无界 | 只有到期元素才能出队 |
LinkedTransferQueue | 链表 | 无界 | 多了 transfer(),生产者可直接交给消费者 |
下面看两个最常用的。
ArrayBlockingQueue
基于数组的有界队列,容量在构造时确定,之后不可变。
// 构造时必须指定容量
BlockingQueue<Task> queue = new ArrayBlockingQueue<>(100);它的核心是一把锁 + 两个条件变量:
final ReentrantLock lock;
private final Condition notEmpty;  // 队列非空,消费者等这个
private final Condition notFull;   // 队列未满,生产者等这个

public void put(E e) throws InterruptedException {
    lock.lockInterruptibly();
    try {
        // 队列满了,在 notFull 上等待
        while (count == items.length) {
            notFull.await();
        }
        enqueue(e);
        // 入队成功,唤醒等待非空的消费者
        notEmpty.signal();
    } finally {
        lock.unlock();
    }
}

public E take() throws InterruptedException {
    lock.lockInterruptibly();
    try {
        // 队列空了,在 notEmpty 上等待
        while (count == 0) {
            notEmpty.await();
        }
        E e = dequeue();
        // 出队成功,唤醒等待未满的生产者
        notFull.signal();
        return e;
    } finally {
        lock.unlock();
    }
}
注意这里的两个细节,它们和上一节讲等待通知机制时说的完全对应:
while而不是if:被唤醒后条件可能又变了,必须重新检查- 两个条件变量:生产者和消费者各自等在不同的
Condition上,所以入队后只需要signal()唤醒一个消费者,不用signalAll()唤醒所有人
这正是 Condition 相比 wait/notify 的优势——Object 上只有一个等待队列,只能用 notifyAll 广播;Condition 可以按条件分队列,唤醒更精确。
数组实现的好处是内存连续、无额外节点开销,缺点是入队出队共用一把锁,读写不能并行。
LinkedBlockingQueue
基于链表的队列,默认容量是 Integer.MAX_VALUE——这实际上等于无界,除非你在构造时显式指定容量。
// 默认无界,务必慎用
BlockingQueue<Task> unbounded = new LinkedBlockingQueue<>();

// 指定容量,这才是有界队列
BlockingQueue<Task> bounded = new LinkedBlockingQueue<>(1000);
它和 ArrayBlockingQueue 最大的区别是用了两把锁:
/** 出队锁,保护 head */
private final ReentrantLock takeLock = new ReentrantLock();
private final Condition notEmpty = takeLock.newCondition();

/** 入队锁,保护 last */
private final ReentrantLock putLock = new ReentrantLock();
private final Condition notFull = putLock.newCondition();
入队只锁 putLock,出队只锁 takeLock,入队和出队可以真正并行。这是它吞吐量高于 ArrayBlockingQueue 的根本原因——在生产者消费者数量都不少的情况下,读写不再互相阻塞。
代价是复杂度上升:count 这个计数器被两把锁共享,所以它必须是 AtomicInteger;入队后如果发现队列还没满,还得再唤醒一个生产者(因为可能还有生产者在上一个时刻被阻塞着):
public void put(E e) throws InterruptedException {
    int c = -1;
    Node<E> node = new Node<>(e);
    final ReentrantLock putLock = this.putLock;
    final AtomicInteger count = this.count;
    putLock.lockInterruptibly();
    try {
        while (count.get() == capacity) {
            notFull.await();
        }
        enqueue(node);
        c = count.getAndIncrement();
        // 入队后还有空位,唤醒其他等待的生产者
        if (c + 1 < capacity) {
            notFull.signal();
        }
    } finally {
        putLock.unlock();
    }
    // c == 0 说明入队前队列是空的,可能有消费者在等,唤醒它
    if (c == 0) {
        signalNotEmpty();
    }
}
两者对比
ArrayBlockingQueue | LinkedBlockingQueue | |
|---|---|---|
| 数据结构 | 数组,预先分配 | 链表,按需创建节点 |
| 锁 | 一把锁 | 两把锁(入队/出队分离) |
| 吞吐量 | 较低 | 较高 |
| 内存 | 固定,无额外开销 | 每个元素一个 Node 对象 |
| GC 压力 | 小 | 大(频繁创建/回收节点) |
| 是否有界 | 必须指定容量 | 默认可视为无界 |
选择上:明确用有界队列就用 ArrayBlockingQueue(内存可控、GC 友好);追求吞吐量且能接受链表开销用 LinkedBlockingQueue,但一定要显式指定容量。
DelayQueue:延迟任务
DelayQueue 是一个无界队列,但只有到期(延迟时间已过)的元素才能被取出。队头永远是最早到期的那个元素。
它要求入队元素实现 Delayed 接口:
public interface Delayed extends Comparable<Delayed> {
    // 返回剩余延迟时间,<=0 表示已到期
    long getDelay(TimeUnit unit);
}最典型的场景是订单超时自动取消:
public class OrderDelayTask implements Delayed {

    private final String orderId;
    /** 任务到期时刻(毫秒时间戳) */
    private final long expireAt;

    public OrderDelayTask(String orderId, long delayMillis) {
        this.orderId = orderId;
        this.expireAt = System.currentTimeMillis() + delayMillis;
    }

    @Override
    public long getDelay(TimeUnit unit) {
        return unit.convert(expireAt - System.currentTimeMillis(), TimeUnit.MILLISECONDS);
    }

    @Override
    public int compareTo(Delayed o) {
        // 按到期时间排序,越早到期越靠前
        return Long.compare(this.expireAt, ((OrderDelayTask) o).expireAt);
    }
}
消费端就是一个 take() 循环——队列空或者队头没到期时,take() 会一直阻塞:
public void start() {
    new Thread(() -> {
        while (true) {
            try {
                // 队头没到期就一直阻塞,到点了才返回
                OrderDelayTask task = delayQueue.take();
                cancelOrder(task.getOrderId());
            } catch (InterruptedException e) {
                Thread.currentThread().interrupt();
                return;
            }
        }
    }, "order-expire").start();
}底层是优先队列(堆),所以它的出队顺序由 compareTo 决定而不是入队时间。这也意味着 DelayQueue 本身不保证 FIFO。
实际生产里,订单超时更常用的方案是 Redis 过期回调或者定时任务扫表,DelayQueue 的问题在于数据在内存里——服务重启就丢了,多实例也无法共享。它适合单机、可接受丢失的延迟场景(比如本地缓存刷新)。
如何选择
选型策略
| 需求 | 选择 |
|---|---|
| 明确容量、内存敏感 | ArrayBlockingQueue |
| 追求吞吐量 | LinkedBlockingQueue(指定容量) |
| 需要优先级 | PriorityBlockingQueue |
| 需要延迟执行 | DelayQueue |
| 线程之间直接传递、不存储 | SynchronousQueue |
线程池如何选队列
这一条很关键,因为它决定了线程池的行为——回想线程池的执行流程:核心线程满了之后任务先进队列,队列也满了才扩容到最大线程数。所以队列的选择直接改变了扩容时机。
JDK 的 Executors 给出了默认搭配:
| 线程池 | 使用的队列 |
|---|---|
FixedThreadPool | LinkedBlockingQueue(无界) |
SingleThreadExecutor | LinkedBlockingQueue(无界) |
CachedThreadPool | SynchronousQueue |
ScheduledThreadPool | DelayedWorkQueue |
这里的坑值得单独说:FixedThreadPool 和 SingleThreadExecutor 用的是无界队列,配合它们固定的 maximumPoolSize,会导致 maximumPoolSize 这个参数完全失效——因为队列永远满不了,永远不会触发扩容到最大线程数。
结果就是:任务持续堆积时,线程数停在核心线程数不变,队列无限增长,最终 OutOfMemoryError。
// 有 OOM 风险:无界队列 + 最大线程数形同虚设
ExecutorService pool = Executors.newFixedThreadPool(10);

// 正确做法:手动构造,显式指定有界队列和拒绝策略
ExecutorService pool = new ThreadPoolExecutor(
    10, 20,
    60L, TimeUnit.SECONDS,
    new ArrayBlockingQueue<>(1000),          // 有界
    Executors.defaultThreadFactory(),
    new ThreadPoolExecutor.CallerRunsPolicy() // 明确的拒绝策略
);
这就是「不建议用 Executors 快捷方法创建线程池」的核心原因。关于线程池的参数怎么设、拒绝策略怎么选,是下一节的内容。
线程池
线程池是并发编程里最「工程」的一环。它解决的问题很朴素:线程的创建和销毁都要消耗系统资源,如果每个任务都新建一个线程,高并发下光线程开销就能压垮服务。线程池把这些线程管起来复用,顺带解决了资源可控、任务排队、优雅关闭这些问题。
为什么需要线程池
自己 new Thread() 的问题:
- 开销大:创建一个线程要分配栈空间、在内核里注册,销毁也要回收,任务本身可能只跑几毫秒,开销比任务还大
- 不可控:请求量一上来就无限创建线程,很快耗尽内存或触发
OutOfMemoryError: unable to create new native thread - 没法管理:任务排队、超时、拒绝、优雅关闭这些都得自己实现
线程池把「线程的创建」和「任务的提交」解耦:线程预先创建好复用,任务来了丢进队列等线程来取。
七个核心参数
public ThreadPoolExecutor(int corePoolSize,        // 核心线程数
                          int maximumPoolSize,     // 最大线程数
                          long keepAliveTime,      // 非核心线程空闲存活时间
                          TimeUnit unit,           // 上述时间的单位
                          BlockingQueue<Runnable> workQueue,  // 任务队列
                          ThreadFactory threadFactory,        // 线程工厂
RejectedExecutionHandler handler) // 拒绝策略| 参数 | 含义 | 注意点 |
|---|---|---|
corePoolSize | 核心线程数 | 默认会一直存活(除非开了 allowCoreThreadTimeOut) |
maximumPoolSize | 最大线程数 | 队列满了才会往这个数扩容 |
keepAliveTime | 空闲存活时间 | 只对超出核心数的线程生效 |
workQueue | 任务队列 | 必须是阻塞队列,为何见下节 |
threadFactory | 线程工厂 | 可以在这里给线程起名,排查问题时非常有用 |
handler | 拒绝策略 | 队列满且线程数达上限后触发 |
threadFactory 这个参数经常被忽略,但生产环境强烈建议自定义:
ThreadFactory factory = new ThreadFactoryBuilder()
    .setNameFormat("order-pool-%d")   // 线程名带业务前缀
    .setUncaughtExceptionHandler((t, e) -> log.error("线程 {} 异常", t.getName(), e))
    .build();
默认工厂产生的线程名是 pool-1-thread-1 这种,线上看 jstack 时根本分不清是谁。
任务提交后发生了什么
这是线程池最核心的一段逻辑,execute() 里判断了三次:
public void execute(Runnable command) {
    int c = ctl.get();

    // 1. 线程数 < 核心线程数:直接新建核心线程执行
    if (workerCountOf(c) < corePoolSize) {
        if (addWorker(command, true)) return;
        c = ctl.get();
    }

    // 2. 线程数已达核心数:尝试入队
    if (isRunning(c) && workQueue.offer(command)) {
        // 入队成功,但线程池可能刚刚关闭,二次检查
        int recheck = ctl.get();
        if (!isRunning(recheck) && remove(command))
            reject(command);
        else if (workerCountOf(recheck) == 0)
            addWorker(null, false);
    }
    // 3. 入队失败(队列满):尝试扩容到最大线程数
    else if (!addWorker(command, false)) {
        // 4. 扩容也失败(已达 maximumPoolSize):拒绝
        reject(command);
    }
}
把它画成流程图更清楚:
提交任务
   │
   ├─ 线程数 < corePoolSize ? ──是──→ 新建核心线程执行
   │                             否
   ├─ 队列未满 ? ──────是──→ 入队,等空闲线程来取
   │                    否
   ├─ 线程数 < maximumPoolSize ? ──是──→ 新建非核心线程执行
   │                             否
└─ 执行拒绝策略顺序是「先核心、再入队、后扩容、最后拒绝」,这个顺序必须记牢,因为它和直觉相反:不是「核心满了就扩容」,而是「核心满了先排队,排不下才扩容」。
这个设计是有意的:新建线程的成本远高于排队。只有当队列也满了(说明任务积压严重),才值得付出新建线程的代价去救急。
反过来也解释了一个常见困惑:为什么把 maximumPoolSize 设得很大却没生效? 因为队列是无界的,永远满不了,第 3 步永远走不到。
五种状态如何流转
ThreadPoolExecutor 用一个 ctl(AtomicInteger)同时存状态和线程数:高 3 位是状态,低 29 位是线程数。这种「一个字段存两样东西」的做法保证了状态和线程数的原子性——不用加锁就能读到一致的一对值。
| 状态 | 值 | 含义 |
|---|---|---|
RUNNING | 111 | 接受新任务,处理队列中的任务 |
SHUTDOWN | 000 | 不接受新任务,但会处理完队列中的任务 |
STOP | 001 | 不接受新任务,不处理队列任务,并中断正在执行的线程 |
TIDYING | 010 | 所有任务已终止,线程数归零,准备执行 terminated() |
TERMINATED | 011 | terminated() 执行完毕 |
流转路径:
RUNNING ──shutdown()──→ SHUTDOWN ──队列空且线程空──→ TIDYING ──→ TERMINATED
   │
   └────shutdownNow()──→ STOP ────所有线程已退出────→ TIDYING ──→ TERMINATED
两个入口方法的区别就在这里:
shutdown():温和关闭。已提交的任务(包括队列里的)会执行完,只拒绝新任务shutdownNow():强制关闭。队列里的任务被丢弃(作为返回值返回),正在执行的线程被打上中断标记
注意 shutdownNow() 只是发中断信号,不等于任务立刻停止。如果任务里不响应中断(比如阻塞在 sleep 之外的地方,或者捕获了 InterruptedException 却没重新抛出),线程不会退出,TIDYING 也就到不了,线程池会一直卡在 STOP。
线程发生异常会被移出线程池吗
会,而且这是线程池一个容易踩的坑。
工作线程的主循环在 runWorker() 里:
final void runWorker(Worker w) {
    try {
        while (task != null || (task = getTask()) != null) {
            try {
                task.run();          // 执行任务
            } catch (RuntimeException | Error x) {
                thrown = x;
                throw x;             // 异常往上抛
            } finally {
                // 无论如何都要清理
                processWorkerExit(w, completedAbruptly);
            }
        }
    }
}
任务抛出未捕获的异常时:
run()抛出异常,退出while循环finally里执行processWorkerExit(),把这个Worker从工作线程集合里移除- 线程结束
问题在于:这一步只减不加。线程池不会自动补一个新线程顶上(除非触发条件满足),所以如果某个任务因为 NullPointerException 大量失败,池子里的线程会被一个个「吃掉」,最终线程池里一个线程都不剩,但队列里还积压着任务,表现为服务静默地不再处理任何请求。
这对生产环境非常致命,因为它不会报错,只是悄悄失去处理能力。
三种防护办法:
一、任务内部自己捕获异常(最常用):
executor.execute(() -> {
    try {
        doSomething();
    } catch (Exception e) {
        log.error("任务执行失败", e);  // 异常不外溢,线程不会被回收
    }
});
二、用 submit() 代替 execute()。submit() 会把任务包成 FutureTask,异常被捕获后存进 Future,只有调用 get() 时才会以 ExecutionException 形式抛出:
Future<?> future = executor.submit(() -> doSomething());
// 不调用 get(),异常就被静默吞掉了——这反而是另一个坑
注意 submit() 是双刃剑:异常不会杀掉线程,但如果你不调 get(),异常就彻底消失了。所以要么调用 get(),要么在任务内部打好日志。
三、设置 UncaughtExceptionHandler,通过自定义 ThreadFactory 挂上,兜住所有漏网的异常。
为什么必须用阻塞队列
线程池的 workQueue 类型是 BlockingQueue 而不是普通的 Queue,原因在于空闲线程的取任务逻辑。
工作线程用完一个任务后,需要去队列里拿下一个(getTask()):
private Runnable getTask() {
    for (;;) {
        // 超时控制,允许返回 null 让线程退出
        boolean timed = allowCoreThreadTimeOut || wc > corePoolSize;
        Runnable r = timed
            ? workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS)  // 非核心线程:超时去等
            : workQueue.take();                                    // 核心线程:无限阻塞等
        if (r != null) return r;
        // 超时还没拿到任务,说明该退出这个线程了
        if (timed && (wc > maximumPoolSize || ...)) {
            if (compareAndDecrementWorkerCount(c)) return null;
        }
    }
}如果队列是非阻塞的,take() 就无从谈起——取不到任务时只能返回 null,工作线程要么立刻退出(线程池白建了),要么就得自己写个循环轮询(CPU 空转)。
阻塞队列让空闲线程在队列上安静地等待,有新任务时被自动唤醒——这正好是上一节讲的等待通知机制在起作用。所以线程池「必须」用阻塞队列,是语义上的必然,不只是实现上的选择。
四种拒绝策略
队列满且线程数已达 maximumPoolSize 时,reject() 被调用。JDK 内置四种:
| 策略 | 行为 | 适用场景 |
|---|---|---|
AbortPolicy(默认) | 抛 RejectedExecutionException | 需要感知失败、让调用方决定怎么办 |
CallerRunsPolicy | 由提交任务的线程自己执行 | 需要平滑降级,不能丢任务、也不能抛异常 |
DiscardPolicy | 静默丢弃,不抛异常 | 任务可丢且能接受无感知(慎用) |
DiscardOldestPolicy | 丢掉队列里最老的一个,再尝试提交 | 只要最新数据 |
CallerRunsPolicy 值得多说一句,它是四种里最常用的:
public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
    if (!e.isShutdown()) {
        r.run();   // 谁提交谁执行
    }
}它的巧妙之处在于自带背压:让提交任务的线程(往往是 Tomcat 的工作线程)自己去跑这个任务,它就腾不出手提交新任务了,任务积压的速度自然降下来。这是一种「拒绝服务但不丢数据」的降级方案。
而 DiscardPolicy 和 DiscardOldestPolicy 在生产环境基本等于埋雷——静默丢任务,出问题时毫无痕迹,除非你明确知道这些任务可以丢。
实际项目里更常见的做法是自定义拒绝策略,至少把「被拒绝」这件事记录下来:
new RejectedExecutionHandler() {
    @Override
    public void rejectedExecution(Runnable r, ThreadPoolExecutor e) {
        log.warn("任务被拒绝,当前线程数 {},队列大小 {}",
                 e.getPoolSize(), e.getQueue().size());
        // 落库、发告警、或者降级到备用线程池
    }
}
线程数怎么设
这是被问得最多的问题,也是没有标准答案的问题。先看两类任务:
- CPU 密集型:任务几乎全在计算,线程数不应超过核数,否则只会增加上下文切换的开销
- 经验值:
N + 1(N 为核数),多出的 1 用于在偶发缺页时顶上
- 经验值:
- IO 密集型:任务大部分时间在等 IO,线程大部分时候是空闲的,可以多开
- 经验值:
2N,或者按公式N × (1 + 等待时间 / 计算时间)
- 经验值:
但这个公式的参考价值有限,原因很实在:
- 等待时间/计算时间没法准确测量,这个比值本身就得靠压测得出
- 任务往往不是纯 CPU 或纯 IO,一次请求可能既有计算又有数据库调用
- 瓶颈可能根本不在线程池:线程数加到 200 时,瓶颈早跑到数据库连接池或者下游接口上了
所以工程上的正确姿势是:先用经验值定个起点,再通过压测找拐点。
判断方法是看两组指标:
- 吞吐量:线程数增加时,QPS 是否继续上升?如果不再上升甚至下降,说明到拐点了
- 系统负载:CPU 使用率、上下文切换次数、以及线程池的
getQueue().size()(队列一直积压说明线程不够)
另外,压测时特别要盯住下游。线程池设得太大,压力会转移给数据库或下游服务——自己的 QPS 上去了,把别人打挂了,这种事故并不少见。线程数不是越大越好,它应该匹配整个链路上最窄的那个环节。
为什么不推荐 Executors
Executors 的快捷方法看着方便,但都有坑:
| 方法 | 问题 |
|---|---|
newFixedThreadPool | 无界队列,任务积压导致 OOM,且 maximumPoolSize 失效 |
newSingleThreadExecutor | 同上,无界队列 |
newCachedThreadPool | maximumPoolSize 是 Integer.MAX_VALUE,可能创建海量线程 |
newScheduledThreadPool | 队列无界,同样有 OOM 风险 |
共同的问题是关键参数被隐藏了,使用者看不到队列有多大、最大能开多少线程。
newCachedThreadPool 用 SynchronousQueue(不存储元素),每个任务都要立刻找到线程执行,找不到就新建。理论上线程数没有上限,任务量大时线程数会爆炸——不过它配合了 60 秒的空闲回收,所以实际风险比前两个小,但仍然不可控。
结论:手动 new ThreadPoolExecutor,把七个参数显式写清楚。 阿里 Java 开发手册也是这条建议——用 Executors 创建线程池,你不知道自己用的是无界队列。
优雅关闭
线上发版时线程池的处理方式,直接决定了会不会丢任务或报错。
public void shutdownGracefully(ThreadPoolExecutor pool, long timeout, TimeUnit unit) {
    pool.shutdown();                 // 1. 拒收新任务,队列里的继续处理
    try {
        // 2. 等待已有任务执行完
        if (!pool.awaitTermination(timeout, unit)) {
            // 3. 超时还没结束,强制关闭并打印未完成的任务
            List<Runnable> dropped = pool.shutdownNow();
            log.warn("强制关闭线程池,丢弃 {} 个任务", dropped.size());
        }
    } catch (InterruptedException e) {
        pool.shutdownNow();
        Thread.currentThread().interrupt();
    }
}标准流程是「shutdown() → awaitTermination() → 超时再 shutdownNow()」:
shutdown()拒收新任务,队列里的任务继续执行完awaitTermination()给一段缓冲时间(通常是几秒到几十秒)- 超时后
shutdownNow()强制中断,并把没执行的任务返回出来,至少能记个日志
这里要注意两点:
awaitTermination不调用的话,shutdown()是异步的,主线程不会等,直接往下走。注册成 JVM 钩子或者容器销毁回调才来得及shutdownNow()之后任务可能执行到一半被中断,所以业务代码里要对中断有正确响应(不能吞掉InterruptedException)
监控
线程池上线之后必须能观测,最少要暴露这几个指标:
ThreadPoolExecutor pool = ...;

// 当前线程数
pool.getPoolSize();
// 活跃线程数
pool.getActiveCount();
// 队列积压任务数 —— 最关键的指标
pool.getQueue().size();
// 历史完成任务总数
pool.getCompletedTaskCount();
// 历史最大线程数
pool.getLargestPoolSize();其中队列积压数是最该告警的:它持续增长意味着处理速度跟不上提交速度,接下来就是拒绝和雪崩。通常的做法是把这些指标通过 Micrometer 之类的库上报到监控系统,配一条「队列长度 > 阈值持续 1 分钟」的告警。
小结
- 七个参数里,
workQueue的选择最影响行为:队列容量决定了maximumPoolSize有没有机会生效 - 执行顺序是核心线程 → 入队 → 扩容 → 拒绝,不是「核心满了就扩容」
- 任务抛未捕获异常会吃掉工作线程,必须用 try-catch 或
Future.get()兜住 CallerRunsPolicy自带背压,是不丢任务的降级首选- 线程数没有万能公式,用压测找拐点,并盯住下游瓶颈
- 别用
Executors,手动构造并显式指定每一个参数
分布式锁的实现
前面讲的锁——synchronized、ReentrantLock、AQS——都只能锁住同一个 JVM 内的线程。单体应用里够用,但服务一旦拆成多个实例部署,这些锁就全部失效了:实例 A 和实例 B 是两个不同的 JVM,各自锁各自的,谁也不知道对方在干什么。
这时候需要的是能跨越进程、跨越机器的锁,也就是分布式锁。
为什么单机锁不够用
假设有一个扣库存的接口,部署了 3 个实例:
// 单机锁:只能挡住本实例内的并发
public synchronized void deductStock(Long skuId, int count) {
    int stock = getStock(skuId);
    if (stock >= count) {
        setStock(skuId, stock - count);
    }
}
同一时刻,实例 1 的线程拿到锁在读库存,实例 2 的另一个线程也在读同一个库存——两把锁互不相干。结果就是超卖。锁的作用域和需要互斥的资源范围不匹配了。
分布式锁要做的,是把「锁」这个状态放到一个所有实例都能访问到的、具备原子性的地方。
一个合格的分布式锁要满足什么
| 特性 | 要求 | 为什么 |
|---|---|---|
| 互斥 | 任意时刻只有一个客户端能持有锁 | 这是锁的定义 |
| 可重入 | 同一客户端的同一线程可以重复获取 | 否则递归或嵌套调用自己会死锁 |
| 锁超时 | 持有者崩溃时锁能自动释放 | 否则一个宕机就是永久死锁 |
| 高可用 | 存储锁的服务不能是单点 | 锁服务挂了会导致整个业务不可用 |
| 阻塞/非阻塞 | 支持等待获取,也支持快速失败 | 不同业务语义不同 |
| 锁标识 | 释放时必须校验持有者 | 防止误删别人的锁 |
这里的锁标识经常被忽略,但它是实现里最关键的一个细节:A 获取了锁但因为执行太久超时释放了,B 拿到了锁,这时 A 执行完去释放锁——如果 A 不校验就直接删,删掉的是 B 的锁。
基于数据库
最容易想到的方案——数据库是所有实例都能访问的,而且它自带事务和唯一约束。
唯一索引
利用唯一索引天然具有排他性:往一张带唯一索引的表里插一条记录,成功了就代表拿到锁,插失败(重复键)就代表锁被别人占着。
CREATE TABLE distributed_lock (
    id          BIGINT PRIMARY KEY AUTO_INCREMENT,
    lock_key    VARCHAR(64)  NOT NULL COMMENT '锁的标识,如 order:12345',
    holder      VARCHAR(128) NOT NULL COMMENT '持有者标识:机器 IP + 线程 ID',
    expire_at   BIGINT       NOT NULL COMMENT '过期时间戳',
    UNIQUE KEY uk_lock_key (lock_key)
);
加锁就是一次 insert:
public boolean tryLock(String lockKey, String holder) {
    try {
        jdbcTemplate.update(
            "INSERT INTO distributed_lock (lock_key, holder, expire_at) VALUES (?, ?, ?)",
            lockKey, holder, System.currentTimeMillis() + 30_000);
        return true;
    } catch (DuplicateKeyException e) {
        // 插入失败说明已经有锁了
        return false;
    }
}
解锁就是 delete,但必须带上 holder 条件:
public void unlock(String lockKey, String holder) {
    // WHERE 里带 holder,防止误删别人的锁
    jdbcTemplate.update(
        "DELETE FROM distributed_lock WHERE lock_key = ? AND holder = ?",
        lockKey, holder);
}
还要有个兜底:持有者崩溃后记录不会自己消失,需要一个定时任务定期清理 expire_at 已过期的行。
优点:实现简单,不引入新组件,靠数据库事务保证可靠性。
缺点:
- 性能差:数据库操作是磁盘级别的,QPS 上不去,而且锁竞争会直接转化为数据库的写竞争
- 有锁表风险:高并发下大量
insert同一行会造成行锁等待甚至死锁 - 没有阻塞语义:拿不到只能自己轮询重试,轮询间隔不好定——太密浪费资源,太疏响应慢
- 不够可靠:数据库本身的主从切换、连接超时都会影响锁的正确性
所以数据库锁一般是兜底方案或者并发量很低的场景才用。
悲观锁与乐观锁
顺带提两种更常见的数据库层面并发控制,它们不是严格意义的分布式锁,但常被拿来对比:
悲观锁:SELECT ... FOR UPDATE,直接给行加排他锁,其他事务必须等。
BEGIN;
SELECT stock FROM product WHERE id = 1 FOR UPDATE;  -- 锁住这一行
UPDATE product SET stock = stock - 1 WHERE id = 1;
COMMIT; -- 释放适合写冲突频繁的场景,但要注意必须走索引,否则会退化成表锁。
乐观锁:不加锁,靠版本号在提交时校验有没有被别人改过。
UPDATE product
SET stock = stock - 1, version = version + 1
WHERE id = 1 AND version = 5; -- 版本不匹配就更新 0 行int rows = jdbcTemplate.update(sql, stock, version);
if (rows == 0) {
// 更新失败,说明被别人抢先改了,重试
}乐观锁适合读多写少(冲突少,重试成本低),它在业务上比分布式锁更轻量——很多「超卖」问题用一行 WHERE stock >= count 就能解决,根本不需要锁。
基于 Redis
Redis 的性能是数据库的另一个量级,而且它天然适合存这种「临时状态」。这是目前最主流的方案。
setnx + 过期时间
核心是两个命令:SETNX(SET if Not eXists,不存在才设置)和 EXPIRE(过期时间)。
SETNX lock_key holder_value    # 返回 1 表示拿到锁,0 表示锁已被占用
EXPIRE lock_key 30 # 30 秒后自动释放,防止持有者崩溃导致死锁但这两条命令分开写是有问题的:如果执行完 SETNX 之后、EXPIRE 之前服务宕机了,这把锁就永远不会过期,变成死锁。
Redis 2.6.12 之后可以用一条原子命令搞定:
SET lock_key holder_value NX PX 30000
# NX:不存在才设置
# PX 30000:30 秒后自动过期
在 Java 里:
public boolean tryLock(String lockKey, String holder, long expireMillis) {
    Boolean ok = redisTemplate.opsForValue().setIfAbsent(
        lockKey, holder, Duration.ofMillis(expireMillis));
    return Boolean.TRUE.equals(ok);
}
解锁必须用 Lua
解锁看起来就是 DEL lock_key,但这里藏着前面提到的误删别人的锁问题:
时刻 T1:A 拿到锁,过期时间 30s
时刻 T2:A 执行了 35s(还没结束),锁自动过期
时刻 T3:B 拿到锁
时刻 T4:A 执行完了,执行 DEL lock_key  → 删掉了 B 的锁!
时刻 T5:C 拿到锁 → 现在 B 和 C 同时持有锁
解法有两步:
第一步,值里存持有者标识,删之前先校验。但「校验 + 删除」是两个操作,中间可能被其他命令插入,所以:
第二步,用 Lua 脚本保证校验和删除的原子性:
private static final String UNLOCK_SCRIPT =
    "if redis.call('get', KEYS[1]) == ARGV[1] then " +
    "    return redis.call('del', KEYS[1]) " +
    "else " +
    "    return 0 " +
    "end";

public boolean unlock(String lockKey, String holder) {
    // 同一段脚本在 Redis 里是原子执行的
    Long result = redisTemplate.execute(
        new DefaultRedisScript<>(UNLOCK_SCRIPT, Long.class),
        Collections.singletonList(lockKey),
        holder);
    return result != null && result == 1L;
}
Lua 脚本在 Redis 里是原子执行的,执行期间不会插入其他命令,所以「判断是不是自己的锁」和「删除」这两步不会被打断。
锁续期与看门狗
设置了过期时间,新的问题又来了:如果业务执行时间超过锁的过期时间怎么办?
30 秒的锁,业务跑了 40 秒,锁在第 30 秒就被别人拿走了,互斥性被破坏。
思路是自动续期:锁还在用的时候,定期把过期时间往后延长。Redisson 的「看门狗」(watchdog)就是干这个的:
RLock lock = redissonClient.getLock("order:12345");
lock.lock();          // 不传过期时间,默认 30 秒,并启动看门狗
try {
    // 业务逻辑
} finally {
    lock.unlock();
}
看门狗的机制:
- 加锁成功时,默认过期时间 30 秒
- 同时起一个后台定时任务,每 10 秒(过期时间的 1/3)检查锁是否还持有
- 如果还持有,就把过期时间重置回 30 秒
- 直到显式
unlock(),定时任务取消,锁被删除
注意最后一点很重要:看门狗只在没有显式指定过期时间时生效。如果你写 lock.lock(30, TimeUnit.SECONDS),Redisson 认为你明确知道业务要跑多久,不会再自动续期。
不过实际项目里更稳妥的做法往往是不用看门狗,而是合理估计业务耗时并设置足够长的过期时间——因为看门狗本身依赖客户端存活,客户端网络分区时续期会失败,而续期失败的表现就是锁提前释放。
可重入
用 Redis 实现可重入,需要记录「谁持有了锁、持有多少次」。数据结构上要用 Hash:
lock_key → { holder_value: 重入次数 }加锁逻辑变成:如果锁不存在就创建并计数为 1;如果锁存在且持有者是自己,计数 +1;否则失败。解锁时计数 -1,减到 0 才真正删除。这一整套同样要用 Lua 保证原子性——Redisson 的 RLock 已经实现好了,自己手写很容易出错。
Redlock 与它的争议
Redis 主从架构下,锁存在丢锁风险:
1. 客户端 A 向 master 写入锁
2. master 还没来得及把数据同步给 slave,就宕机了
3. slave 被提升为新 master ——新 master 上没有这把锁
4. 客户端 B 来加锁,成功了
5. A 和 B 同时持有锁
Redis 作者 antirez 提出了 Redlock 算法来应对:向 N 个(通常 5 个)相互独立的 Redis 实例申请加锁,只有在超过半数(N/2 + 1)的实例上成功、且总耗时小于锁的有效时间,才算真正拿到锁。
但分布式系统专家 Martin Kleppmann 提出了著名质疑,核心论点是:
- Redlock 没有 fencing token 机制,无法解决「锁过期后旧持有者仍在写」的问题
- 它依赖各实例的时钟大致同步,而时钟漂移在分布式系统里不可靠
- 对效率场景(避免重复劳动)它够用,但对正确性场景(必须严格互斥)它不够
这个争论到目前也没有公认结论。工程上的务实态度是:
- 如果锁只是为了避免重复计算、控制成本,Redlock 或单实例 Redis 加合理超时足够
- 如果锁关系到数据正确性(比如扣款),应该引入 fencing token——每次获取锁返回一个单调递增的编号,写数据时带上它,存储端拒绝比已见过的编号更小的写入。这才是分布式锁的正确打开方式,而它需要在被保护的资源侧做校验,光靠锁服务本身做不到
基于 ZooKeeper
ZooKeeper 的强一致性让它天然适合做协调服务。
临时顺序节点实现公平锁
ZK 的节点类型里,临时节点(Ephemeral)在客户端会话断开时会自动删除——这天然解决了「持有者崩溃后锁不释放」的问题,不需要过期时间那套机制。
设计思路一:所有申请者都去创建同一个临时节点,创建成功的拿到锁。
所有客户端 competing for /lock
  ├─ 客户端 A:create /lock 成功 → 拿到锁
  ├─ 客户端 B:create /lock 失败(节点已存在)→ 等待
└─ 客户端 C:create /lock 失败 → 等待问题是所有等待者都 watch 这个节点:锁释放(节点被删除)时,所有等待者同时被唤醒,然后一起去抢——这就是惊群效应(Herd Effect),一瞬间的流量尖峰打在 ZK 上。
设计思路二(正常做法):用临时有序节点。
每个申请者创建一个临时有序节点,节点名带自动递增的序号:
/create_lock/lock-0000000001   ← 客户端 A
/create_lock/lock-0000000002   ← 客户端 B
/create_lock/lock-0000000003 ← 客户端 C规则是:序号最小的那个持有锁。其他客户端不 watch 锁节点,而是 watch 自己前一个序号的节点:
- A 拿到锁(序号最小)
- B 只监听
lock-0000000001,也就是 A 的节点 - C 只监听
lock-0000000002,也就是 B 的节点
A 释放锁 → 只有 B 被唤醒 → B 成为序号最小的 → B 拿到锁 → C 继续等。
每个客户端只被前一个节点唤醒,没有惊群,而且是公平锁(先到先得,按序号排队)。
临时节点的自动清理
这套机制有一个前提:客户端会正确关闭会话。如果客户端进程被 kill -9,TCP 连接不会立刻断开,ZK 要等到会话超时(默认 2×tickTime)才发现,这段时间锁仍然被占着。
所以用 ZK 做锁时,sessionTimeout 的设置需要权衡:设太短,网络抖动会误判会话失效导致锁被提前释放;设太长,客户端真宕机时要等很久。
Curator InterProcessMutex
实际开发中不建议自己造轮子,直接用 Curator 提供的实现:
CuratorFramework client = CuratorFrameworkFactory.newClient(
    "zk1:2181,zk2:2181,zk3:2181",
    new ExponentialBackoffRetry(1000, 3));
client.start();

// InterProcessMutex 是可重入的分布式锁
InterProcessMutex lock = new InterProcessMutex(client, "/order-lock-12345");

if (lock.acquire(10, TimeUnit.SECONDS)) {   // 支持超时获取
    try {
        doBusiness();
    } finally {
        lock.release();   // 必须在 finally 里释放
    }
}
InterProcessMutex 内部用的正是临时顺序节点 + watch 前一个节点的方案,并且实现了可重入(内部记录重入次数)。
ZK 锁的优缺点
优点:
- 高可用、可重入、阻塞锁,能解决锁失效导致的死锁问题(临时节点自动清理)
- 强一致性,不会出现 Redis 主从切换那样的丢锁
- 天然公平(有序节点按序排队)
缺点:
- 性能不如 Redis:每次加锁解锁都要在集群里创建/删除节点并同步给所有 follower,这是写操作,开销远大于 Redis 的一次内存操作
- 需要额外维护一套 ZK 集群
- 会话超时的参数不好调
选型上的结论:
在高性能、高并发的场景下,不建议使用 ZooKeeper 分布式锁。而由于 ZooKeeper 的高可靠性,在并发量不是太高的场景中,还是推荐使用 ZooKeeper 分布式锁。
方案对比与选型
| 数据库 | Redis | ZooKeeper | |
|---|---|---|---|
| 性能 | 低 | 高 | 中 |
| 可靠性 | 中 | 中(主从切换有丢锁风险) | 高 |
| 是否阻塞 | 需自己轮询 | 需自己轮询(Redisson 已封装) | 支持阻塞等待 |
| 可重入 | 需自己实现 | 需自己实现(Redisson 已封装) | Curator 已实现 |
| 死锁风险 | 需定时清理 | 靠过期时间 | 临时节点自动清理 |
| 公平性 | 非公平 | 非公平 | 公平 |
| 额外依赖 | 无需(已有 DB) | 已有 Redis | 需部署 ZK |
| 实现复杂度 | 简单 | 简单(用 Redisson 更简单) | 需 Curator |
选型的经验法则:
- 已经有 Redis,追求性能 → Redis + Redisson(
RLock) - 对正确性要求极高、并发量不大 → ZooKeeper + Curator
- 不想引入新组件、并发量很低 → 数据库唯一索引
- 涉及资金等强一致场景 → 除了选 ZK 或 Redisson,还要在被保护的资源侧加 fencing token 校验
最后一句判断标准值得单独强调:在任何分布式锁方案里,锁的超时释放都意味着「锁可能提前失效」。如果你的业务绝对无法容忍两个线程同时进入临界区,那么锁本身不足以保证正确性——必须由数据层做最终校验。 比如扣库存,即使锁失效,UPDATE ... WHERE stock >= count 也能兜住;而如果只有锁这一道防线,那就是在赌。
小结
- 分布式锁的本质是把锁的状态放到一个所有实例共享、且具备原子操作能力的存储上
- 三个必答题:互斥怎么保证、超时怎么处理、释放时怎么确认是自己的锁
- Redis 方案里
SET NX PX保证加锁原子性,Lua 脚本保证解锁原子性,这两点是关键 - ZK 方案的核心是临时顺序节点 + 只 watch 前一个节点,避免了惊群,同时天然公平
- 所有方案都逃不开「锁超时 = 锁可能提前失效」这个根本限制,最终一致性要靠数据层兜底
番外篇
MySQL 是如何处理并发问题的?
前面十几节讲的都是 JVM 内部的并发。但一个 Java 服务真正的并发压力,最后几乎都会落到数据库上——几百个线程同时下单、扣库存、更新订单状态。数据库面对的是完全不同量级的并发:几千个连接、跨进程、跨机器、还要保证数据落盘不丢。
MySQL(准确说是 InnoDB)处理并发的思路和 JVM 一脉相承:能不加锁就不加锁,必须加锁就把粒度做细。这一节看它是怎么做的。
并发事务会带来什么问题
先说清楚要解决什么。多个事务并发执行时,可能出现四类问题,严重程度递减:
| 问题 | 含义 | 例子 |
|---|---|---|
| 脏写 | 一个事务覆盖了另一个未提交事务的修改 | 两个事务同时把余额改成 100,后写的覆盖了先写的 |
| 脏读 | 读到了另一个事务未提交的数据 | A 读到 B 改了一半的余额,B 随后回滚了 |
| 不可重复读 | 同一事务内两次读同一行,结果不同 | A 第一次读到 100,B 改成 200 提交,A 再读变成 200 |
| 幻读 | 同一事务内两次范围查询,结果集行数不同 | A 数出 10 条记录,B 插入 1 条提交,A 再数变成 11 条 |
注意「不可重复读」和「幻读」的区别:前者是同一行的值变了,后者是凭空多出(或少掉)了几行。这个区别很重要,因为它决定了两者用不同的手段解决——前者靠版本快照,后者只能靠锁住范围。
四种隔离级别
SQL 标准定义了四种隔离级别,本质是在「隔离性」和「并发性」之间做取舍:
| 隔离级别 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|
| 读未提交(Read Uncommitted) | 可能 | 可能 | 可能 |
| 读已提交(Read Committed,RC) | 不可能 | 可能 | 可能 |
| 可重复读(Repeatable Read,RR) | 不可能 | 不可能 | 理论上可能 |
| 串行化(Serializable) | 不可能 | 不可能 | 不可能 |
规律很清楚:隔离级别越严格,并发副作用越小,但代价越大——因为隔离实质上是让事务「串行化」执行,这本身就与并发矛盾。
MySQL 的默认级别是可重复读(RR),而且通过间隙锁把幻读也解决了,所以实际上 RR 这一行的「理论上可能」在 MySQL 里也不成立。这和 Oracle、PostgreSQL 默认用 RC 不同,是 MySQL 的一个特点。
锁的分类
MySQL 的锁可以从三个维度看:
按性能分:
- 乐观锁:用版本号对比或 CAS,适合读多的场景
- 悲观锁:直接加锁,适合写多的场景——写操作多的时候,乐观锁会导致比对次数过多,反而更慢
按粒度分:表锁、页锁、行锁。
按类型分:
- 读锁(共享锁,S 锁):多个读可以同时进行,互不影响
- 写锁(排他锁,X 锁):写未完成前阻断其他读锁和写锁
- 意向锁(I 锁):这是个特殊的存在,见下
-- 加读锁(共享锁)
select * from T where id = 1 lock in share mode;

-- 加写锁(排他锁)
select * from T where id = 1 for update;
意向锁为什么存在
意向锁是针对表锁的,而且是 MySQL 自己加的,你不用管。
设想一个场景:事务 A 给某一行加了行锁,事务 B 想给整张表加表锁。B 必须先确认表里没有任何行锁——如果没有意向锁,B 就得逐行扫描判断,表里几百万行的话这个检查本身就废掉了。
意向锁解决的就是这个问题:当有事务给行加了共享锁或排他锁时,同时给表打一个标记。B 想加表锁时,直接读这个标记就知道该不该加,不用逐行检查。
- 意向共享锁(IS):对表加共享锁之前,先获取 IS
- 意向排他锁(IX):对表加排他锁之前,先获取 IX
所以意向锁不参与数据的读写冲突判断,它只服务于「加表锁时的快速检查」。
表锁与行锁
表锁每次锁住整张表:
- 开销小,加锁快;不会出现死锁
- 锁定粒度大,冲突概率最高,并发度最低
- 典型场景:整表数据迁移
手动操作:
-- 加表锁
lock table 表名称 read(write), 表名称2 read(write);
-- 查看表上加过的锁
show open tables;
-- 释放
unlock tables;行锁每次锁住一行:
- 开销大,加锁慢;会出现死锁
- 锁定粒度最小,冲突概率最低,并发度最高
InnoDB 相比 MyISAM 的两大不同就是:支持事务,支持行级锁。这也是为什么现在基本只用 InnoDB——当并发量高的时候,InnoDB 的整体性能相比 MyISAM 有明显优势。
但行锁有个容易踩的坑:InnoDB 的行锁实际是加在索引上的,不是加在行记录上的。它是在索引对应的索引项上做标记。
推论很重要:如果查询没有走索引,行锁会退化成表锁。
-- 假设 name 字段没有索引
select * from account where name = 'lilei' for update;这时其他会话对该表任意一行做修改都会被阻塞——因为 MySQL 扫的是全表,扫过哪些索引就锁哪些,最终等于锁了整张表。
这个退化行为在 RR 级别下会发生,RC 级别下不会。原因在下一节。
间隙锁与临键锁
为什么 RR 级别下无索引会锁全表
RR 级别需要解决不可重复读和幻读。在遍历扫描聚集索引记录时,为了防止扫过的索引被其他事务修改(不可重复读),或者防止间隙被其他事务插入记录(幻读),MySQL 的处理办法是:把所有扫描过的索引记录和间隙都锁上。
全表扫描时,扫过的记录和间隙就是整张表,于是等于锁了全表。注意这里并不是「直接加表锁」——因为不一定能加上(可能其他事务已经锁了表里的其他行),所以才用逐行加锁的方式达到同样的效果。
间隙锁
间隙锁锁的是两个值之间的空隙,只在可重复读隔离级别下生效。
假设 account 表里有 id 为 3、10、20 的记录,那么间隙就是三段:
(-∞, 3) (3, 10) (10, 20) (20, +∞)执行:
select * from account where id = 18 for update;18 并不存在,但它落在 (10, 20) 这个间隙里。于是其他 Session 无法在这个间隙范围内插入任何数据。
再执行:
select * from account where id = 25 for update;则 (20, +∞) 这个间隙被锁住,其他 Session 无法在这个范围内插入。
规律是:只要在间隙范围内锁了一条不存在的记录,就会锁住整个间隙范围(但不锁边界记录)。这样就防止了其他事务在间隙里插入数据,幻读问题被解决了——这也是 MySQL 的 RR 级别比标准 RR 更强的原因。
间隙锁还有副作用:它锁的是「空隙」而不是「存在的数据」,所以两个事务可以同时持有同一段间隙的间隙锁(都是共享性质的),但一旦有人要插入就会冲突。这也是间隙锁容易造成死锁的原因。
临键锁
Next-Key Lock = 行锁 + 间隙锁的组合。InnoDB 在 RR 级别下默认用的就是临键锁,它锁住的是「记录本身 + 记录前面的间隙」,是一个左开右闭区间。
锁等待分析与死锁
排查锁问题靠这几个手段:
-- 行锁争夺的整体情况
show status like 'innodb_row_lock%';
其中关键的三个指标:
Innodb_row_lock_time_avg:等待平均时长Innodb_row_lock_waits:等待总次数Innodb_row_lock_time:等待总时长
如果等待次数很高、每次等待时长也不小,就说明锁竞争已经很严重了,需要针对性地优化。
查看具体的锁信息:
-- 查看事务
select * from INFORMATION_SCHEMA.INNODB_TRX;
-- 查看锁(8.0 之后换成 performance_schema.data_locks)
select * from INFORMATION_SCHEMA.INNODB_LOCKS;
-- 查看锁等待(8.0 之后换成 performance_schema.data_lock_waits)
select * from INFORMATION_SCHEMA.INNODB_LOCK_WAITS;

-- 释放锁(trx_mysql_thread_id 从 INNODB_TRX 里查)
kill trx_mysql_thread_id;

-- 查看锁等待详细信息、死锁日志
show engine innodb status;
死锁复现很简单,两个事务按相反顺序锁两行即可:
set tx_isolation = 'repeatable-read';

-- Session_1
select * from account where id = 1 for update;
select * from account where id = 2 for update;   -- 阻塞

-- Session_2
select * from account where id = 2 for update;
select * from account where id = 1 for update;   -- 死锁
大多数情况下 MySQL 会主动检测死锁并回滚其中一个事务(选择代价较小的那个)。但有些情况检测不到,这时只能通过 show engine innodb status 分析日志,找到对应的事务线程 id 再 kill 掉。
死锁无法根除,但可以减少:
- 按固定顺序访问数据:所有事务都按 id 升序加锁,就不会形成环
- 尽量缩小事务范围:事务越小,持有锁的时间越短
- 加锁的 SQL 放在事务最后执行
锁优化实践
这几条是实战中最有用的:
- 尽可能让所有数据检索都通过索引来完成——避免无索引导致行锁升级为表锁
- 合理设计索引,尽量缩小锁的范围
- 尽可能减少检索条件范围,避免触发间隙锁
- 尽量控制事务大小,减少锁定资源量和时间长度
- 尽可能用低的事务隔离级别(如果业务允许 RC)
MVCC:能不加锁就不加锁
上面讲的都是加锁。但真正让 MySQL 能扛住高并发读的,其实是 MVCC(多版本并发控制)——读写互不阻塞。
RR 级别下「同一事务内多次查询结果相同」,靠的就是 MVCC。它让对一行数据的读和写默认不加锁互斥,避免了频繁的锁竞争。(而串行化级别为了更高的隔离性,是通过把所有操作都加锁互斥来实现的——代价就是并发度急剧下降。)
MySQL 在读已提交和可重复读两个级别下都实现了 MVCC。
undo 日志版本链
一行数据被多个事务依次修改后,MySQL 会保留每次修改前的数据作为 undo 回滚日志,并用两个隐藏字段把它们串成一条历史版本链:
trx_id:改出这个版本的事务 IDroll_pointer:指向上一个版本
当前行 → [trx_id=101, 值=300] → [trx_id=99, 值=200] → [trx_id=95, 值=100]ReadView
读的时候该看哪个版本?靠 ReadView(一致性视图)来判断。
在可重复读级别下,事务中第一次执行查询 SQL 时生成 ReadView,这个视图在事务结束前永远不变——所以同一事务内多次查询结果一致。
在读已提交级别下,每次执行查询都重新生成 ReadView,所以每次都能读到已提交的最新数据。
ReadView 由两部分组成:
- 生成时所有未提交事务的 ID 数组(其中最小的是
min_id) - 已创建的最大事务 ID(
max_id)
版本可见性判断
拿到版本链后,从最新版本开始逐条和 ReadView 比对:
版本的 trx_id 落在 | 判定 | 原因 |
|---|---|---|
trx_id < min_id | 可见 | 生成视图时这些事务都已提交 |
trx_id > max_id | 不可见 | 由将来启动的事务生成(若正是自己则可见) |
min_id <= trx_id <= max_id,且在未提交数组中 | 不可见 | 由未提交的事务生成(若正是自己则可见) |
min_id <= trx_id <= max_id,且不在数组中 | 可见 | 已提交事务生成 |
一句话概括:凡是 ReadView 生成的那一刻还没提交的事务,改出来的版本都看不见。
删除也是特殊版本的更新
删除可以理解为 update 的特殊情况:把版本链上最新的数据复制一份,trx_id 改成删除操作的事务 ID,同时在这条记录的头信息里把 deleted_flag 标记为 true。查询时按上述规则找到对应记录,如果 deleted_flag 为 true,表示已被删除,不返回数据。
一个容易搞错的点
begin;
-- 此时并没有真正开始事务!
begin / start transaction 并不是事务的起点。要到执行它们之后的第一个修改操作或加排他锁操作(比如 select ... for update)时,事务才真正启动,才向 MySQL 申请真正的事务 ID。MySQL 内部严格按照事务的启动顺序分配 ID。
这解释了一个常见现象:一个 begin 之后长期只读不写的事务,并不会阻塞别人,因为它还没有真正开始。
快照读与当前读
理解了 MVCC,还要理解这两者的区别,否则会被 RR 的行为搞晕:
- 快照读:普通的
select,读的是历史版本(走 MVCC) - 当前读:
insert、update、delete,以及select ... for update、lock in share mode,读的是当前版本(加锁)
一个经典现象:RR 级别下,事务 A 查出来的余额是 400,此时执行 update ... set balance = balance - 50,结果 balance 变成了 300 而不是 350。
原因是 update 是当前读,它读到的 balance 是其他事务已经提交的 350,用 350 - 50 = 300,而 A 之前 select 看到的是快照里的 400。数据一致性没有被破坏,只是「你看到的值」和「你计算时用的值」来自不同版本。这也是为什么要避免「先查再算再写」这种模式,而应该用 set x = x - 50 让数据库自己完成计算。
小结
MySQL 处理并发的完整图景:
| 手段 | 解决的问题 | 代价 |
|---|---|---|
| MVCC(ReadView + undo 版本链) | 读写互不阻塞,解决不可重复读 | 需要维护版本链,undo 空间 |
| 行锁 + 索引 | 写写互斥,粒度最小 | 无索引会退化为表锁 |
| 间隙锁 / 临键锁 | 解决幻读 | 更容易死锁,锁范围不易预测 |
| 意向锁 | 提升加表锁时的检查效率 | 无(自动管理) |
| 隔离级别 | 整体上权衡隔离性与并发性 | 级别越高并发越低 |
核心结论:别让查询走不上索引,这是行锁退化成表锁的唯一原因,也是生产事故最常见的来源。读多写少的场景靠 MVCC 撑住,写冲突靠合理的事务边界和一致的加锁顺序来规避。
Redis 是如何处理并发问题的?
Redis 处理并发的方式,和 MySQL、和 JVM 都不一样。它的出发点是:既然并发这么难,那干脆不让它并发。
Redis 是单线程吗?
这个问题要分两半回答。
Redis 的单线程,指的是网络 IO 和键值对读写由一个线程完成——这也是 Redis 对外提供键值存储服务的主要流程。你执行的所有命令,不管是 GET 还是 INCR,都在同一个线程里排队执行。
但 Redis 不只有一个线程。持久化、异步删除(UNLINK)、集群数据同步这些功能,都是由额外的线程执行的。Redis 6.0 之后还引入了多线程 IO,用多个线程来处理网络数据的读写和协议解析——但命令的执行依然是单线程。
这个区分很关键:多线程只分担了「收包发包」的工作,真正改数据的那一步还是单线程串行。
单线程为什么还能这么快
既然只有一个线程处理命令,为什么 Redis 能跑到十万级 QPS?
三个原因:
- 数据在内存里。所有运算都是内存级别的,没有磁盘 IO 的等待,单次操作通常在纳秒到微秒级
- 单线程避免了多线程的切换损耗,也避免了锁竞争——没有并发,就没有并发问题
- IO 多路复用。单线程要处理几万个客户端连接,靠的是
epoll
第三点值得展开。如果用「一个连接一个线程」的模型,几万连接就要几万个线程,光线程本身的开销就撑不住。Redis 的做法是把「等待」这件事从线程里剥离出去:
客户端连接 → epoll 监听所有 socket
              ↓
         有事件就绪的连接进入队列
              ↓
         文件事件分派器
              ↓
分发给对应的事件处理器(读/写/连接)线程只在真的有数据可读或可写的时候才去处理,其余时间不做任何等待。这就是「IO 多路复用」——一个线程同时监听多个连接。
单线程的代价
既然只有一个线程执行命令,任何一条慢命令都会阻塞所有其他客户端。
最典型的反例是 keys:
# 危险:全量遍历所有键,数据量大时直接卡死
keys *
keys 会遍历整个键空间,期间其他命令全部排队等待。生产环境应该用 scan:
# 渐进式遍历,每次只扫一部分
SCAN cursor [MATCH pattern] [COUNT count]
scan 有三个参数:cursor 是游标(哈希桶的索引值),第二个是 key 的正则模式,第三个是一次遍历的 key 数量(只是参考值,底层实际遍历数量不一定,也不是返回结果数量)。第一次遍历 cursor 传 0,返回结果里的第一个整数作为下一次的 cursor,直到返回的 cursor 为 0 表示遍历结束。
但 scan 并不是完美的:如果在遍历过程中有键被增删改,可能出现「新增的键没遍历到」或者「重复遍历出同一个键」。它不保证完整遍历所有键,这是使用时必须知道的。
所以单线程模型下的第一条纪律是:不要在 Redis 上跑耗时命令。除了 keys,还要警惕大 key 的 del(用 UNLINK 异步删除)、大集合的 SMEMBERS、以及复杂度是 O(N) 的 ZRANGE 之类。
单线程下的原子性
单线程串行执行带来的最大红利是:每条命令天然是原子的。
因为不存在两个命令同时执行,一条命令执行期间不可能被打断。这直接解决了很多在 Java 里需要 synchronized 或 CAS 才能解决的问题:
INCR counter        # 天然原子,不需要任何锁
SETNX lock_key val  # 「不存在才设置」,本身就是原子的
这也是分布式锁能基于 Redis 实现的前提——SET key value NX PX 30000 这条命令在 Redis 内部是原子执行的,多个客户端同时发过来,只有一个能成功。
不过要注意,单条命令原子,不代表多条命令原子。下面这段逻辑就不是原子的:
GET stock          # 读到 10
-- 这里可能被其他客户端插进来
SET stock 9        # 写回 9
两个客户端同时读到 10,都写回 9,本应减 2 却只减了 1。解决这类「读-改-写」问题有三种方式,下面依次说。
用 Lua 脚本保证多命令原子性
Redis 支持执行 Lua 脚本,整个脚本在执行期间是原子性的——不会被其他命令打断。
所以把「读取 + 判断 + 写入」写进一段脚本,就等于一次原子操作:
-- 扣库存:检查够不够,够了才扣
local stock = tonumber(redis.call('get', KEYS[1]))
if stock >= tonumber(ARGV[1]) then
    redis.call('decrby', KEYS[1], ARGV[1])
    return 1
else
    return 0
end
这是 Redis 处理「复合操作」最常用的手段。前面讲分布式锁时用来保证「校验持有者 + 删除锁」原子性的,正是这个机制。
有一点要清楚:Lua 脚本的原子性和事务的原子性含义不同——它保证的是不被其他命令插入,但不保证「出错就全部回滚」。脚本执行到一半报错,前面已经执行的命令不会撤销。
用事务保证命令批量执行
Redis 提供了简单的事务功能:把一组命令放在 MULTI 和 EXEC 之间。
MULTI              # 事务开始
SADD u:a:follow ub # 返回 QUEUED,只是入队,还没执行
SADD u:b:fans ua   # 返回 QUEUED
EXEC               # 事务结束,两条命令按顺序原子执行
MULTI 之后的命令不会立即执行,而是缓存在服务器的一个队列里,返回 QUEUED。直到 EXEC 才一次性按顺序执行。如果想放弃,用 DISCARD 代替 EXEC——注意它只是丢掉队列里未执行的命令,不会回滚已经操作过的数据。
出错时怎么办
Redis 对事务中不同阶段的错误处理机制不同:
命令错误(语法错误):比如把 set 写成 sett。这种错误在入队时就会被发现,整个事务直接无法执行(EXEC 返回错误),所有命令都不会生效。
运行时错误:比如对一个集合键误用了有序集合的 ZADD——语法是合法的,只有真正执行时才发现类型不对。这种情况下,其他命令照常执行成功,只有出错的那条失败。
也就是说:Redis 事务不支持回滚。已经执行的命令不会撤销,需要开发人员自己去修复数据。这是 Redis 事务和关系型数据库事务最本质的区别,也是它被称为「简单事务」的原因——它不支持回滚,也无法实现命令之间的逻辑关系计算,体现了 Redis 的「keep it simple」的设计取向。
WATCH:乐观锁
如果需要「事务执行前确保 key 没被其他客户端改过」,用 WATCH:
WATCH stock          # 监视这个 key
MULTI
DECR stock
EXEC                 # 如果 WATCH 后 key 被改过,这里返回 nil(事务不执行)
如果 WATCH 之后、EXEC 之前有其他客户端改了被监视的 key,那么 EXEC 会返回 nil,事务整体不执行。这就是乐观锁的思路——先监视,提交时发现被改过就放弃重试。
这也是 Redis 里表达 CAS 语义的标准方式。
Pipeline 和事务不是一回事
这两者经常被混淆,但它们解决的是完全不同的问题:
| Pipeline | 事务 | |
|---|---|---|
| 实现在哪 | 客户端行为 | 服务端行为 |
| 目的 | 提升吞吐能力,减少网络往返 | 保证命令批量原子执行 |
| 是否原子 | 不一定 | 是(不支持回滚的原子) |
Pipeline 的原理是把多条命令一次性发给服务器,把多次网络 IO 缩减为一次,服务器甚至无法区分这是 Pipeline 还是普通命令。它只是减少网络开销,不提供任何原子性保证。
而且 Pipeline 的原子性还有个陷阱:当提交的数据量较小、能被内核缓冲区容纳时,这些命令看起来是原子执行的;但一旦数据量超过内核缓冲区接收大小,执行就会被打断,原子性荡然无存。
所以 Pipeline 是吞吐优化手段,不是并发控制手段。想保证原子性还是得用事务或 Lua 脚本。两者也可以结合使用——用 Pipeline 发送事务命令,既减少网络往返又保证原子性。
缓存与数据库的双写一致性
Redis 在真实系统里最常扮演的角色是缓存。而一旦有了缓存,就有了一个绕不开的并发问题:数据同时存在数据库和缓存两份,写的时候先写谁?
两种不一致场景
双写不一致:更新数据库后删缓存,但删除失败或延迟,导致缓存里是旧值。
读写并发不一致:一个线程读数据库(拿到旧值),另一个线程更新数据库并删除缓存,然后前一个线程把旧值写回缓存——缓存里留下了旧值。
时刻   线程 A(读)              线程 B(写)            缓存      数据库
T1     读数据库 → 100                                       100
T2                              更新数据库 → 200            100     200
T3                              删除缓存                    空      200
T4     把 100 写入缓存                                    100     200   ← 不一致
解决方案
按业务对一致性的要求分层次处理:
1. 一致性要求不高(个人维度的订单、用户数据这类并发几率小的):加过期时间就行。每隔一段时间触发读的主动更新,不一致窗口很小,可以接受。
2. 并发高但能容忍短暂不一致(商品名称、分类菜单):缓存加过期时间依然能解决大部分业务需求。这是最经济的选择。
3. 不能容忍不一致:用分布式读写锁保证并发读写或写写时按顺序排队,而读读之间相当于无锁。代价是引入了锁的开销和复杂度。
4. 想彻底解耦:用阿里开源的 Canal 监听数据库 binlog,数据变更时及时去修改缓存。代价是引入新中间件,增加了系统复杂度。
一条重要的判断
这里有一句话值得记住:
不要为了用缓存,同时又要保证绝对的一致性,去做大量的过度设计和控制。
缓存的前提是「读多写少」且「数据实时性要求不高」。如果业务是写多读多、又不能容忍不一致,那么加缓存本身就是个错误的决定——应该直接操作数据库。如果数据库扛不住,可以把缓存作为主存储、异步同步到数据库。
用过期时间 + 合理的更新策略能覆盖绝大多数场景,剩下那部分「必须强一致」的需求,往往该用别的手段(比如直接查库)而不是把缓存改造成一个分布式事务系统。
小结
Redis 处理并发的思路,和前面讲的数据库、JVM 形成了一条对照:
| 层次 | 手段 | 本质 |
|---|---|---|
| JVM | CAS、synchronized、AQS | 多线程共享内存,靠原子指令和锁 |
| MySQL | MVCC、行锁、间隙锁 | 读写分离靠版本,写写互斥靠锁 |
| Redis | 单线程 | 消灭并发本身 |
Redis 的做法最省事:既然并发问题的根源是「多个执行流同时改同一份数据」,那就只留一个执行流。 单线程串行执行让每条命令天然原子,剩下的复合操作需求,再用 Lua 脚本和 MULTI/EXEC 补上。
代价也很明确:
- 一条慢命令会阻塞所有客户端,所以必须避开
keys这类操作,用scan替代 - 单机性能有上限,靠集群水平扩展(而集群又引入了跨节点操作、槽位定位这些新问题)
- 事务不支持回滚,用起来比关系型数据库的事务受限得多
理解了这个取舍,再看 Redis 的那些「怪癖」——为什么没有回滚、为什么会有 scan 这种不保证完整性的遍历、为什么大 key 是禁忌——就都是同一个设计选择带来的必然结果。